




¿Por qué el Agente de Usuario de tu navegador sigue siendo bloqueado?

Aloísio Vítor
How to use CapSolver
04-Jun-2026
TL;DR
- Un agente de navegador sigue siendo bloqueado cuando su tráfico parece automatizado para los sistemas de control de riesgo, los cuales luego presentan CAPTCHAs, límites de velocidad o bloques duros.
- Las causas principales son la mala reputación de la IP, huellas dactilares de automatización filtradas, tiempos robóticos y sesiones sobrecargadas.
- Los puntajes de detección de bots combinan muchos señales, por lo que arreglar una y ignorar las demás aún te bloquea.
- Huellas dactilares realistas, IPs residenciales, ritmo similar al humano y un camino de tokens CAPTCHA juntos mantienen al agente en funcionamiento.
- Un servicio de resolución como CapSolver devuelve tokens para desafíos que tu agente no puede resolver por sí mismo.
Introducción
Un agente de navegador sigue siendo bloqueado porque los sistemas de detección deciden que la sesión es automatizada y la detienen antes de que alcance el contenido. La causa rara vez es un solo error. La detección de bots combina la reputación de la IP, la huella dactilar del navegador, el comportamiento y el ritmo de las solicitudes en una puntuación de riesgo única. Arreglar solo una señal y ignorar las demás aún te bloquea. Esta guía desglosa cada razón por la que un agente de navegador sigue siendo bloqueado, luego da soluciones concretas para huellas dactilares, proxies, ritmo y manejo de CAPTCHA. Un servicio de resolución como CapSolver cubre el paso del desafío cuando un sitio aún presenta uno. Aplica todo esto solo en sitios para los que tienes autorización para automatizar.
Cómo decide la detección de bots bloquearte
Los sistemas de detección bloquean por una puntuación combinada, no por una sola regla. Cuando un agente de navegador sigue siendo bloqueado, generalmente hay varias señales débiles acumuladas al mismo tiempo. Los sistemas modernos de control de riesgo evalúan la red, el navegador y el comportamiento juntos, como se describe en la documentación de puntuación de bots de Cloudflare.
La puntuación se basa en tres capas:
- Capa de red. Tipo de IP, reputación y ASN.
- Capa del navegador. Encabezados, huella dactilar TLS, entorno JavaScript y marcadores de automatización.
- Capa de comportamiento. Tiempo de clics, orden de navegación y ritmo de solicitudes.
Cada capa agrega o reduce el riesgo. Una IP residencial con una huella dactilar perfecta aún puede ser bloqueada si solicita 200 páginas por minuto. Por eso un agente de navegador sigue siendo bloqueado incluso después de una solución parcial.
Razón 1: Las huellas dactilares de automatización se filtran
La razón más común por la que un agente de navegador sigue siendo bloqueado es una huella dactilar de automatización filtrada. Las configuraciones predeterminadas en modo sin cabeza exponen marcadores que los scripts de detección leen instantáneamente.
Indicios frecuentes:
- La bandera
navigator.webdriverestá establecida en true. - Un navegador sin cabeza informa sobre complementos faltantes, tamaños de pantalla inusuales o un agente de usuario de marcador.
- La huella dactilar TLS no coincide con el navegador que el agente afirma ser.
- Las señales de canvas, WebGL y fuentes parecen uniformes en cada ejecución.
Ajusta la huella dactilar antes que nada. Usa un contexto de navegador real, establece un agente de usuario consistente y realista y alinea las señales TLS y JavaScript con el navegador que presentas. Cuando la huella dactilar parece humana, un agente de navegador sigue siendo bloqueado con menos frecuencia. Una configuración de Playwright o Selenium con medidas de seguridad aplicadas es una base más sólida que un lanzamiento sin cabeza puro.
Razón 2: Mala reputación de la IP
La reputación de la IP decide una gran parte de la puntuación. Si un agente de navegador sigue siendo bloqueado desde la primera solicitud, la IP suele ser la causa.
Lo que afecta la reputación:
- Rangos de IP de centros de datos y nube, que los listas de detección marcan como propensos a automatización.
- Direcciones compartidas ya utilizadas por otros bots.
- Una sola IP que genera un volumen de solicitudes inusual.
Muevete a un proxy residencial o a un grupo de móviles para que el tráfico provenga de conexiones reales de consumidores. Gira las direcciones a un ritmo razonable en lugar de por solicitud, lo cual mismo parece robótico. Una buena reputación de IP no salvará una huella dactilar filtrada, pero una mala IP garantiza que un agente de navegador siga siendo bloqueado sin importar lo limpio que parezca el navegador.
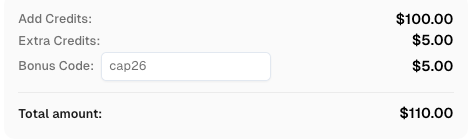
Redime tu código de bono de CapSolver
Aumenta tu presupuesto de automatización instantáneamente!
Usa el código de bono CAP26 al recargar tu cuenta de CapSolver para obtener un 5% adicional en cada recarga — sin límites.
Redímelo ahora en tu Panel de CapSolver
Razón 3: Comportamiento y tiempos robóticos
El comportamiento es la capa que la mayoría de los agentes ignoran. Un agente de navegador sigue siendo bloqueado cuando se mueve más rápido y uniformemente que cualquier humano podría hacerlo.
Patrones que activan las alertas:
- Intervalos idénticos entre cada acción.
- Navegación instantánea sin tiempo de lectura o renderizado.
- Caminos de cursor perfectamente lineales o sin eventos de puntero en absoluto.
- El mismo camino a través del sitio en cada ejecución.
Agrega variación. Inserta pequeños retrasos aleatorios, permite que las páginas se estabilicen y varía el orden de navegación donde sea posible. Las sesiones humanas son irregulares y los sistemas de detección esperan esa irregularidad. Los cambios en el ritmo son económicos y a menudo reducen drásticamente las tasas de bloqueo cuando un agente de navegador sigue siendo bloqueado a pesar de buenas IPs y huellas dactilares.
Razón 4: El sitio presenta un CAPTCHA
A veces la detección funciona como está diseñada y presenta un desafío. En ese momento, un agente de navegador sigue siendo bloqueado hasta que se resuelve el desafío. El agente no puede completar una tarea reCAPTCHA o Cloudflare Turnstile razonando sobre la página.
Manéjalo con un flujo de token:
- Detecta el desafío verificando marcadores conocidos de CAPTCHA en la página.
- Envía la clave del sitio y la URL de la página a un servicio de resolución.
- Recibe un token y lo inyectas en el campo que el sitio espera.
- Reenvía para que el sitio devuelva contenido real.
Usa solo patrones de tarea oficiales documentados para el servicio; no inventes parámetros. Para un ejemplo funcional dentro de un navegador real, consulta esta guía sobre resolución de CAPTCHA con Playwright. Cuando un desafío de Turnstile es el bloqueo, los pasos en este recorrido para un agente de IA atrapado en Cloudflare Turnstile se aplican directamente.
Resumen comparativo
| Causa del bloqueo | Señal principal | Solución principal | Aún bloqueado si lo omites |
|---|---|---|---|
| Huella dactilar filtrada | navigator.webdriver, desajuste TLS | Refuerza un contexto de navegador real | Soluciones de huella dactilar solas |
| Mala reputación de IP | ASN de centro de datos, IPs quemadas | Proxies residenciales o móviles | Soluciones de IP solas |
| Tiempos robóticos | Intervalos uniformes, sin tiempo de renderizado | Ritmo similar al humano | Soluciones de comportamiento solas |
| CAPTCHA difícil | reCAPTCHA o Turnstile mostrado | Flujo de resolución de token | Cualquier capa sola |
Conclusión
Un agente de navegador sigue siendo bloqueado porque la detección puntúa la red, el navegador y el comportamiento juntos. Arregla las cuatro capas: refuerza la huella dactilar, usa IPs residenciales, rige las acciones como un humano y agrega un flujo de token CAPTCHA para desafíos que aún aparezcan. Saltar cualquier capa individual es suficiente para mantener al agente marcado. Mantén este trabajo en sitios y datos para los que tienes autorización, ya que manejar un bloqueo nunca otorga permiso para recopilar información restringida. Cuando un desafío es la última barrera entre tu agente y datos limpios, CapSolver devuelve los tokens que tu automatización necesita.
Preguntas frecuentes
¿Por qué mi agente de navegador sigue siendo bloqueado incluso con un proxy residencial?
Una buena IP es solo una señal. Si la huella dactilar filtra marcadores de automatización o el tiempo es robótico, la detección aún bloquea la sesión. Arregla todas las capas juntas.
¿Cuál es el cambio más rápido que reduce los bloqueos?
Refuerzar la huella dactilar del navegador suele ayudar más, porque una bandera navigator.webdriver filtrada o una señal TLS desajustada es un indicador inmediato. Combínalo con mejores IPs y ritmo.
¿Cómo paso un CAPTCHA que mi agente no puede resolver?
Detecta el desafío, envía la clave del sitio y la URL de la página a un servicio de resolución, recibe un token, ingrésalo en el campo esperado y reenvía para cargar contenido real.
¿Correr un navegador real detiene todos los bloqueos?
No. Un contexto de navegador real ayuda con sitios puntuados por JavaScript, pero un CAPTCHA difícil, una mala IP o un tiempo robótico aún pueden bloquear al agente.
¿Es legal mantener a mi agente sin bloqueos?
Solo en sitios que posees o estás autorizado a automatizar. Evitar un bloqueo no autoriza la recopilación de datos privados, restringidos o no autorizados.
Aviso de Cumplimiento: La información proporcionada en este blog es solo para fines informativos. CapSolver se compromete a cumplir con todas las leyes y regulaciones aplicables. El uso de la red de CapSolver para actividades ilegales, fraudulentas o abusivas está estrictamente prohibido y será investigado. Nuestras soluciones para la resolución de captcha mejoran la experiencia del usuario mientras garantizan un 100% de cumplimiento al ayudar a resolver las dificultades de captcha durante el rastreo de datos públicos. Fomentamos el uso responsable de nuestros servicios. Para obtener más información, visite nuestros Términos de Servicio y Política de Privacidad.
Máse
SDK de Python de CapSolver vs API HTTP: ¿Cuál deberías usar?
Elija el SDK Core de Python de CapSolver o la API HTTP directa según el soporte para tareas, el acceso a la página, el manejo de respuestas y las responsabilidades que tu aplicación posee.
Aloísio Vítor
16-Sep-2026
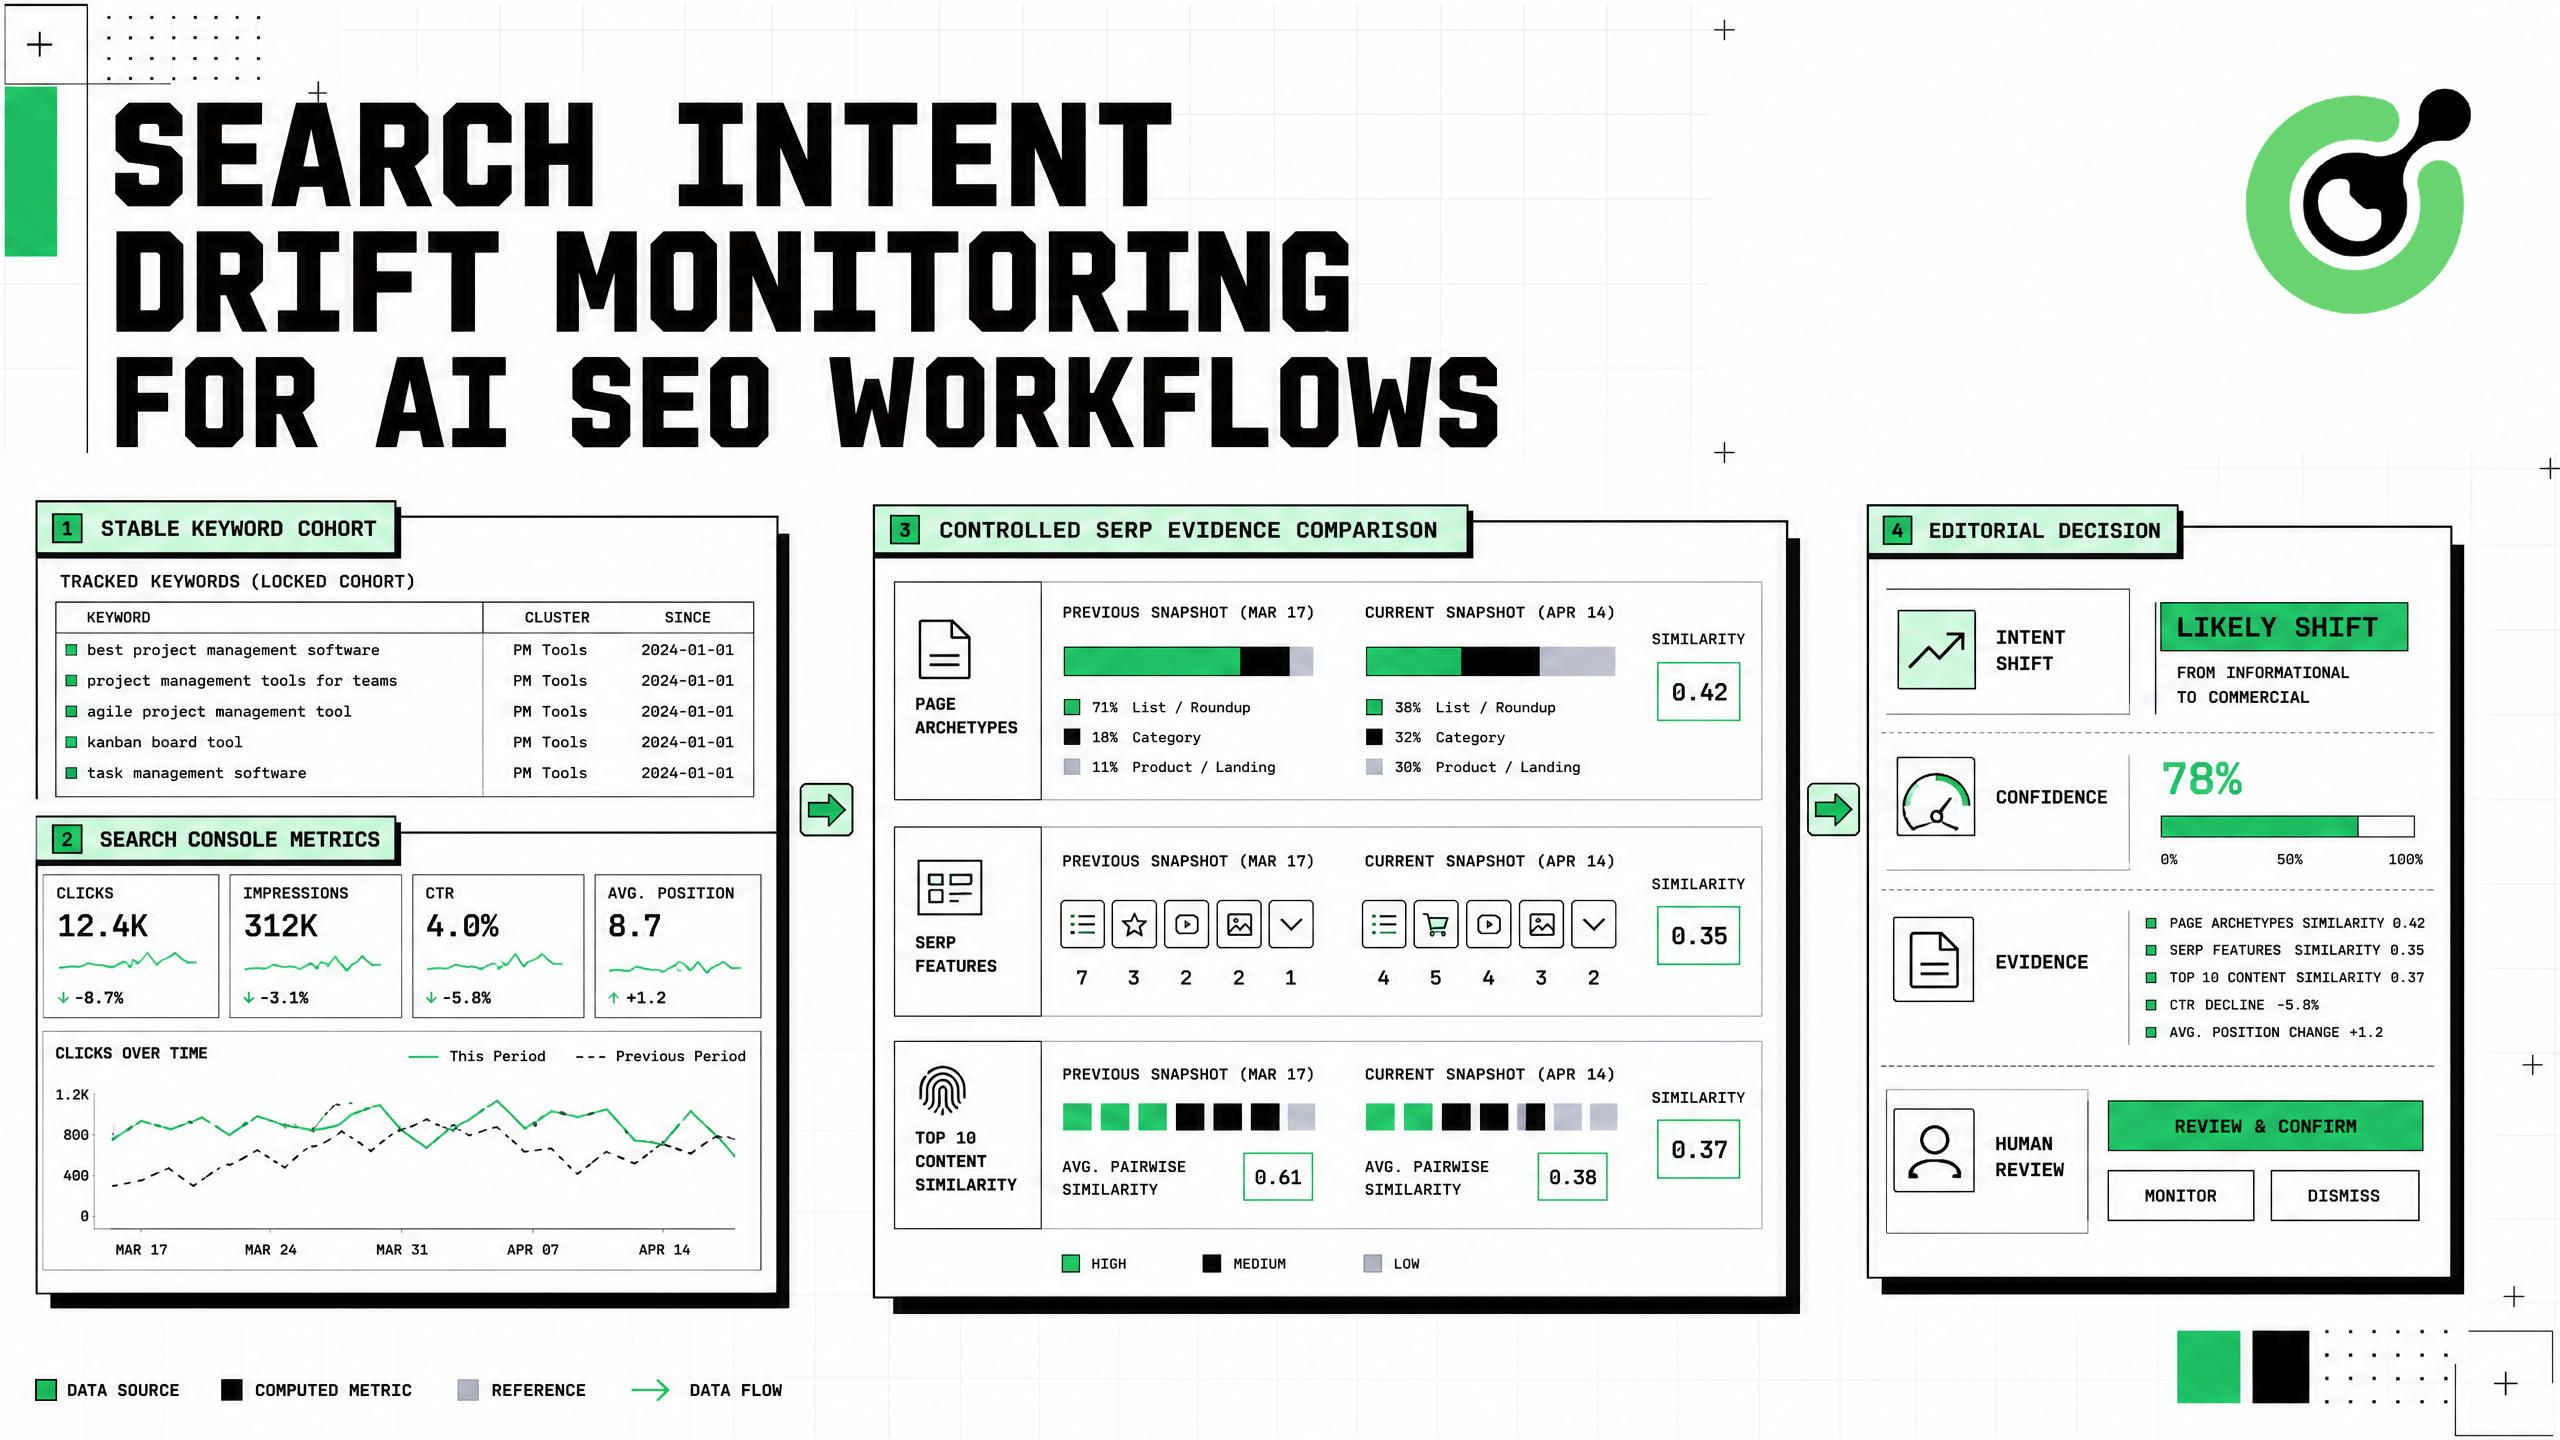
Monitoreo de desviación de intención de búsqueda para flujos de trabajo de SEO con IA
Construye un monitoreo de desviación de intención de búsqueda con datos de Google Search Console, observaciones controladas de los resultados de búsqueda (SERP), etiquetas de intención, umbrales de confianza, evidencia y automatización segura.
Aloísio Vítor
31-Aug-2026
Cómo agregar la resolución de CAPTCHA de Gumloop a flujos de trabajo web
Construye la resolución de CAPTCHA de Gumloop con un contrato HTTP verificado, una rama de recuperación controlada, un presupuesto de reintentos, verificaciones del estado del navegador y alternativa humana.
Aloísio Vítor
21-Aug-2026
Cómo agregar un solucionador de CAPTCHA a flujos de trabajo de automatización de formularios
Un solucionador de CAPTCHA de automatización de formularios es un componente de recuperación de errores para un flujo de trabajo de formulario permitido, no un atajo alrededor de la autorización. CapSolver puede proporcionar una solución de reCAPTCHA a través de la API de tarea documentada mientras que su aplicación preserva los datos de entrada, el contexto del navegador, el consentimiento y la regla de presentación final. La secuencia más segura es detectar, tomar una instantánea, crear una tarea, consultar con un plazo, aplicar el resultado en la misma sesión y verificar el estado de confirmación propio del formulario. Este artículo
Aloísio Vítor
13-Aug-2026
Cómo manejar CAPTCHA en flujos de trabajo de automatización RPA de manera segura
La automatización de CAPTCHA en RPA es confiable solo cuando el CAPTCHA se convierte en un estado explícito del flujo de trabajo. CapSolver puede proporcionar la capa de manejo de CAPTCHA a través de su extensión de navegador o API documentada, mientras que la plataforma RPA controla el alcance del proceso, credenciales, tiempos de espera y validación empresarial. Esto evita el fallo común donde un robot sigue haciendo clic después de que aparezca la verificación, pierde el estado del formulario o envía dos veces. Un diseño de producción pausa en la detección, espera un resultado limitado, ver
Aloísio Vítor
12-Aug-2026
Cómo manejar CAPTCHA en pruebas de QA automatizadas
Manejar CAPTCHA en pruebas de QA automatizadas con conjuntos de prueba controlados, integración del navegador de CapSolver, intentos limitados y aserciones confiables.
Aloísio Vítor
11-Aug-2026