




Monitoreo de desviación de intención de búsqueda para flujos de trabajo de SEO con IA

Aloísio Vítor
How to use CapSolver
31-Aug-2026
TL;DR
- El monitoreo de desviación de intención de búsqueda compara cohortes de consultas estables a lo largo del tiempo; no infiere la intención a partir de un solo resultado de clasificación o una respuesta de modelo.
- Utiliza los datos de Google Search Console propios para clics, impresiones y posición, y luego agrega observaciones controladas del SERP desde una API aprobada o una exportación proporcionada por el usuario.
- Etiqueta la intención a partir de múltiples señales: tipos de resultados, arquetipos dominantes de páginas, características del SERP, modificadores y comportamiento de consulta a página.
- Requiere umbrales de persistencia, cobertura y confianza antes de cambiar contenido o enlaces internos.
- Mantén las recomendaciones automatizadas separadas de las decisiones de publicación y conserva evidencia para cada alerta de cambio de intención.
Introducción
El monitoreo de desviación de intención de búsqueda detecta cuándo el conjunto de resultados y el comportamiento del usuario alrededor de una consulta cambian lo suficiente como para que una página existente ya no satisfaga la necesidad dominante. Un sistema confiable no pide a un modelo de IA que adivine a partir de una sola página de búsqueda. Combina tendencias de Search Console propias, instantáneas controladas del SERP, arquetipos de páginas, cambios en características y modificadores de consulta, y aplica reglas de persistencia y confianza antes de alertar a un equipo de SEO. Este enfoque es especialmente útil para guías permanentes, páginas programáticas, contenido de comparación, categorías de productos y temas que cambian rápidamente. Esta guía explica el modelo de evidencia, cohortes de consulta, ingesta de Search Console, recolección de SERP aprobada, taxonomía de intención, métricas de similitud, puntuación de confianza, confirmación de cambios, herramientas seguras para agentes, pruebas de calidad y automatización responsable.
Definir con precisión la desviación de intención de búsqueda
La desviación de intención de búsqueda es un cambio sostenido en la tarea dominante implícita por el entorno de resultados y el comportamiento del usuario para una cohorte de consultas estable. Ejemplos incluyen:
- Resultados informativos que ceden el paso a páginas de categorías de productos;
- Revisión de productos que ceden el paso a páginas de productos de primera parte;
- Resultados de noticias recientes que reemplazan a explicadores permanentes;
- Paquetes locales que se convierten en dominantes para una consulta anteriormente nacional;
- Resultados de video o foros que ocupan más del conjunto visible de resultados;
- Una consulta de marca que se convierte en navegacional en lugar de comparativa;
- Una página propia que recibe impresiones pero pierde clics después de que cambien las características del resultado.
La automatización del monitoreo de desviación de intención de búsqueda no debe etiquetar la volatilidad ordinaria de clasificación como cambio de intención. El rango, la presencia de características y la intención están relacionados pero son distintos.
El blog de automatización de CapSolver [https://www.capsolver.com/blog/automation] cubre flujos de trabajo de datos programados relacionados, mientras que la FAQ de scraping web de CapSolver [https://www.capsolver.com/faq/web-scraping] proporciona orientación para observaciones públicas permitidas.
Usar un modelo de evidencia de dos capas
El sistema más sólido combina el rendimiento propio y las observaciones controladas de resultados.
| Capa de evidencia | Ejemplos | Qué puede mostrar | Limitación principal |
|---|---|---|---|
| Rendimiento propio | Impresiones, clics, CTR, posición, página, dispositivo, país | Cómo los usuarios llegan a páginas propias | No muestra el conjunto completo de resultados |
| Observación del SERP controlado | Tipos de resultados, URLs, títulos, características, arquetipos de páginas | Cómo se ve el entorno de búsqueda | La cobertura y la localización dependen del método de recolección |
| Inventario de contenido | Tipo de página, plantilla, frescura, esquema, entidades de tema | Lo que ofrece actualmente el sitio | No demuestra la demanda actual |
| Revisión humana | Significado de la consulta, contexto comercial, riesgo | Interpretación final | Más lento y con capacidad limitada |
Google's Visión general de Search Console indica que los informes de Analytics de búsqueda muestran consultas, impresiones, clics y posición para sitios propios. úsalo como una señal propia, no como un conjunto completo de competidores.
Crear cohortes de consultas estables
No monitorees palabras clave aisladas sin contexto. Agrupa las consultas por una pregunta de negocio estable y preserva la consulta original.
python
from dataclasses import dataclass

@dataclass(frozen=True)
class QueryCohort:
    cohort_id: str
    market: str
    language: str
    device: str
    canonical_topic: str
    queries: tuple[str, ...]
    owned_page_group: tuple[str, ...]
    business_purpose: str
Ejemplos:
python
cohort = QueryCohort(
    cohort_id="captcha-api-comparison-us-en-desktop",
    market="US",
    language="en",
    device="DESKTOP",
    canonical_topic="captcha api comparison",
    queries=(
        "captcha api comparison",
        "compare captcha solving api",
        "captcha service comparison",
    ),
    owned_page_group=("/products/", "/blog/ai/"),
    business_purpose="content planning",
)
Mantén fijos market, language y device en comparaciones en series temporales.
Extraer datos de Search Console propios
Google's Documentación de la API de Analytics de búsqueda indica que el método de consulta requiere un rango de fechas, admite filtros y dimensiones de agrupamiento, y puede devolver las primeras filas en lugar de todas las filas. Almacena notas de cobertura con cada extracción.
python
from googleapiclient.discovery import build
from google.oauth2 import service_account

SCOPES = ["https://www.googleapis.com/auth/webmasters.readonly"]

credentials = service_account.Credentials.from_service_account_file(
    "search-console-reader.json",
    scopes=SCOPES,
)
service = build("searchconsole", "v1", credentials=credentials)


def search_console_rows(
    site_url: str,
    start_date: str,
    end_date: str,
    row_limit: int = 25000,
) -> list[dict]:
    body = {
        "startDate": start_date,
        "endDate": end_date,
        "dimensions": ["query", "page", "country", "device"],
        "rowLimit": row_limit,
        "dataState": "final",
    }
    response = service.searchanalytics().query(
        siteUrl=site_url,
        body=body,
    ).execute()
    return response.get("rows", [])
Mantén las credenciales en modo de solo lectura y fuera de cuadernos o prompts.
Normalizar observaciones de Search Console
python
from dataclasses import dataclass

@dataclass
class SearchPerformance:
    query: str
    page: str
    country: str
    device: str
    clicks: float
    impressions: float
    ctr: float
    position: float
    start_date: str
    end_date: str
    extraction_id: str
    coverage_note: str


def normalize_sc_row(row: dict, start_date: str, end_date: str, run_id: str):
    keys = row.get("keys") or []
    if len(keys) != 4:
        raise ValueError("Dimensiones inesperadas de Search Console")

    return SearchPerformance(
        query=keys[0],
        page=keys[1],
        country=keys[2],
        device=keys[3],
        clicks=float(row.get("clicks", 0)),
        impressions=float(row.get("impressions", 0)),
        ctr=float(row.get("ctr", 0)),
        position=float(row.get("position", 0)),
        start_date=start_date,
        end_date=end_date,
        extraction_id=run_id,
        coverage_note="La API puede priorizar las primeras filas; no garantiza exhaustividad",
    )
No trates las filas faltantes como demanda cero a menos que hayas confirmado el alcance de la extracción y la disponibilidad de datos.
El blog de IA de CapSolver [https://www.capsolver.com/blog/ai] proporciona ejemplos relacionados de alimentar evidencia estructurada en flujos de IA controlados.
Recopilar evidencia del SERP a través de un método aprobado
Usa una API del SERP licenciada, un conjunto de datos de socio o una exportación proporcionada por el usuario. Evita la recolección directa de motores de búsqueda cuando los términos de origen o el método de acceso no lo permitan.
python
from dataclasses import dataclass, field
from datetime import datetime, timezone

@dataclass
class SerpSnapshot:
    cohort_id: str
    query: str
    market: str
    language: str
    device: str
    source: str
    collection_id: str
    organic_results: list[dict]
    features: list[str]
    evidence_hash: str
    collected_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )
Para cada resultado, preserva:
- posición;
- URL y hostname;
- título y fragmento visible;
- tipo de resultado;
- arquetipo de página;
- fecha de publicación o actualización cuando se muestra;
- propiedad de características;
- referencia de evidencia.
Un desafío encontrado en una fuente de recolección aprobada debe ser canalizado como un evento de infraestructura. Nunca debe interpretarse como un resultado faltante o un cambio de intención.
La página de productos de CapSolver [https://www.capsolver.com/products] enumera las categorías de desafíos compatibles para flujos autorizados.
Definir una taxonomía de intención práctica
python
INTENT_LABELS = {
    "INFORMATIONAL_GUIDE",
    "TROUBLESHOOTING",
    "COMMERCIAL_COMPARISON",
    "TRANSACTIONAL_CATEGORY",
    "TRANSACTIONAL_PRODUCT",
    "NAVIGATIONAL_BRAND",
    "LOCAL_VISIT",
    "NEWS_FRESHNESS",
    "VIDEO_LEARNING",
    "COMMUNITY_DISCUSSION",
    "MIXED",
}
Usa etiquetas que se mapeen a decisiones de contenido. Evita docenas de categorías superpuestas que los revisores no puedan aplicar de manera consistente.
Clasificar arquetipos de página de forma determinista primero
python
from urllib.parse import urlparse


def classify_archetype(result: dict) -> str:
    url = result.get("url", "")
    title = result.get("title", "").lower()
    path = urlparse(url).path.lower()

    if any(part in path for part in ["/product/", "/products/"]):
        return "PRODUCT_OR_CATEGORY"
    if any(part in path for part in ["/compare", "/best-"]):
        return "COMPARISON"
    if any(word in title for word in ["how to", "guide", "tutorial"]):
        return "GUIDE"
    if any(part in path for part in ["/news/", "/press/"]):
        return "NEWS"
    if any(part in path for part in ["/forum/", "/community/"]):
        return "COMMUNITY"
    return "OTHER"
Usa un clasificador de IA solo para casos ambiguos. Envía texto de resultado mínimo, requiere etiquetas estructuradas y almacena la versión del modelo y la versión del prompt.
Construir un vector de características
python
from collections import Counter


def snapshot_features(snapshot: SerpSnapshot) -> dict:
    top_results = snapshot.organic_results[:10]
    archetypes = Counter(
        item.get("archetype", "OTHER") for item in top_results
    )
    hosts = {urlparse(item["url"]).hostname for item in top_results}

    return {
        "archetype_share": {
            key: value / max(len(top_results), 1)
            for key, value in archetypes.items()
        },
        "hosts": hosts,
        "features": set(snapshot.features),
        "top_urls": {item["url"] for item in top_results},
    }
Compara instantáneas solo cuando coincidan mercado, idioma, dispositivo, consulta y método de recolección.
Medir la similitud del conjunto de resultados
python
def jaccard(left: set, right: set) -> float:
    union = left | right
    if not union:
        return 1.0
    return len(left & right) / len(union)


def serp_change_metrics(previous: SerpSnapshot, current: SerpSnapshot) -> dict:
    old = snapshot_features(previous)
    new = snapshot_features(current)

    return {
        "url_similarity": jaccard(old["top_urls"], new["top_urls"]),
        "host_similarity": jaccard(old["hosts"], new["hosts"]),
        "feature_similarity": jaccard(old["features"], new["features"]),
        "previous_archetypes": old["archetype_share"],
        "current_archetypes": new["archetype_share"],
    }
Una baja similitud de URL sola puede reflejar volatilidad de clasificación. La evidencia de intención es más fuerte cuando también cambian los arquetipos de página y las características del resultado.
Detectar movimiento de arquetipos
python
def archetype_delta(previous: dict, current: dict) -> dict:
    labels = set(previous) | set(current)
    return {
        label: round(current.get(label, 0) - previous.get(label, 0), 3)
        for label in labels
    }


def dominant_archetype(shares: dict) -> str:
    if not shares:
        return "UNKNOWN"
    return max(shares.items(), key=lambda item: item[1])[0]
Por ejemplo, un cambio del 60% de páginas de guía al 60% de páginas de productos/categorías es más significativo que un intercambio entre URLs de guía.
Añadir comportamiento de Search Console
python
def performance_delta(previous: SearchPerformance, current: SearchPerformance):
    return {
        "impression_delta": current.impressions - previous.impressions,
        "click_delta": current.clicks - previous.clicks,
        "ctr_delta": current.ctr - previous.ctr,
        "position_delta": current.position - previous.position,
    }
Interpreta estas métricas con cuidado. Una disminución en el CTR puede deberse a pérdida de posición o a una nueva característica del SERP, no necesariamente a un cambio en la necesidad del usuario.
Puntuar la desviación de intención con múltiples señales
python
def intent_drift_score(metrics: dict, behavior: dict) -> dict:
    url_change = 1 - metrics["url_similarity"]
    host_change = 1 - metrics["host_similarity"]
    feature_change = 1 - metrics["feature_similarity"]

    old_dom = dominant_archetype(metrics["previous_archetypes"])
    new_dom = dominant_archetype(metrics["current_archetypes"])
    archetype_changed = float(old_dom != new_dom)

    score = (
        0.20 * url_change
        + 0.15 * host_change
        + 0.20 * feature_change
        + 0.35 * archetype_changed
        + 0.10 * min(abs(behavior["ctr_delta"]) * 5, 1)
    )

    return {
        "score": round(score, 3),
        "previous_dominant": old_dom,
        "current_dominant": new_dom,
        "archetype_changed": bool(archetype_changed),
    }
Trata los pesos como una hipótesis inicial. Ajusta los valores en casos históricos revisados en lugar de presentarlos como verdad universal.
Requerir persistencia
python
def confirmed_drift(windows: list[dict], minimum_score: float = 0.55):
    if len(windows) < 3:
        return False

    recent = windows[-3:]
    high = [item for item in recent if item["score"] >= minimum_score]
    labels = {
        item["current_dominant"]
        for item in recent
        if item["current_dominant"] != "UNKNOWN"
    }

    return len(high) >= 2 and len(labels) == 1
La automatización del monitoreo de desviación de intención de búsqueda debe requerir que el nuevo arquetipo dominante persista en múltiples instantáneas válidas. Aumenta la ventana para consultas de bajo volumen o estacionales.
Crear una alerta rica en evidencia
python
def build_drift_alert(cohort: QueryCohort, analysis: dict) -> dict:
    return {
        "event": "SEARCH_INTENT_DRIFT_CONFIRMED",
        "cohort_id": cohort.cohort_id,
        "topic": cohort.canonical_topic,
        "market": cohort.market,
        "device": cohort.device,
        "previous_intent": analysis["previous_dominant"],
        "current_intent": analysis["current_dominant"],
        "score": analysis["score"],
        "snapshot_ids": analysis["snapshot_ids"],
        "search_console_run_ids": analysis["search_console_run_ids"],
        "recommended_action": "human_content_review",
    }
La alerta debe apuntar a la evidencia, no publicar una reescritura automáticamente.
Separar eventos de intención de eventos de infraestructura
| Evento | Significado | Acción |
|---|---|---|
INTENT_DRIFT_CONFIRMED |
Cambio sostenido de arquetipo y características | Revisión por estratega de contenido |
RANK_VOLATILITY |
URLs cambiaron sin evidencia de intención | Continuar monitoreando |
FEATURE_SHIFT |
Cambio en la mezcla de características del SERP | Revisar impacto en CTR |
GSC_COVERAGE_LIMITED |
La extracción puede contener solo las filas superiores | Advertencia de cobertura de registros |
SNAPSHOT_MISSING |
La fuente aprobada no devolvió evidencia | Cola de operaciones de fuente |
CHALLENGE_ENCOUNTERED |
La fuente de colección presentó un desafío admitido | Manejo de infraestructura |
PARSER_UNKNOWN |
El formato de instantánea cambió | Cola de calidad de datos |
No etiquete los datos faltantes como desviación de intención.
La FAQ de errores de CapSolver ayuda a los equipos a normalizar fallas de fuentes y desafíos por separado de las señales de negocio.
Proporcione a un Agente de IA una Herramienta de Análisis Segura
python
from dataclasses import dataclass

@dataclass(frozen=True)
class AnalysisCase:
    case_id: str
    cohort_id: str
    approved_purpose: str
    snapshot_ids: tuple[str, ...]
    search_console_run_ids: tuple[str, ...]

CASES: dict[str, AnalysisCase] = {}

async def analyze_search_intent_case(case_id: str) -> dict:
    """Analizar un caso de intención de búsqueda pre-aprobado desde evidencia almacenada."""
    case = CASES.get(case_id)
    if case is None:
        raise PermissionError("Caso de análisis desconocido")

    result = analysis_service.compute(case)
    return {
        "case_id": case.case_id,
        "status": result.status,
        "previous_intent": result.previous_intent,
        "current_intent": result.current_intent,
        "confidence": result.confidence,
        "evidence_references": result.evidence_references,
        "review_required": True,
    }
El modelo recibe referencias de evidencia y resultados de análisis, no credenciales de Search Console, URLs sin restricciones, sesiones del navegador o exportaciones privadas sin procesar.
Asocie Cambios de Intención con Decisiones de Contenido
python
CONTENT_ACTIONS = {
    ("GUIDE", "COMPARISON"): "añadir criterios de decisión y tabla de comparación",
    ("GUIDE", "PRODUCT_OR_CATEGORY"): "revisar la adaptación de la página de categoría o producto",
    ("EVERGREEN", "NEWS"): "añadir flujo de trabajo de frescura o página complementaria de noticias",
    ("NATIONAL", "LOCAL"): "revisar página específica de ubicación y evidencia local",
    ("TEXT", "VIDEO"): "añadir video verificado o explicación visual",
}
Este mapeo genera prompts de revisión. No debe cambiar páginas de producción sin aprobación editorial.
Mida la Calidad del Programa
| Métrica | Definición | Comportamiento deseado |
|---|---|---|
| Tasa de validez de instantáneas | Instantáneas comparables divididas por instantáneas programadas | Alta y estable |
| Cobertura de cohorte | Consultas con evidencia GSC y SERP válida | Documentada por mercado/dispositivo |
| Acuerdo de revisor | Acuerdo humano sobre etiqueta de intención | Mejora con claridad de taxonomía |
| Precisión de alertas | Alertas confirmadas juzgadas como accionables | Alta antes de escalar volumen |
| Tasa de cambio falso | Alertas causadas por fallas de fuente/análisis | Cercana a cero |
| Tiempo de revisión | Tiempo de alerta a decisión | Dentro del SLA editorial |
| Completitud de evidencia | Alertas con IDs de instantánea y extracción requeridos | 100% |
La automatización de monitoreo de desviación de intención de búsqueda debe optimizar para alertas precisas y revisables en lugar de volumen máximo de alertas.
Código adicional: Use el código WEBS en Panel de CapSolver para obtener un 5% adicional en cada recarga.
Resumen de Comparación
| Enfoque | Calidad del contexto | Auditabilidad | Rol recomendado |
|---|---|---|---|
| Solo rastreador de clasificación | Baja para intención | Media | Señal de volatilidad |
| Solo Search Console | Comportamiento fuerte de propiedad | Alta | Capa de rendimiento de primera parte |
| Una instantánea SERP en vivo | Media | Media | Evidencia diagnóstica |
| SERP persistente más evidencia GSC | Alta | Alta | Monitoreo de cambio de intención |
| Opinión de modelo sin evidencia almacenada | Baja | Baja | Evitar |
El enfoque combinado hace que el monitoreo de desviación de intención de búsqueda sea comprensible para equipos de SEO, contenido, datos y cumplimiento.
Lista de Verificación de Producción
- Definir cohortes de consultas estables por mercado, idioma, dispositivo y tema.
- Usar credenciales de Search Console de solo lectura.
- Registrar límites de cobertura de API y IDs de extracción.
- Recopilar observaciones SERP a través de un método aprobado.
- Almacenar tipos de resultado, URLs, características, arquetipos y hashes de evidencia.
- Comparar solo instantáneas equivalentes.
- Requerir múltiples señales de intención y persistencia.
- Separar fallas de fuente de eventos de intención.
- Enviar cada recomendación de contenido a revisión humana.
- Recalibrar umbrales contra casos históricos revisados.
El blog de web scraping de CapSolver ofrece guía relacionada sobre pipelines de datos, y el glosario de CapSolver puede ayudar a estandarizar terminología de desafíos y automatización.
Uso Responsable
Use solo propiedades de Search Console para las que tenga autorización y fuentes de datos SERP cuyas condiciones permitan el monitoreo previsto. Minimice datos personales y de cuenta, use credenciales de solo lectura y respete límites de frecuencia. No trate clasificaciones o intención inferida como prueba sobre un individuo. Mantenga cambios de contenido automatizados, redirecciones, eliminaciones y decisiones de publicación detrás de aprobación editorial.
Conclusión
El monitoreo de desviación de intención de búsqueda funciona cuando combina rendimiento propio, instantáneas de resultados controladas, arquetipos de página, características SERP, evidencia persistente y revisión humana. Search Console muestra cómo los usuarios llegan a páginas propias; observaciones SERP aprobadas muestran cómo cambia el entorno de resultados; puntajes deterministas identifican candidatos; los revisores deciden la respuesta de contenido.
Construya un flujo de trabajo de monitoreo autorizado con CapSolver, comience con un conjunto pequeño de cohortes de consultas valiosas y valide cada alerta contra evidencia almacenada antes de escalar automatización.
Preguntas Frecuentes
¿Es lo mismo una caída en el rango que una desviación de intención de búsqueda?
No. Los rangos pueden cambiar mientras los tipos de página dominantes y la necesidad del usuario permanezcan estables. Confirme cambios de intención con arquetipos, características, evidencia del conjunto de resultados y comportamiento.
¿Puede Search Console mostrar la página completa de resultados?
No. Proporciona datos de rendimiento propio como consultas, clics, impresiones, CTR y posición. Añada observaciones SERP controladas para evidencia del entorno de resultados.
¿Cuántas instantáneas se necesitan antes de alertar?
Use múltiples instantáneas comparables y requiera persistencia. La ventana exacta depende del volumen de consultas, volatilidad, estacionalidad y riesgo empresarial.
¿Debería la IA reescribir automáticamente una página después de una alerta?
No. La IA puede resumir evidencia y sugerir opciones, pero un editor debe revisar la cohorte de consultas, conjunto de resultados, propósito empresarial y posibles efectos secundarios.
¿Qué hacer si una fuente de colección devuelve un desafío o página vacía?
Registre un evento de infraestructura y excluya esa instantánea del análisis de intención. Los datos de fuente faltantes o inválidos no son evidencia de cambio de intención.
Aviso de Cumplimiento: La información proporcionada en este blog es solo para fines informativos. CapSolver se compromete a cumplir con todas las leyes y regulaciones aplicables. El uso de la red de CapSolver para actividades ilegales, fraudulentas o abusivas está estrictamente prohibido y será investigado. Nuestras soluciones para la resolución de captcha mejoran la experiencia del usuario mientras garantizan un 100% de cumplimiento al ayudar a resolver las dificultades de captcha durante el rastreo de datos públicos. Fomentamos el uso responsable de nuestros servicios. Para obtener más información, visite nuestros Términos de Servicio y Política de Privacidad.
Máse
SDK de Python de CapSolver vs API HTTP: ¿Cuál deberías usar?
Elija el SDK Core de Python de CapSolver o la API HTTP directa según el soporte para tareas, el acceso a la página, el manejo de respuestas y las responsabilidades que tu aplicación posee.
Aloísio Vítor
16-Sep-2026
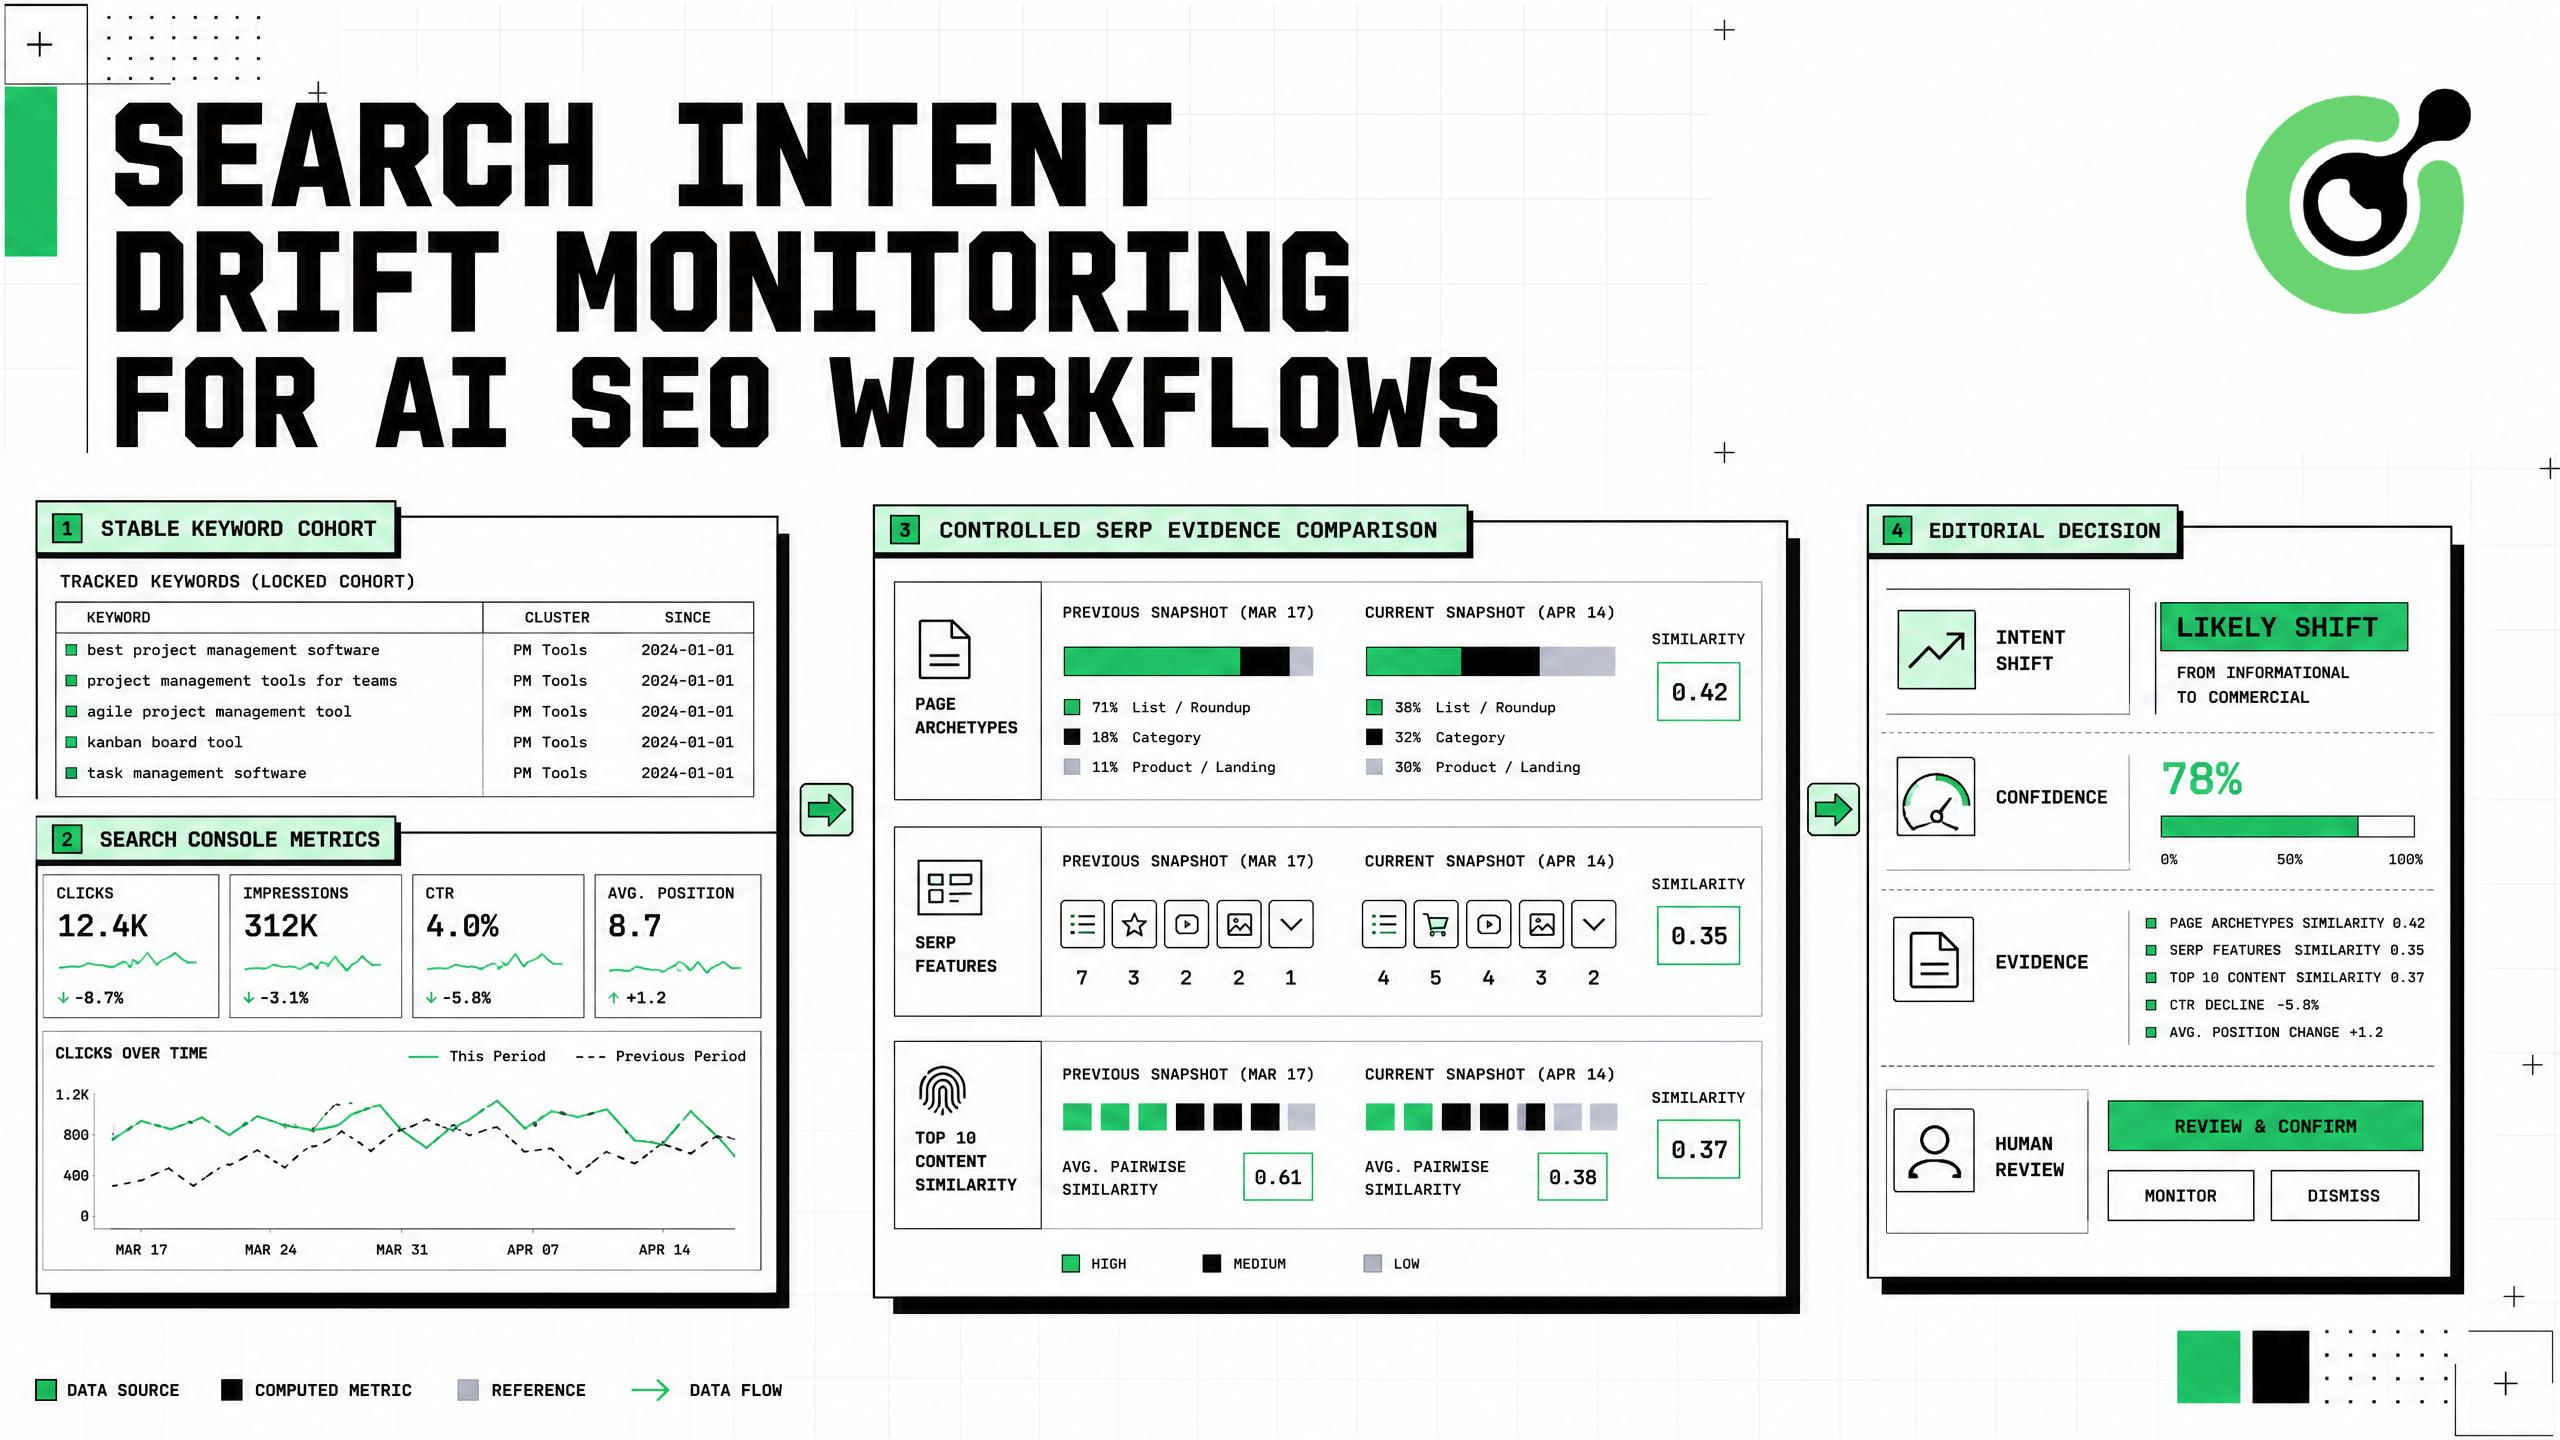
Monitoreo de desviación de intención de búsqueda para flujos de trabajo de SEO con IA
Construye un monitoreo de desviación de intención de búsqueda con datos de Google Search Console, observaciones controladas de los resultados de búsqueda (SERP), etiquetas de intención, umbrales de confianza, evidencia y automatización segura.
Aloísio Vítor
31-Aug-2026
Cómo agregar la resolución de CAPTCHA de Gumloop a flujos de trabajo web
Construye la resolución de CAPTCHA de Gumloop con un contrato HTTP verificado, una rama de recuperación controlada, un presupuesto de reintentos, verificaciones del estado del navegador y alternativa humana.
Aloísio Vítor
21-Aug-2026
Cómo agregar un solucionador de CAPTCHA a flujos de trabajo de automatización de formularios
Un solucionador de CAPTCHA de automatización de formularios es un componente de recuperación de errores para un flujo de trabajo de formulario permitido, no un atajo alrededor de la autorización. CapSolver puede proporcionar una solución de reCAPTCHA a través de la API de tarea documentada mientras que su aplicación preserva los datos de entrada, el contexto del navegador, el consentimiento y la regla de presentación final. La secuencia más segura es detectar, tomar una instantánea, crear una tarea, consultar con un plazo, aplicar el resultado en la misma sesión y verificar el estado de confirmación propio del formulario. Este artículo
Aloísio Vítor
13-Aug-2026
Cómo manejar CAPTCHA en flujos de trabajo de automatización RPA de manera segura
La automatización de CAPTCHA en RPA es confiable solo cuando el CAPTCHA se convierte en un estado explícito del flujo de trabajo. CapSolver puede proporcionar la capa de manejo de CAPTCHA a través de su extensión de navegador o API documentada, mientras que la plataforma RPA controla el alcance del proceso, credenciales, tiempos de espera y validación empresarial. Esto evita el fallo común donde un robot sigue haciendo clic después de que aparezca la verificación, pierde el estado del formulario o envía dos veces. Un diseño de producción pausa en la detección, espera un resultado limitado, ver
Aloísio Vítor
12-Aug-2026
Cómo manejar CAPTCHA en pruebas de QA automatizadas
Manejar CAPTCHA en pruebas de QA automatizadas con conjuntos de prueba controlados, integración del navegador de CapSolver, intentos limitados y aserciones confiables.
Aloísio Vítor
11-Aug-2026