




Diagnósticos del Desafío de Cloudflare: Identidad y Verificación de Sesión

Aloísio Vítor
How to use CapSolver
31-Aug-2026
TL;DR
- Primero distingue una página de desafío de Cloudflare de Turnstile, limitación de velocidad, autenticación, falla de red y error de aplicación.
- Usa la
AntiCloudflareTaskdocumentada con la URL exacta del objetivo y un proxy estático o pegajoso; mantén el agente de usuario de Chrome compatible. - Si se requiere HTML de la página de desafío, captúralo inmediatamente de la misma sesión aprobada en lugar de de una identidad de solicitud separada.
- Trata
cf_clearance, cookies, tokens, credenciales de proxy y HTML sin procesar como secretos de corta vida que no deben ingresar a registros o análisis. - Un resultado de tarea listo es solo un éxito intermedio. Verifica que la página objetivo cargó y que el desafío ya no está presente.
Introducción
Los diagnósticos de desafíos de Cloudflare deben comenzar con la clasificación del estado y la identidad de la sesión, no con la creación repetida de tareas. Una página protegida puede mostrar una página intersticial de desafío, un widget de Turnstile, una respuesta HTTP 429, un bloqueo duro, una pantalla de autenticación, un error de origen o una página de aplicación ordinaria. Cada estado requiere una acción diferente. Para una página de desafío compatible, CapSolver documenta AntiCloudflareTask con la URL exacta del objetivo, un proxy estático o pegajoso y un agente de usuario de Chrome compatible; algunos sitios también necesitan HTML de desafío fresco de la misma sesión. Los datos de clearance devueltos deben aplicarse a la misma identidad de solicitud y validarse contra la página objetivo esperada. Esta guía presenta una implementación genérica sin vincular el diseño a una industria, caso de uso o marco de agente.
Comience con la definición correcta del problema
Cloudflare describe Desafíos como mecanismos de seguridad que evalúan señales del navegador y del cliente y pueden solicitar interacción mínima del usuario. Esta categoría amplia no debe confundirse con cada respuesta bloqueada o incompleta.
Un flujo de diagnóstico debe responder cuatro preguntas en orden:
- ¿El objetivo está autorizado y dentro del alcance aprobado?
- ¿Qué página o estado de respuesta se observó realmente?
- ¿El estado coincide con un tipo de tarea de CapSolver compatible?
- ¿Cargó la página objetivo deseada después de la ejecución de la tarea?
El blog de Cloudflare de CapSolver contiene material de producto e implementación relacionado, mientras que la FAQ de resolución de CAPTCHA de CapSolver explica el ciclo de vida general de la tarea.
Distinga los principales estados de respuesta
| Estado | Evidencia típica | Acción correcta siguiente |
|---|---|---|
| Página esperada | Título conocido, ruta, selector semántico o esquema de respuesta | Analizar o continuar |
| Página de desafío de Cloudflare | "Solo un momento...", script de desafío, marcadores de Cloudflare | Verificar el alcance y considerar AntiCloudflareTask |
| Widget de Turnstile | Script de Turnstile, clave del sitio, contenedor de widget | Usar el camino de tarea documentado de Turnstile |
| Límite de velocidad | HTTP 429, Retry-After, respuesta de cuota |
Esperar y reducir la tasa de solicitud |
| Autenticación requerida | Formulario de inicio de sesión, 401, estado de sesión caducada | Autenticarse a través del flujo aprobado |
| Bloqueo duro | 403 persistente sin evidencia de desafío compatible | Detener y revisar la política de acceso o identidad de red |
| Error de origen o red | 5xx, DNS, TLS, timeout | Corregir la infraestructura; no crear una tarea de desafío |
| Página desconocida | Diseño o semántica que no coincide con estados conocidos | Almacenar diagnósticos redactados y solicitar revisión |
Un servicio de desafío nunca debe usarse como respuesta universal a cada 403 o página vacía.
Construya un clasificador de página determinista
python
from dataclasses import dataclass

@dataclass(frozen=True)
class HttpObservation:
    url: str
    status_code: int
    title: str
    html: str
    headers: dict[str, str]


def classify_observation(obs: HttpObservation) -> str:
    title = obs.title.lower()
    html = obs.html.lower()

    if obs.status_code == 429:
        return "LIMITACION_DE_VELOCIDAD"

    if obs.status_code >= 500:
        return "ERROR_DE_ORIGEN_O_RED"

    if "challenges.cloudflare.com/turnstile" in html:
        return "WIDGET_DE_TURNSTILE"

    challenge_markers = (
        "solo un momento" in title
        or "challenge-platform" in html
        or "cf-chl-" in html
    )
    if challenge_markers:
        return "PAGINA_DE_DESAFIO_DE_CLOUDFLARE"

    if 'type="password"' in html or obs.status_code == 401:
        return "AUTENTICACION_REQUERIDA"

    if obs.status_code == 200 and 'data-page="esperada"' in html:
        return "PAGINA_ESPERADA"

    if obs.status_code == 403:
        return "BLOQUEO_DURO"

    return "PAGINA_DESCONOCIDA"
Use marcadores de éxito específicos del objetivo. Un HTTP 200 genérico no es suficiente porque las páginas de desafío, error y consentimiento también pueden devolver 200.
La FAQ de errores de CapSolver es útil para mantener separados los errores del proveedor de los errores de estado de página.
Defina la tupla de identidad de sesión
La limpieza de Cloudflare está asociada al contexto del visitante y dispositivo. La documentación de clearance de Cloudflare indica que cf_clearance está vinculado a un visitante y dispositivo específicos y puede reevaluarse a medida que cambia el comportamiento de la sesión.
Represente explícitamente la identidad de la solicitud:
python
from dataclasses import dataclass

@dataclass(frozen=True)
class SessionIdentity:
    session_id: str
    proxy_profile: str
    chrome_user_agent: str
    tls_profile: str
    cookie_jar_id: str
    target_host: str
La tupla debe permanecer estable desde la observación inicial hasta la ejecución de la tarea y la verificación de la página objetivo.
Registre los objetivos aprobados en el lado del servidor
python
from dataclasses import dataclass
from urllib.parse import urlparse

@dataclass(frozen=True)
class TargetPolicy:
    target_id: str
    hostname: str
    allowed_path_prefixes: tuple[str, ...]
    purpose: str
    proxy_profile: str
    max_attempts: int = 1

TARGETS = {
    "docs_demo": TargetPolicy(
        target_id="docs_demo",
        hostname="approved.example.com",
        allowed_path_prefixes=("/public/", "/test/"),
        purpose="validación de integración autorizada",
        proxy_profile="approved_static_us",
    )
}


def resolve_target(target_id: str, url: str) -> TargetPolicy:
    policy = TARGETS.get(target_id)
    if policy is None:
        raise PermissionError("Objetivo desconocido")

    parsed = urlparse(url)
    if parsed.scheme != "https":
        raise PermissionError("Se requiere HTTPS")
    if parsed.hostname != policy.hostname:
        raise PermissionError("El host está fuera del alcance aprobado")
    if not any(parsed.path.startswith(p) for p in policy.allowed_path_prefixes):
        raise PermissionError("La ruta está fuera del alcance aprobado")
    return policy
No permita que un llamador no confiable proporcione una URL, proxy o propósito arbitrario.
Entienda el contrato de AntiCloudflareTask
La documentación de desafío de Cloudflare de CapSolver define AntiCloudflareTask.
| Campo | Requerido | Regla de diagnóstico |
|---|---|---|
type |
Sí | Debe ser AntiCloudflareTask |
websiteURL |
Sí | Página exacta aprobada |
proxy |
Sí | Proxy estático o pegajoso usado para la sesión |
userAgent |
Condicional | Mismo agente de usuario de Chrome compatible usado por el cliente |
html |
Condicional | HTML de desafío fresco de la misma sesión |
La documentación también exige una biblioteca de solicitudes con capacidad TLS y recomienda mantener la sesión de proxy durante al menos tres minutos.
La página de productos de CapSolver ayuda a distinguir las categorías de tareas de Cloudflare y Turnstile compatibles.
Construya la tarea desde datos de sesión confiables
python
import os
import capsolver

capsolver.api_key = os.environ["CAPSOLVER_API_KEY"]

PROXY_VAULT = {
    "approved_static_us": os.environ["APPROVED_STATIC_PROXY"],
}


def build_task(
    policy: TargetPolicy,
    identity: SessionIdentity,
    target_url: str,
    fresh_html: str | None,
) -> dict:
    if identity.proxy_profile != policy.proxy_profile:
        raise ValueError("El proxy de sesión no coincide con la política de objetivo")
    if identity.target_host != policy.hostname:
        raise ValueError("El host de sesión no coincide con la política de objetivo")

    task = {
        "type": "AntiCloudflareTask",
        "websiteURL": target_url,
        "proxy": PROXY_VAULT[identity.proxy_profile],
        "userAgent": identity.chrome_user_agent,
    }
    if fresh_html:
        task["html"] = fresh_html
    return task
El constructor de tareas lee credenciales de red de un depósito protegido. No devuelve las credenciales a un llamador ni las escribe en un registro.
Capture HTML de la misma sesión
Cuando se necesite HTML, cápturalo inmediatamente después de que el clasificador identifique el desafío.
python
from datetime import datetime, timezone

@dataclass(frozen=True)
class ChallengeDocument:
    session_id: str
    target_url: str
    body: str
    status_code: int
    captured_at: str

async def capture_challenge_document(client, identity, target_url):
    response = await client.get(
        target_url,
        session_id=identity.session_id,
        proxy_profile=identity.proxy_profile,
        user_agent=identity.chrome_user_agent,
        tls_profile=identity.tls_profile,
        cookie_jar_id=identity.cookie_jar_id,
    )
    observation = HttpObservation(
        url=str(response.url),
        status_code=response.status_code,
        title=extract_title(response.text),
        html=response.text,
        headers=dict(response.headers),
    )
    if classify_observation(observation) != "PAGINA_DE_DESAFIO_DE_CLOUDFLARE":
        raise ValueError("La respuesta no es una página de desafío reconocida")

    return ChallengeDocument(
        session_id=identity.session_id,
        target_url=target_url,
        body=response.text,
        status_code=response.status_code,
        captured_at=datetime.now(timezone.utc).isoformat(),
    )
No reutilices HTML capturado por otro proxy, agente de usuario, sesión o URL de objetivo.
Ejecute la tarea de CapSolver
python
def solve_approved_challenge(
    target_id: str,
    target_url: str,
    identity: SessionIdentity,
    document: ChallengeDocument,
) -> dict:
    policy = resolve_target(target_id, target_url)

    if document.session_id != identity.session_id:
        raise ValueError("El documento y la sesión no coinciden")
    if document.target_url != target_url:
        raise ValueError("El documento y la URL de objetivo no coinciden")

    task = build_task(
        policy=policy,
        identity=identity,
        target_url=target_url,
        fresh_html=document.body,
    )
    solution = capsolver.solve(task)

    cookies = solution.get("cookies") or {}
    clearance = cookies.get("cf_clearance") or solution.get("token")
    returned_user_agent = solution.get("userAgent") or identity.chrome_user_agent

    if not clearance:
        raise RuntimeError("El resultado de la tarea no contenía datos de clearance")

    return {
        "cookies": cookies,
        "user_agent": returned_user_agent,
    }
No imprima solution. Extraiga solo los campos necesarios para la siguiente solicitud.
Aplicar clearance al jar de cookies existente
python
async def apply_clearance(client, identity: SessionIdentity, result: dict):
    for name, value in result["cookies"].items():
        await client.set_cookie(
            cookie_jar_id=identity.cookie_jar_id,
            domain=identity.target_host,
            name=name,
            value=value,
            secure=True,
        )

    await client.set_user_agent(
        session_id=identity.session_id,
        user_agent=result["user_agent"],
    )
Use el host y el alcance de cookie exactos requeridos por el objetivo aprobado. No copie la cookie en dominios no relacionados o en otra máquina.
Verificar la página objetivo
python
@dataclass(frozen=True)
class VerificationRule:
    expected_status: int
    required_selectors: tuple[str, ...]
    forbidden_markers: tuple[str, ...]
    expected_path_prefix: str

async def verify_target_page(
    client,
    identity: SessionIdentity,
    target_url: str,
    rule: VerificationRule,
) -> dict:
    response = await client.get(
        target_url,
        session_id=identity.session_id,
        proxy_profile=identity.proxy_profile,
        user_agent=identity.chrome_user_agent,
        tls_profile=identity.tls_profile,
        cookie_jar_id=identity.cookie_jar_id,
    )

    parsed = urlparse(str(response.url))
    body = response.text.lower()

    status_ok = response.status_code == rule.expected_status
    path_ok = parsed.path.startswith(rule.expected_path_prefix)
    markers_ok = not any(marker.lower() in body for marker in rule.forbidden_markers)
    selectors_ok = all(selector_in_html(response.text, selector) for selector in rule.required_selectors)

    return {
        "verified": status_ok and path_ok and markers_ok and selectors_ok,
        "status_ok": status_ok,
        "path_ok": path_ok,
        "markers_ok": markers_ok,
        "selectors_ok": selectors_ok,
    }
Un resultado de tarea de CapSolver no es suficiente. La aplicación debe continuar solo después de que esta verificación devuelva verified=True.
Use una máquina de estados acotada
python
from enum import Enum

class FlowState(str, Enum):
    OBSERVED = "OBSERVED"
    CLASSIFIED = "CLASSIFIED"
    TASK_CREATED = "TASK_CREATED"
    RESULT_READY = "RESULT_READY"
    PAGE_VERIFIED = "PAGE_VERIFIED"
    STOPPED = "STOPPED"

ALLOWED = {
    FlowState.OBSERVED: {FlowState.CLASSIFIED, FlowState.STOPPED},
    FlowState.CLASSIFIED: {FlowState.TASK_CREATED, FlowState.STOPPED},
    FlowState.TASK_CREATED: {FlowState.RESULT_READY, FlowState.STOPPED},
    FlowState.RESULT_READY: {FlowState.PAGE_VERIFIED, FlowState.STOPPED},
    FlowState.PAGE_VERIFIED: {FlowState.STOPPED},
}


def transition(current: FlowState, next_state: FlowState) -> FlowState:
    if next_state not in ALLOWED[current]:
        raise ValueError(f"Transición inválida: {current} -> {next_state}")
    return next_state
Permita un intento de tarea por cada estado de página observado. Si la verificación falla, deténgase y solicite revisión en lugar de bucle.
Clasifique los errores antes de actuar
La documentación de códigos de error de CapSolver distingue errores de entrada, límite, timeout, proxy, cuenta, soporte y servicio temporal.
| Clase de error | Ejemplo | Acción |
|---|---|---|
| Entrada inválida | ERROR_INVALID_TASK_DATA |
Corregir la construcción de tarea confiable |
| Límite de velocidad | ERROR_RATE_LIMIT |
Esperar según la política |
| Timeout | ERROR_TASK_TIMEOUT |
Registrar el tiempo y detenerse o revisar |
| Tarea no compatible | ERROR_TASK_NOT_SUPPORTED |
Reclasificar el tipo de desafío |
| No resoluble | ERROR_CAPTCHA_UNSOLVABLE |
Detenerse y revisar el estado de la página |
| Proxy bloqueado | ERROR_PROXY_BANNED |
Revisar identidad de red aprobada |
| Cuenta/clave | ERROR_KEY_DENIED_ACCESS, ERROR_ZERO_BALANCE |
Corregir configuración de cuenta |
| Servicio temporal | ERROR_SERVICE_UNAVALIABLE |
Esperar y verificar estado del proveedor |
No aplicar la misma regla de reintento a todos los errores.
Normalizar errores en categorías estables
python
ERROR_ACTIONS = {
    "ERROR_INVALID_TASK_DATA": "FIX_INPUT",
    "ERROR_RATE_LIMIT": "WAIT",
    "ERROR_TASK_TIMEOUT": "REVIEW",
    "ERROR_TASK_NOT_SUPPORTED": "RECLASSIFY",
    "ERROR_CAPTCHA_UNSOLVABLE": "REVIEW",
    "ERROR_PROXY_BANNED": "REVIEW_NETWORK",
    "ERROR_KEY_DENIED_ACCESS": "FIX_ACCOUNT",
    "ERROR_ZERO_BALANCE": "FIX_ACCOUNT",
    "ERROR_SERVICE_UNAVALIABLE": "BACKOFF",
}


def normalize_error(error_code: str | None) -> dict:
    code = error_code or "UNKNOWN_ERROR"
    return {
        "category": code,
        "action": ERROR_ACTIONS.get(code, "OPERATOR_REVIEW"),
        "retry_allowed": ERROR_ACTIONS.get(code) in {"WAIT", "BACKOFF"},
    }
Un reintento debe permitirse solo por una política confiable y solo después de que haya cambiado la condición que lo provocó o haya transcurrido el período de espera.
Proteger materiales de sesión de corta duración
Trate los siguientes como secretos:
- Clave de API de CapSolver;
- credenciales de proxy;
cf_clearancey otras cookies;- token de desafío;
- agente de usuario completo cuando forma parte de una identidad de dispositivo;
- HTML de desafío sin procesar;
- estado de almacenamiento del navegador;
- URLs de destino sin restricciones que contengan identificadores.
python
SAFE_EVENT_FIELDS = {
    "event",
    "target_id",
    "state",
    "error_category",
    "attempt_count",
    "duration_ms",
    "verified",
    "observed_at",
}


def redact_event(event: dict) -> dict:
    return {
        key: event[key]
        for key in SAFE_EVENT_FIELDS
        if key in event
    }
Almacene un hash o referencia interna de evidencia sensible en lugar de colocar la evidencia misma en registros generales.
La Página de preguntas frecuentes de CapSolver proporciona orientación operativa adicional, y la Página de estado de CapSolver ayuda a distinguir entre fallos de aplicación y disponibilidad del proveedor.
Agregar observabilidad útil
python
from datetime import datetime, timezone
from time import monotonic


def diagnostic_event(
    target_id: str,
    state: str,
    attempt_count: int,
    verified: bool,
    started_at: float,
    error_category: str | None = None,
) -> dict:
    return redact_event({
        "event": "cloudflare_challenge_diagnostic",
        "target_id": target_id,
        "state": state,
        "attempt_count": attempt_count,
        "duration_ms": int((monotonic() - started_at) * 1000),
        "verified": verified,
        "error_category": error_category,
        "observed_at": datetime.now(timezone.utc).isoformat(),
    })
Seguir la tasa de desafíos, la tasa de tareas exitosas, la tasa de página verificada, la distribución de errores, el tiempo para estar listo y el volumen de revisiones por operador. No seguir secretos.
Probar la ruta de diagnóstico
python
import pytest

@pytest.mark.parametrize(
    "status,title,html,expected",
    [
        (429, "Límite de velocidad", "", "RATE_LIMIT"),
        (403, "Un momento por favor...", "cf-chl-test", "CLOUDFLARE_CHALLENGE"),
        (200, "Iniciar sesión", '<input type="password">', "AUTH_REQUIRED"),
        (500, "Error del servidor", "", "ORIGIN_OR_NETWORK_ERROR"),
    ],
)
def test_classifier(status, title, html, expected):
    observation = HttpObservation(
        url="https://approved.example.com/test/",
        status_code=status,
        title=title,
        html=html,
        headers={},
    )
    assert classify_observation(observation) == expected
También probar coincidencias de identidad incorrectas:
python
def test_task_rejects_proxy_profile_mismatch():
    policy = TARGETS["docs_demo"]
    identity = SessionIdentity(
        session_id="session-1",
        proxy_profile="wrong_profile",
        chrome_user_agent="Mozilla/5.0 ... Chrome/141.0.0.0 ...",
        tls_profile="chrome141",
        cookie_jar_id="jar-1",
        target_host="approved.example.com",
    )

    with pytest.raises(ValueError):
        build_task(
            policy=policy,
            identity=identity,
            target_url="https://approved.example.com/test/",
            fresh_html="<html>Un momento por favor...</html>",
        )
Finalmente, probar que la redacción excluya cookies, HTML, claves y valores de proxy.
Código adicional: Use el código WEBS en CapSolver Dashboard para obtener un 5% adicional en cada recarga.
Resumen de comparación
| Patrón | Consistencia de identidad | Claridad de diagnóstico | Recomendación |
|---|---|---|---|
| Reintento cada 403 | Baja | Baja | Evitar |
| Crear una tarea a partir de campos proporcionados por el usuario | Variable | Baja | Evitar |
| Clasificar, construir desde identidad confiable y luego verificar | Alta | Alta | Preferido |
| Detener y solicitar revisión manual | Alta | Alta | Requerido para estados desconocidos o sensibles |
El patrón preferido hace que cada decisión sea explícita y verificable.
Lista de verificación de producción
- Registrar el host aprobado, ruta, propósito y perfil de proxy del lado del servidor.
- Clasificar página esperada, desafío, Turnstile, límite de velocidad, autenticación, bloqueo duro y error de red por separado.
- Usar
AntiCloudflareTasksolo para una página de desafío reconocida y soportada. - Mantener el proxy estático o fijo, agente de usuario de Chrome soportado, perfil TLS y jar de cookies consistentes.
- Capturar HTML de desafío de la misma sesión cuando sea necesario.
- Mantener datos de clearance en almacenamiento de secretos de corta duración.
- Verificar la página de destino exacta después de aplicar datos de sesión.
- Permitir un intento de tarea por estado observado.
- Mapear códigos de error a acciones distintas.
- Registrar solo campos operativos redactados.
- Probar clasificación de página, coincidencia de identidad, validación de resultado y redacción de secretos.
La página de productos de CapSolver puede ayudar a confirmar las categorías de desafío soportadas antes de la implementación.
Uso responsable
Utilizar el manejo de desafíos de Cloudflare solo en sitios que posea, pruebe o tenga permiso explícito para acceder. Respetar términos, límites de velocidad, límites de autenticación, obligaciones de privacidad y políticas de origen. La capacidad de procesamiento de desafíos no otorga derechos de acceso. Detenerse cuando el objetivo sea desconocido, la página sea sensible, la identidad sea inconsistente o falle la verificación. Mantener acciones consecuentes detrás de una política separada y paso de aprobación humana.
Conclusión
Los diagnósticos de desafíos de Cloudflare deben ser un flujo estricto: autorizar el objetivo, clasificar la página observada, construir AntiCloudflareTask a partir de identidad de sesión confiable, mantener el proxy y el agente de usuario de Chrome soportado consistentes, aplicar material de clearance de corta duración al mismo jar de cookies y verificar la página deseada. Los errores deben categorizarse en lugar de reintentarse ciegamente, y los secretos nunca deben ingresar a registros o contexto de modelos.
Comience con una implementación aprobada en CapSolver, validéla en una página de prueba controlada y agregue pruebas de estado, identidad, verificación y redacción antes del uso en producción.
Preguntas frecuentes
¿Qué tipo de tarea de CapSolver maneja una página de desafío de Cloudflare?
Use la tarea documentada AntiCloudflareTask cuando la página observada coincida con un desafío de Cloudflare soportado y el objetivo esté autorizado.
¿Es necesario un proxy?
Sí. CapSolver documenta un proxy estático o fijo para esta tarea. Mantenga esa identidad de red consistente durante la verificación.
¿Cuándo debe incluirse el campo html?
Incluya HTML de desafío reciente cuando sea necesario para el objetivo. Capture el HTML con el mismo proxy fijo, agente de usuario de Chrome soportado, jar de cookies y URL de objetivo.
¿Es suficiente un resultado de tarea listo?
No. Aplicar los materiales de sesión devueltos al mismo identidad de solicitud y verificar que la página de destino esperada se cargue sin marcadores de desafío.
¿Qué debe hacerse después de un error desconocido o verificación fallida?
Detenerse, retener diagnósticos redactados y solicitar revisión por operador. No crear un bucle de reintento sin límites.
Aviso de Cumplimiento: La información proporcionada en este blog es solo para fines informativos. CapSolver se compromete a cumplir con todas las leyes y regulaciones aplicables. El uso de la red de CapSolver para actividades ilegales, fraudulentas o abusivas está estrictamente prohibido y será investigado. Nuestras soluciones para la resolución de captcha mejoran la experiencia del usuario mientras garantizan un 100% de cumplimiento al ayudar a resolver las dificultades de captcha durante el rastreo de datos públicos. Fomentamos el uso responsable de nuestros servicios. Para obtener más información, visite nuestros Términos de Servicio y Política de Privacidad.
Máse
Lista de verificación de la API de solucionador de Turnstile: Entradas, tokens y validación
Evalúe una API de resolución de Turnstile según sus entradas documentadas, respuesta de token, límite de validación y casos de prueba controlados antes de agregarla a su flujo de trabajo.
Aloísio Vítor
16-Sep-2026
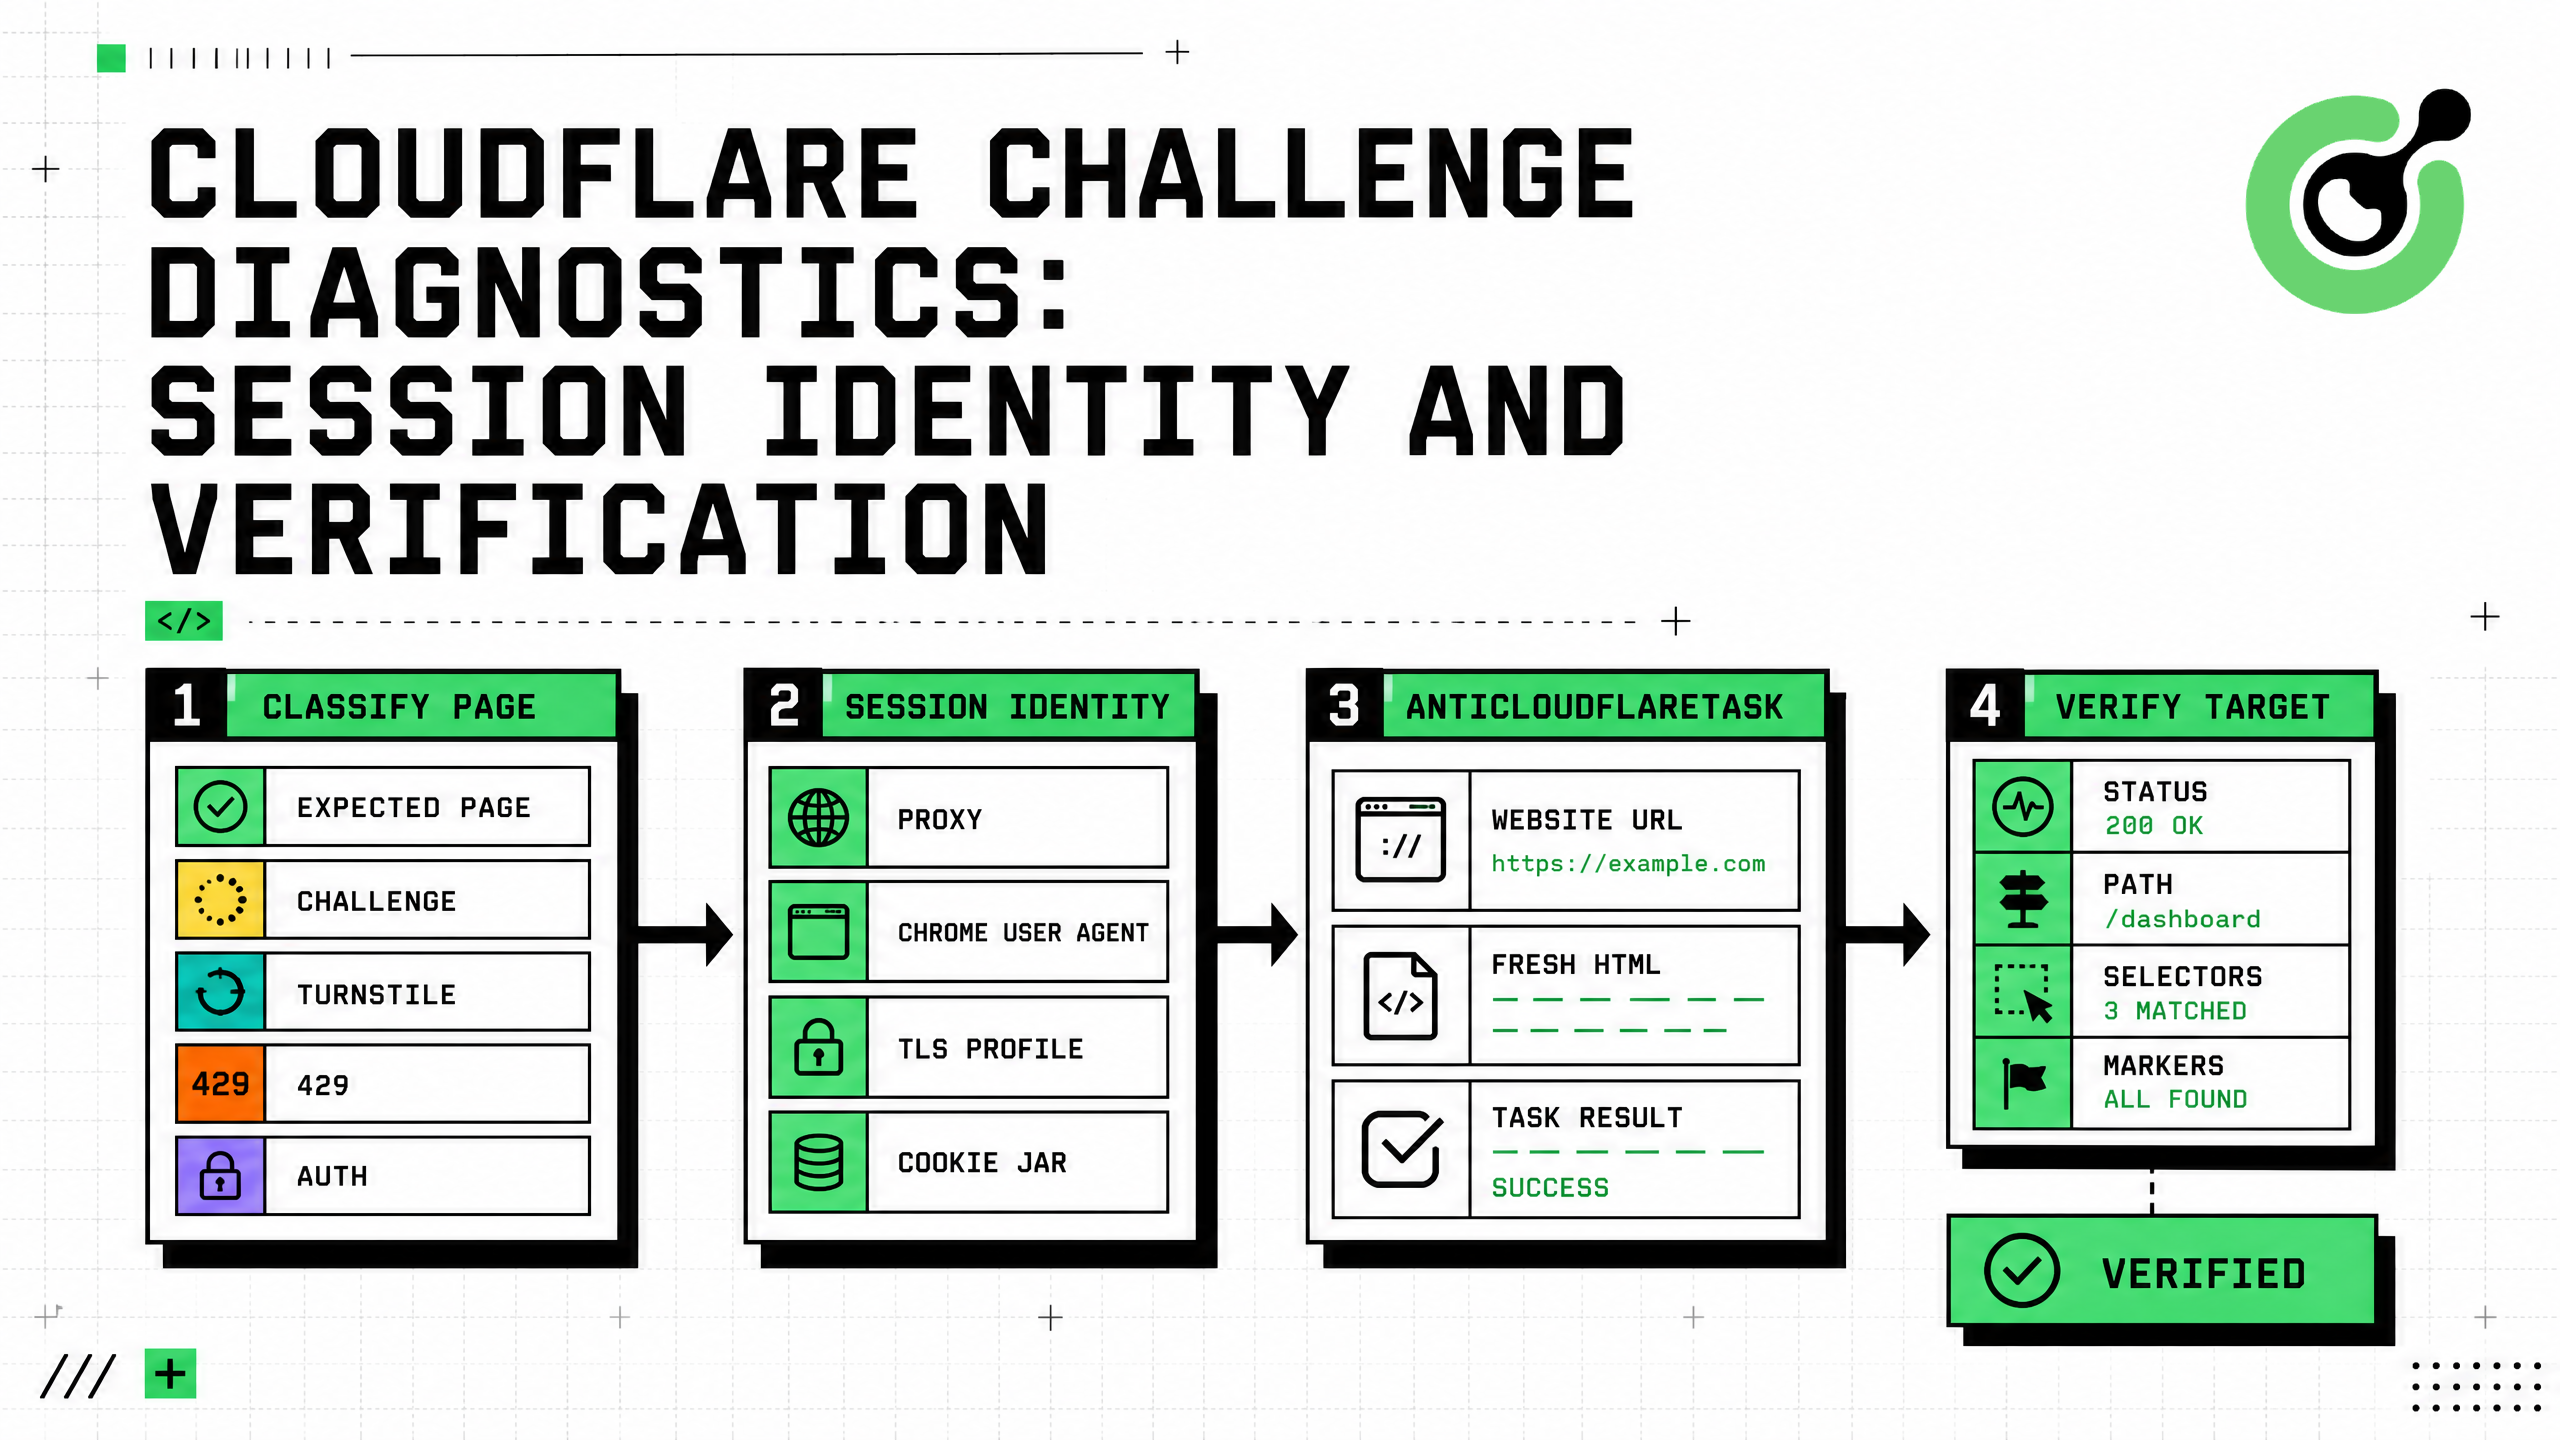
Diagnósticos del Desafío de Cloudflare: Identidad y Verificación de Sesión
Diagnosticar flujos de desafíos de Cloudflare con AntiCloudflareTask, proxy estable e identidad de agente de usuario, HTML fresco, manejo de desbloqueo, validación y errores seguros.
Aloísio Vítor
31-Aug-2026
Cómo resolver el desafío de Cloudflare para el monitoreo de precios de propiedades
Construya un monitoreo confiable de precios de propiedades con conjuntos de datos oficiales, observaciones comparables, resolución de desafíos de Cloudflare, evidencia y alertas controladas.
Aloísio Vítor
28-Aug-2026
Cómo resolver el desafío de Cloudflare para el monitoreo de inventario de comercio electrónico
Cree un monitoreo de inventario para comercio electrónico confiable con adquisición con enfoque en API, recuperación de desafíos de Cloudflare, consistencia de sesión, evidencia de stock y alertas seguras.
Aloísio Vítor
27-Aug-2026
¿Qué es el token de Turnstile de Cloudflare inválido: Causas y soluciones?
Corrija un token de Turnstile inválido al verificar el vencimiento, la clave del sitio, la acción, el cdata, el estado del navegador, la verificación del servidor y los reintentos limitados de CapSolver.
Aloísio Vítor
11-Aug-2026
Solucionador de CAPTCHA MCP: Guía de Integración de Cloudflare Turnstile
Construya un flujo de trabajo de MCP de Cloudflare Turnstile con CapSolver, reintentos limitados, registros con datos eliminados, verificaciones de sesión y validación de resultados.
Aloísio Vítor
22-Jul-2026