




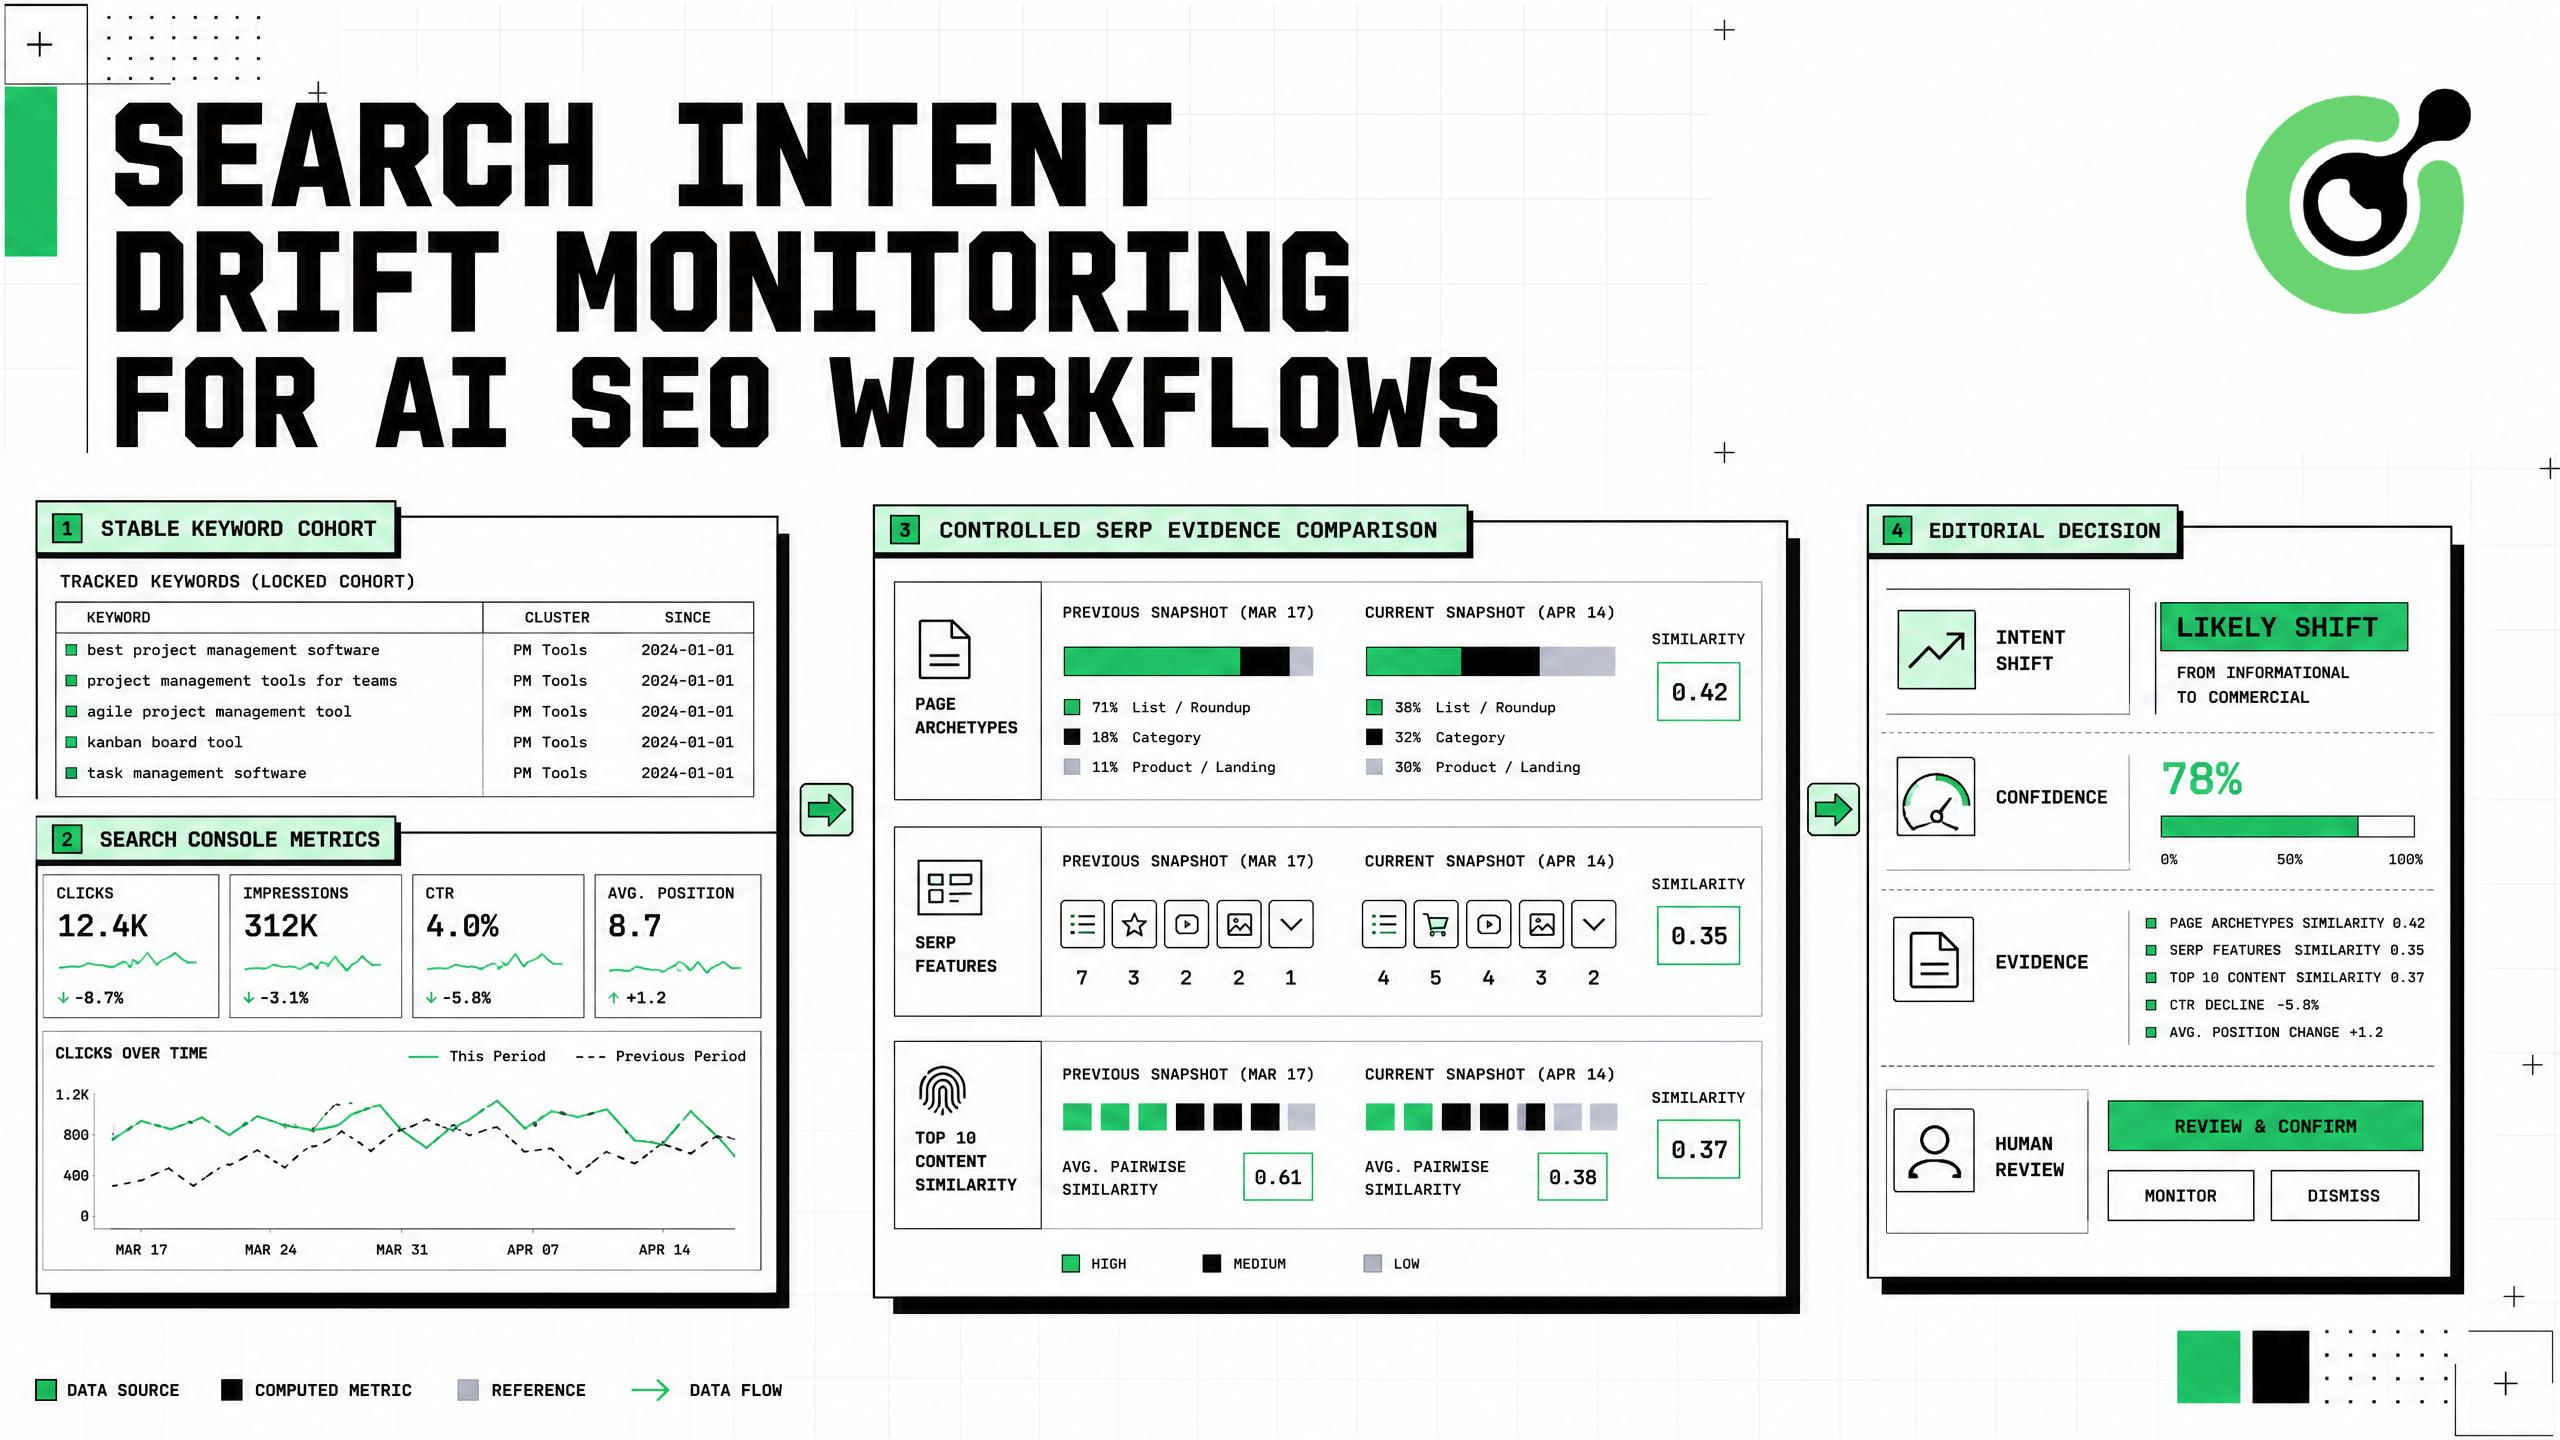
AI SEOワークフローにおける検索意図ドリフトモニタリング

Sora Fujimoto
How to use CapSolver
31-Aug-2026
TL;DR
- 検索意図の変化監視は、時間経過に伴う安定した検索クエリーコホートを比較するものであり、1つのランキングや1つのモデル応答から意図を推論するものではない。
- クリック、インプレッション、ポジションなどのデータには、認可されたAPIやユーザー提供のエクスポートからの制御されたSERP観測を追加する。
- 複数のシグナルから意図をラベル付けする: 結果タイプ、主なページアーキタイプ、SERP機能、修飾子、クエリとページの行動。
- コンテンツや内部リンクを変更する前に、継続性、カバー範囲、信頼度のしきい値を満たす必要がある。
- 自動推奨と公開決定を分離し、すべての意図変更アラートに対して証拠を保持する。
イントロダクション
検索意図の変化監視は、クエリに関連する結果セットとユーザー行動が十分に変化した場合に、既存のページが主なニーズを満たさなくなったことを検出します。信頼性の高いシステムは、AIモデルに単一の検索ページから推測させません。所有する検索コンソールのトレンド、制御されたSERPスナップショット、ページアーキタイプ、機能の変化、クエリ修飾子を組み合わせ、SEOチームにアラートを発信する前に継続性と信頼度のルールを適用します。このアプローチは、エバーグリーンガイド、プログラム生成ページ、比較コンテンツ、製品カテゴリ、および変化の早いトピックにおいて特に役立ちます。このガイドでは、証拠モデル、クエリーコホート、検索コンソールの取り込み、認可されたSERPの収集、意図のタクソノミー、類似度メトリクス、信頼度スコア、変化の確認、エージェントセーフなツール、QA、責任ある自動化について説明します。
検索意図の変化を正確に定義する
検索意図の変化は、安定したクエリーコホートの結果環境とユーザー行動によって示される主なタスクの持続的な変化です。例として以下が挙げられます:
- 情報型結果が製品カテゴリーページに置き換わる;
- 製品レビューがオフィシャル製品ページに置き換わる;
- 新鮮なニュース結果がエバーグリーンな説明文に置き換わる;
- 以前は全国的なクエリだったものがローカルパックが主となる;
- ビデオやフォーラム結果が表示結果の多くを占める;
- ブランドクエリが比較的ではなくナビゲーション目的となる;
- 所有ページが結果機能の変化後にインプレッションは得るがクリックは減る。
検索意図の変化監視の自動化は、通常の順位の変動を意図の変化としてラベル付けしてはなりません。順位、機能の存在、意図は関連していますが、異なるものです。
CapSolverの自動化ブログでは、関連するスケジュールデータワークフローがカバーされており、CapSolverのウェブスクレイピングFAQでは許可された公開ウェブ観測に関するガイドラインが提供されています。
二層の証拠モデルを使用する
最も強力なシステムは、第一-partyのパフォーマンスと制御された結果観測を組み合わせます。
| 証拠レイヤー | 例 | 何を示すか | 主な制限 |
|---|---|---|---|
| 所有パフォーマンス | インプレッション、クリック、CTR、ポジション、ページ、デバイス、国 | ユーザーが所有ページに到達する方法 | 完全な結果セットを示さない |
| 制御されたSERP観測 | 結果タイプ、URL、タイトル、機能、ページアーキタイプ | 検索環境の様子 | カバー範囲とローカライズは収集方法に依存 |
| コンテンツインベントリ | ページタイプ、テンプレート、新鮮さ、スキーマ、トピックエンティティ | サイトが現在提供している内容 | 現在の需要を証明しない |
| 人間のレビュー | クエリの意味、ビジネス文脈、リスク | 最終的な解釈 | 遅く、容量に制限がある |
Googleの検索コンソール概要では、所有サイトのクエリ、インプレッション、クリック、ポジションを検索分析レポートで説明しています。これを第一-partyシグナルとして使用し、完全な競合データセットとしては使用しないでください。
安定したクエリーコホートを構築する
文脈なしで孤立したキーワードをモニタリングしないでください。クエリを安定したビジネス質問でグループ化し、元のクエリを保持してください。
python
from dataclasses import dataclass

@dataclass(frozen=True)
class QueryCohort:
    cohort_id: str
    market: str
    language: str
    device: str
    canonical_topic: str
    queries: tuple[str, ...]
    owned_page_group: tuple[str, ...]
    business_purpose: str
例:
python
cohort = QueryCohort(
    cohort_id="captcha-api-comparison-us-en-desktop",
    market="US",
    language="en",
    device="DESKTOP",
    canonical_topic="captcha api comparison",
    queries=(
        "captcha api comparison",
        "compare captcha solving api",
        "captcha service comparison",
    ),
    owned_page_group=("/products/", "/blog/ai/"),
    business_purpose="content planning",
)
タイムシリーズ比較では、マーケット、言語、デバイスを固定してください。
所有検索コンソールデータを取得する
Googleの検索分析APIドキュメンテーションでは、クエリメソッドは日付範囲を必要とし、フィルターやグループ化次元をサポートし、すべての行ではなく上位行を返す可能性があると述べています。各抽出時にカバー範囲のノートを保存してください。
python
from googleapiclient.discovery import build
from google.oauth2 import service_account

SCOPES = ["https://www.googleapis.com/auth/webmasters.readonly"]

credentials = service_account.Credentials.from_service_account_file(
    "search-console-reader.json",
    scopes=SCOPES,
)
service = build("searchconsole", "v1", credentials=credentials)


def search_console_rows(
    site_url: str,
    start_date: str,
    end_date: str,
    row_limit: int = 25000,
) -> list[dict]:
    body = {
        "startDate": start_date,
        "endDate": end_date,
        "dimensions": ["query", "page", "country", "device"],
        "rowLimit": row_limit,
        "dataState": "final",
    }
    response = service.searchanalytics().query(
        siteUrl=site_url,
        body=body,
    ).execute()
    return response.get("rows", [])
資格情報を読み取り専用にし、ノートブックやプロンプトの外に置く。
検索コンソール観測を正規化する
python
from dataclasses import dataclass

@dataclass
class SearchPerformance:
    query: str
    page: str
    country: str
    device: str
    clicks: float
    impressions: float
    ctr: float
    position: float
    start_date: str
    end_date: str
    extraction_id: str
    coverage_note: str


def normalize_sc_row(row: dict, start_date: str, end_date: str, run_id: str):
    keys = row.get("keys") or []
    if len(keys) != 4:
        raise ValueError("Unexpected Search Console dimensions")

    return SearchPerformance(
        query=keys[0],
        page=keys[1],
        country=keys[2],
        device=keys[3],
        clicks=float(row.get("clicks", 0)),
        impressions=float(row.get("impressions", 0)),
        ctr=float(row.get("ctr", 0)),
        position=float(row.get("position", 0)),
        start_date=start_date,
        end_date=end_date,
        extraction_id=run_id,
        coverage_note="API may prioritize top rows; not guaranteed exhaustive",
    )
抽出範囲とデータの利用可能性を確認しない限り、欠落した行をゼロ需要として扱わないでください。
CapSolver AIブログでは、制御されたAIワークフローに構造化された証拠を入力する関連例が提供されています。
認可された方法を通じてSERP証拠を収集する
ライセンス付きSERP API、パートナーデータセット、またはユーザー提供のエクスポートを使用してください。ソース用語やアクセス方法が許可されていない場合は、直接の検索エンジン収集を避けてください。
python
from dataclasses import dataclass, field
from datetime import datetime, timezone

@dataclass
class SerpSnapshot:
    cohort_id: str
    query: str
    market: str
    language: str
    device: str
    source: str
    collection_id: str
    organic_results: list[dict]
    features: list[str]
    evidence_hash: str
    collected_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )
各結果に対して以下を保持してください:
- ランク;
- URLとホスト名;
- タイトルと表示スニペット;
- 結果タイプ;
- ページアーキタイプ;
- 表示された際の公開日または更新日;
- 機能所有者;
- 証拠参照。
認可された収集ソースで遭遇した課題は、インフライベントとしてルーティングする必要があります。これは欠落した結果や意図のシフトとして解釈してはなりません。
CapSolver製品ページでは、認可されたワークフローでサポートされるチャレンジカテゴリがリストされています。
実用的な意図タクソノミーを定義する
python
INTENT_LABELS = {
    "INFORMATIONAL_GUIDE",
    "TROUBLESHOOTING",
    "COMMERCIAL_COMPARISON",
    "TRANSACTIONAL_CATEGORY",
    "TRANSACTIONAL_PRODUCT",
    "NAVIGATIONAL_BRAND",
    "LOCAL_VISIT",
    "NEWS_FRESHNESS",
    "VIDEO_LEARNING",
    "COMMUNITY_DISCUSSION",
    "MIXED",
}
コンテンツ決定にマッピングされるラベルを使用してください。レビュワーが一貫して適用できない数十の重複カテゴリを避けてください。
ページアーキタイプを決定的に分類する
python
from urllib.parse import urlparse


def classify_archetype(result: dict) -> str:
    url = result.get("url", "")
    title = result.get("title", "").lower()
    path = urlparse(url).path.lower()

    if any(part in path for part in ["/product/", "/products/"]):
        return "PRODUCT_OR_CATEGORY"
    if any(part in path for part in ["/compare", "/best-"]):
        return "COMPARISON"
    if any(word in title for word in ["how to", "guide", "tutorial"]):
        return "GUIDE"
    if any(part in path for part in ["/news/", "/press/"]):
        return "NEWS"
    if any(part in path for part in ["/forum/", "/community/"]):
        return "COMMUNITY"
    return "OTHER"
曖昧なケースにはAI分類器を使用してください。最小限の結果テキストを送信し、構造化されたラベルを要求し、モデルバージョンとプロンプトバージョンを保存してください。
特徴ベクトルを構築する
python
from collections import Counter


def snapshot_features(snapshot: SerpSnapshot) -> dict:
    top_results = snapshot.organic_results[:10]
    archetypes = Counter(
        item.get("archetype", "OTHER") for item in top_results
    )
    hosts = {urlparse(item["url"]).hostname for item in top_results}

    return {
        "archetype_share": {
            key: value / max(len(top_results), 1)
            for key, value in archetypes.items()
        },
        "hosts": hosts,
        "features": set(snapshot.features),
        "top_urls": {item["url"] for item in top_results},
    }
マーケット、言語、デバイス、クエリ、収集方法が一致する場合にのみスナップショットを比較してください。
結果セットの類似度を測定する
python
def jaccard(left: set, right: set) -> float:
    union = left | right
    if not union:
        return 1.0
    return len(left & right) / len(union)


def serp_change_metrics(previous: SerpSnapshot, current: SerpSnapshot) -> dict:
    old = snapshot_features(previous)
    new = snapshot_features(current)

    return {
        "url_similarity": jaccard(old["top_urls"], new["top_urls"]),
        "host_similarity": jaccard(old["hosts"], new["hosts"]),
        "feature_similarity": jaccard(old["features"], new["features"]),
        "previous_archetypes": old["archetype_share"],
        "current_archetypes": new["archetype_share"],
    }
URLの類似度が低いだけではランクの変動を反映する可能性があります。ページアーキタイプと結果機能も変化している場合、意図の証拠はより強力です。
アーキタイプの移動を検出する
python
def archetype_delta(previous: dict, current: dict) -> dict:
    labels = set(previous) | set(current)
    return {
        label: round(current.get(label, 0) - previous.get(label, 0), 3)
        for label in labels
    }


def dominant_archetype(shares: dict) -> str:
    if not shares:
        return "UNKNOWN"
    return max(shares.items(), key=lambda item: item[1])[0]
例えば、60%のガイドページから60%の製品/カテゴリーページへの移動は、ガイドURL間の交換よりも意味があります。
検索コンソールの行動を追加する
python
def performance_delta(previous: SearchPerformance, current: SearchPerformance):
    return {
        "impression_delta": current.impressions - previous.impressions,
        "click_delta": current.clicks - previous.clicks,
        "ctr_delta": current.ctr - previous.ctr,
        "position_delta": current.position - previous.position,
    }
これらのメトリクスを慎重に解釈してください。CTRの低下は、ポジションの喪失や新しいSERP機能によるものであり、必ずしもユーザーのニーズの変化を意味するわけではありません。
複数のシグナルで意図の変化をスコアリングする
python
def intent_drift_score(metrics: dict, behavior: dict) -> dict:
    url_change = 1 - metrics["url_similarity"]
    host_change = 1 - metrics["host_similarity"]
    feature_change = 1 - metrics["feature_similarity"]

    old_dom = dominant_archetype(metrics["previous_archetypes"])
    new_dom = dominant_archetype(metrics["current_archetypes"])
    archetype_changed = float(old_dom != new_dom)

    score = (
        0.20 * url_change
        + 0.15 * host_change
        + 0.20 * feature_change
        + 0.35 * archetype_changed
        + 0.10 * min(abs(behavior["ctr_delta"]) * 5, 1)
    )

    return {
        "score": round(score, 3),
        "previous_dominant": old_dom,
        "current_dominant": new_dom,
        "archetype_changed": bool(archetype_changed),
    }
重みを仮説として扱い、普遍的な真実として提示するのではなく、レビューされた歴史的ケースに基づいて調整してください。
継続性を要件とする
python
def confirmed_drift(windows: list[dict], minimum_score: float = 0.55):
    if len(windows) < 3:
        return False

    recent = windows[-3:]
    high = [item for item in recent if item["score"] >= minimum_score]
    labels = {
        item["current_dominant"]
        for item in recent
        if item["current_dominant"] != "UNKNOWN"
    }

    return len(high) >= 2 and len(labels) == 1
検索意図の変化監視の自動化は、新しい主なアーキタイプが複数の有効なスナップショットで持続することを要件とすべきです。低ボリュームまたは季節的なクエリの場合は、ウィンドウを拡大してください。
証拠豊富なアラートを作成する
python
def build_drift_alert(cohort: QueryCohort, analysis: dict) -> dict:
    return {
        "event": "SEARCH_INTENT_DRIFT_CONFIRMED",
        "cohort_id": cohort.cohort_id,
        "topic": cohort.canonical_topic,
        "market": cohort.market,
        "device": cohort.device,
        "previous_intent": analysis["previous_dominant"],
        "current_intent": analysis["current_dominant"],
        "score": analysis["score"],
        "snapshot_ids": analysis["snapshot_ids"],
        "search_console_run_ids": analysis["search_console_run_ids"],
        "recommended_action": "human_content_review",
    }
アラートは自動的にリライトを公開するのではなく、証拠を指し示す必要があります。
意図イベントとインフライベントを分離する
| イベント | 意味 | 行動 |
|---|---|---|
INTENT_DRIFT_CONFIRMED |
持続的なアーキタイプと機能のシフト | コンテンツ戦略家のレビュー |
RANK_VOLATILITY |
意図の証拠なしでURLが変化 | 継続的なモニタリング |
FEATURE_SHIFT |
SERP機能の混合が変化 | CTR影響のレビュー |
GSC_COVERAGE_LIMITED |
抽出結果は上位行のみを含む可能性があります | レコードカバレッジの警告 |
SNAPSHOT_MISSING |
承認済みソースが証拠を返却しませんでした | ソース操作キュー |
CHALLENGE_ENCOUNTERED |
コレクションソースがサポートされたチャレンジを提示しました | インフラハンドリング |
PARSER_UNKNOWN |
スナップショット形式が変更されました | データ品質キュー |
ミスデータを意図のずれとラベル付けしないでください。
CapSolverエラーのFAQは、チームがソースおよびチャレンジの失敗をビジネスシグナルから別々に正規化するのを支援します。
AIエージェントに安全な分析ツールを提供する
python
from dataclasses import dataclass

@dataclass(frozen=True)
class AnalysisCase:
    case_id: str
    cohort_id: str
    approved_purpose: str
    snapshot_ids: tuple[str, ...]
    search_console_run_ids: tuple[str, ...]

CASES: dict[str, AnalysisCase] = {}

async def analyze_search_intent_case(case_id: str) -> dict:
    """保存された証拠から事前に承認された検索意図ケースを分析します。"""
    case = CASES.get(case_id)
    if case is None:
        raise PermissionError("不明な分析ケース")

    result = analysis_service.compute(case)
    return {
        "case_id": case.case_id,
        "status": result.status,
        "previous_intent": result.previous_intent,
        "current_intent": result.current_intent,
        "confidence": result.confidence,
        "evidence_references": result.evidence_references,
        "review_required": True,
    }
モデルは検索コンソールの資格情報、制限のないURL、ブラウザセッション、またはローカルプライベートエクスポートではなく、証拠参照と分析結果を受け取ります。
意図の変化をコンテンツ決定にマッピングする
python
CONTENT_ACTIONS = {
    ("GUIDE", "COMPARISON"): "決定基準と比較表を追加する",
    ("GUIDE", "PRODUCT_OR_CATEGORY"): "カテゴリまたは製品ランディングページの適合性を確認する",
    ("EVERGREEN", "NEWS"): "新鮮さワークフローまたはニュースコンパニオンページを追加する",
    ("NATIONAL", "LOCAL"): "ローカルページとローカル証拠を確認する",
    ("TEXT", "VIDEO"): "検証済みビデオまたは視覚的説明を追加する",
}
このマッピングはレビューのプロンプトを生成します。編集者による承認なしにプロダクションページを変更してはなりません。
プログラム品質を測定する
| メトリクス | 定義 | 達成すべき行動 |
|---|---|---|
| スナップショット有効率 | 比較可能なスナップショット数 / 予定されたスナップショット数 | 高く安定していること |
| クォータ群カバレッジ | 有効なGSCおよびSERP証拠を持つクエリ | 市場/デバイスごとに文書化されていること |
| レビューアクセプタンス | 人間が意図ラベルに合意していること | タクソノミーの明確さに応じて改善すること |
| アラート精度 | 確認されたアラートが実行可能と判断されたもの | 量を拡大する前に高いこと |
| フェルスチェンジレート | ソース/パーサーの失敗によって引き起こされたアラート | ほぼゼロであること |
| レビュータイム | アラートから決定までの時間 | 編集者のSLA内であること |
| 証拠の完全性 | 必要なスナップショットおよび抽出IDが含まれるアラート | 100% |
検索意図のずれモニタリングの自動化は、最大のアラート数よりも正確でレビュー可能なアラートを最適化する必要があります。
ボーナスコード: CapSolverダッシュボードでコード WEBS を使用すると、各チャージで追加の5%ボーナスが得られます。
比較サマリー
| アプローチ | コンテキスト品質 | 審査可能性 | 推奨役割 |
|---|---|---|---|
| ランクトラッカーのみ | 意図に対して低い | 中程度 | ボラティリティシグナル |
| 検索コンソールのみ | 強い所有行動 | 高い | 第三者パフォーマンス層 |
| 1つのライブSERPスナップショット | 中程度 | 中程度 | 診断証拠 |
| 永続的なSERPとGSC証拠 | 高い | 高い | 意図変化モニタリング |
| 保存された証拠なしのモデル意見 | 低い | 低い | 避けること |
組み合わせたアプローチにより、SEO、コンテンツ、データ、コンプライアンスチームにとって検索意図のずれモニタリングを説明可能にします。
プロダクションチェックリスト
- 市場、言語、デバイス、トピックごとに安定したクエリグループを定義する。
- 読み取り専用の検索コンソール資格情報を使用する。
- APIのカバレッジ制限と抽出IDを記録する。
- 承認された方法を通じてSERP観測を収集する。
- 結果タイプ、URL、特徴、アーキタイプ、証拠ハッシュを保存する。
- 等価なスナップショットのみを比較する。
- 複数の意図シグナルと持続性を要件とする。
- ソースの失敗を意図イベントから分離する。
- すべてのコンテンツ推奨を人間レビューにルーティングする。
- 過去のレビュー済みケースに基づいてしきい値を再調整する。
CapSolverのウェブスクレイピングブログは関連するデータパイプラインガイドを提供し、CapSolver用語集はチャレンジと自動化用語の標準化に役立ちます。
責任ある使用
意図されたモニタリングに許可された検索コンソールプロパティと、許可されたSERPデータソースのみを使用してください。個人およびアカウントデータを最小限に抑え、読み取り専用資格情報を使用し、レートリミットを尊重してください。ランキングや推定された意図を個人に関する証拠として扱ってはなりません。自動化されたコンテンツ変更、リダイレクト、削除、公開決定は編集者による承認の後に行うべきです。
結論
検索意図のずれモニタリングは、所有パフォーマンス、制御された結果スナップショット、ページアーキタイプ、SERP特徴、永続的証拠、人間レビューを組み合わせることで機能します。検索コンソールはユーザーが所有ページに到達する方法を示し、承認されたSERP観測は結果環境の変化を示します。決定的なスコアリングにより候補を特定し、レビュアーがコンテンツへの対応を決定します。
CapSolverで認証されたモニタリングワークフローを構築し、価値のあるクエリグループの小さなセットから始め、自動化を拡大する前にすべてのアラートを保存された証拠と照合してください。
FAQ
ランクの低下は検索意図の変化と同じですか?
いいえ。ページタイプやユーザーのニーズが安定している間でもランクは変化する可能性があります。アーキタイプ、特徴、結果セット証拠、および行動を確認して意図の変化を確認してください。
検索コンソールは完全な結果ページを表示しますか?
いいえ。所有パフォーマンスデータを提供します。クエリ、クリック、インプレッション、CTR、位置など。結果環境の証拠として制御されたSERP観測を追加してください。
アラートを発生させるために必要なスナップショットの数は?
複数の比較可能なスナップショットを使用し、持続性を要件とします。正確なウィンドウはクエリの量、ボラティリティ、シーズン性、およびビジネスリスクに依存します。
アラート後にAIがページを自動的に再作成すべきですか?
いいえ。AIは証拠を要約し、オプションを提案できますが、編集者がクエリグループ、結果セット、ビジネス目的、および可能な副作用を確認する必要があります。
コレクションソースがチャレンジまたは空のページを返す場合どうなりますか?
インフライベントを記録し、そのスナップショットを意図分析から除外してください。欠落または無効なソースデータは意図の変化の証拠ではありません。
コンプライアンス免責事項: このブログで提供される情報は、情報提供のみを目的としています。CapSolverは、すべての適用される法律および規制の遵守に努めています。CapSolverネットワークの不法、詐欺、または悪用の目的での使用は厳格に禁止され、調査されます。私たちのキャプチャ解決ソリューションは、公共データのクローリング中にキャプチャの問題を解決する際に100%のコンプライアンスを確保しながら、ユーザーエクスペリエンスを向上させます。私たちは、サービスの責任ある使用を奨励します。詳細については、サービス利用規約およびプライバシーポリシーをご覧ください。
もっと見る
CapSolver Python コア SDK と HTTP API: どちらを選びますか?
タスクのサポート、ページアクセス、レスポンス処理、およびアプリケーションが保有する責任に基づいて、CapSolver Python Core SDK または直接HTTP APIを選択してください。
Sora Fujimoto
16-Sep-2026
AI SEOワークフローにおける検索意図ドリフトモニタリング
検索意図のずれをモニタリングする機能を構築するには、サーチコンソールデータ、制御されたSERP観測、意図ラベル、信頼度ゲート、証拠、および安全なオートメーションを用いてください。
Sora Fujimoto
31-Aug-2026
Gumloop CAPTCHAの解決をWebワークフローに追加する方法
Gumloop CAPTCHA解決機能を構築する際には、検証済みHTTP契約、制御された復元ブランチ、リトライ予算、ブラウザ状態チェック、および人間へのフォールバックを備える必要があります。
Sora Fujimoto
21-Aug-2026
フォーム自動化ワークフローにCAPTCHAソルバーを追加する方法
フォーム自動化CAPTCHAソルバーは、許可されたフォームワークフローのエラーリカバリコンポーネントであり、認証を回避するためのショートカットではありません。CapSolverは、ドキュメント化されたタスクAPIを通じてreCAPTCHAの解決策を提供できますが、あなたのアプリケーションは入力、ブラウザコンテキスト、同意、および最終的な送信ルールを保持します。最も安全なシーケンスは、検出、スナップショット、1つのタスクを作成し、期限付きでポーリングし、同じセッションで結果を適用し、フォームの確認状態を確認することです。This articl
Sora Fujimoto
13-Aug-2026
RPAオートメーションワークフローでのCAPTCHAの安全な取り扱い方
RPAキャプチャ自動化は、キャプチャが明示的なワークフローステートとなる場合にのみ信頼性があります。CapSolverは、ブラウザ拡張機能またはドキュメント化されたAPIを通じてキャプチャ処理レイヤーを提供し、RPAプラットフォームはプロセスの範囲、資格情報、タイムアウト、およびビジネス検証を制御します。これにより、検証が表示された後もロボットがクリックし続けたり、フォームの状態を失ったり、2回送信したりする一般的な失敗を回避できます。プロダクション設計は検出時に一時停止し、1つのバウンド結果を待つ、ver
Sora Fujimoto
12-Aug-2026
自動化されたテストにおけるCAPTCHAの対処法
CAPTCHAを自動化されたQAテストで処理するには、制御されたテスト環境、CapSolverブラウザ統合、繰り返しの制限、信頼性のあるアサーションを使用してください。
Sora Fujimoto
11-Aug-2026