




なぜブラウザ使用エージェントが常にブロックされるのか

Sora Fujimoto
How to use CapSolver
04-Jun-2026
TL;DR
- ブラウザユーザーエージェントのトラフィックが自動化されていると見なされ、リスク制御システムによってブロックされることがあります。これにより、CAPTCHA、レート制限、またはハードブロックが行われます。
- 主な原因は、弱いIP評判、漏洩した自動化ファイントプリント、ロボットのようなタイミング、過負荷なセッションです。
- ボット検出スコアは多くのシグナルを統合して計算されるため、1つのシグナルを修正しても他のシグナルを無視すると、依然としてブロックされます。
- 現実的なファイントプリント、住宅用IP、人間のようなペース、およびCAPTCHAトークンのパスを組み合わせることで、エージェントを動作させ続けることができます。
- CapSolverなどのソルバーサービスは、エージェントが独自に回答できないチャレンジのトークンを返します。
イントロダクション
ブラウザユーザーエージェントがブロックされる理由は、検出システムがセッションが自動化されていると判断し、コンテンツに到達する前に停止するためです。原因はたいてい1つのミスではありません。ボット検出はIP評判、ブラウザファイントプリント、行動、リクエストのリズムを1つのリスクスコアに統合します。1つのシグナルだけを修正しても、エージェントは依然としてフラグが立つことがあります。このガイドでは、ブラウザユーザーエージェントがブロックされる各理由を分解し、ファイントプリント、プロキシ、ペース、CAPTCHA処理の具体的な修正方法を紹介します。サイトが依然としてチャレンジを提供する場合、ソルバーはそのステップをカバーします。この情報を適用する際は、自動化が許可されているサイトに限定してください。
ボット検出がブロックを決定する仕組み
検出システムは単一のルールではなく、統合されたスコアでブロックします。ブラウザユーザーエージェントが繰り返しブロックされる場合、いくつかの弱いシグナルが同時に積み重なっていることが一般的です。現代のリスク制御は、ネットワーク、ブラウザ、および行動を組み合わせて評価します。これは Cloudflareのボットスコアドキュメント に記載されています。
スコアは3つのレイヤーに依存します:
- ネットワークレイヤー。IPの種類、評判、ASN。
- ブラウザレイヤー。ヘッダー、TLSファイントプリント、JavaScript環境、および自動化マーカー。
- 行動レイヤー。クリックタイミング、ナビゲーションの順序、リクエストのリズム。
各レイヤーがリスクを加算または減算します。住宅用IPで完璧なファイントプリントを持っている場合でも、1分間に200ページをリクエストするとブロックされる可能性があります。これが、部分的な修正後でもブラウザユーザーエージェントがブロックされる理由です。
理由1: 自動化ファイントプリントが漏洩している
ブラウザユーザーエージェントがブロックされる最も一般的な理由は、自動化ファイントプリントが漏洩していることです。デフォルトのヘッドレス設定は、検出スクリプトが即座に読み取るマーカーを露出させます。
頻繁に判明する兆候:
navigator.webdriverフラグがtrueに設定されている。- ヘッドレスブラウザがプラグインが欠如している、不自然な画面サイズ、またはプレースホルダーユーザーエージェントを報告する。
- TLSファイントプリントがエージェントが主張するブラウザと一致しない。
- キャンバス、WebGL、フォントシグナルがすべての実行で一貫している。
まずファイントプリントを修正してください。実際のブラウザコンテキストを使用し、一貫性があり現実的なユーザーエージェントを設定し、提示するブラウザにTLSとJavaScriptシグナルを一致させます。ファイントプリントが人間のように見えると、ブラウザユーザーエージェントがブロックされる頻度は大幅に減少します。ハードニングを適用したPlaywrightまたはSeleniumの設定は、単なるヘッドレス起動よりも強力なベースとなります。
理由2: 弱いIP評判
IP評判はスコアの大きな部分を占めます。ブラウザユーザーエージェントが最初のリクエストでブロックされる場合、IPが原因であることがよくあります。
評判を悪化させる要因:
- 自動化に適していると検出リストでマークされるデータセンターおよびクラウドIP範囲。
- 他のボットによってすでに使用された共有アドレス。
- 非自然なリクエスト量を処理する単一のIP。
実際の消費者接続からトラフィックが発信されるように、住宅用プロキシまたはモバイルプールに移動してください。リクエストごとにアドレスをローテーションするのではなく、適切な頻度でローテーションしてください。これ自体がロボットのように見えるためです。良いIP評判は漏洩したファイントプリントを救うことはできませんが、悪いIPはブラウザがどれほど清潔に見えても、依然としてブロックを引き起こします。
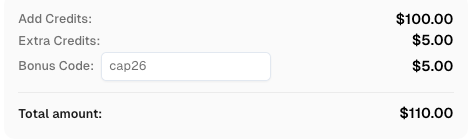
CapSolverのボーナスコードを取得する
自動化予算を即座に増やす!
CapSolverアカウントにチャージする際にボーナスコード CAP26 を使用すると、毎回のチャージで 5%のボーナス を受け取れます — 限度はありません。
今すぐCapSolverダッシュボードで取得してください。
理由3: ロボットのような行動とタイミング
行動は多くのエージェントが無視するレイヤーです。ブラウザユーザーエージェントが人間よりもはやく、均一に動くとブロックされます。
フラグをトリガーするパターン:
- すべてのアクション間の同じインターバル。
- 読み込みやレンダリング時間を一切かけずに即座にナビゲート。
- 完璧に直線的なカーソルのパス、またはポインターイベントが全くない。
- すべての実行で同じサイトのパス。
変化を加えてください。小さなランダムな遅延を挿入し、ページが落ち着く時間を許可し、タスクが許す範囲でナビゲーションの順序を変更してください。人間のセッションは不規則であり、検出システムはその不規則性を期待しています。ペースの変更は安価で、ブラウザユーザーエージェントが良いIPとファイントプリントを持っていてもブロックされる場合、ブロック率を劇的に削減する可能性があります。
理由4: サイトがCAPTCHAを提供する
検出が設計通りに機能し、チャレンジを提示する場合があります。その時点でブラウザユーザーエージェントはチャレンジに回答するまでブロックされます。エージェントはページを理解してreCAPTCHAやCloudflare Turnstileタスクを完了できません。
トークンフローで処理してください:
- ページ内の既知のCAPTCHAマーカーをチェックしてチャレンジを検出します。
- サイトキーとページURLをソルビングサービスに送信します。
- トークンを受信し、サイトが期待するフィールドにインジェクトします。
- 再送信して、サイトが本物のコンテンツを返すようにします。
サービスで文書化された公式タスクパターンのみを使用してください。パラメータを独自に作成しないでください。実際のブラウザ内で動作する例については、Playwright CAPTCHAソルビングのガイドを参照してください。Turnstileチャレンジがブロッカーの場合、Cloudflare Turnstileで詰まったAIエージェントのウォークスルーで説明されているステップが直接適用されます。
比較要約
| ブロックの原因 | 主なシグナル | 主な修正 | 他の層を無視するとブロックされるか |
|---|---|---|---|
| 漏洩したファイントプリント | navigator.webdriver、TLSの不一致 | 実際のブラウザコンテキストをハードニング | ファイントプリントの修正のみ |
| 弱いIP評判 | データセンターのASN、使用済みIP | 住宅用またはモバイルプロキシ | IPの修正のみ |
| ロボットのようなタイミング | 均一なインターバル、レンダリング時間なし | 人間のようなペース | 行動の修正のみ |
| ハードなCAPTCHA | reCAPTCHAまたはTurnstileが表示される | トークンソルビングフロー | 1つの層のみ |
結論
ブラウザユーザーエージェントがブロックされるのは、ネットワーク、ブラウザ、および行動が統合されたスコアで評価されるためです。4つのレイヤーすべてを修正してください。ファイントプリントをハードニングし、住宅用IPを使用し、人間のようにアクションをペースし、チャレンジに備えてCAPTCHAトークンフローを追加してください。1つのレイヤーを無視するだけで、エージェントがフラグが立つことになります。ブロックを処理することは、許可されているサイトとデータに限定してください。ブロックを回避しても、制限された情報の収集を許可するものではありません。
FAQ
住宅用プロキシを使用しているにもかかわらず、ブラウザエージェントがブロックされるのはなぜですか?
良いIPは1つのシグナルにすぎません。ファイントプリントが自動化マーカーを漏洩しているか、タイミングがロボットのように見える場合、検出は依然としてセッションをブロックします。すべてのレイヤーを同時に修正してください。
ブロックを減らすための最速の単一の変更は何ですか?
ブラウザファイントプリントのハードニングが最も効果的です。navigator.webdriverフラグの漏洩やTLSシグナルの不一致は即座に判明するためです。それと同時に、より良いIPとペースを組み合わせてください。
エージェントが解決できないCAPTCHAをどうやって突破すればよいですか?
チャレンジを検出し、サイトキーとページURLをソルビングサービスに送信し、トークンを受信して、サイトが期待するフィールドにインジェクトし、再送信して本物のコンテンツをロードしてください。
実際のブラウザを実行してもすべてのブロックが停止しますか?
いいえ。実際のブラウザコンテキストはJavaScriptスコアのサイトには役立ちますが、ハードなCAPTCHA、悪いIP、またはロボットのようなタイミングにより、エージェントは依然としてブロックされる可能性があります。
エージェントをブロックされないようにする行為は合法ですか?
サイトを所有しているか、自動化が許可されている場合に限ります。ブロックを回避しても、プライベート、制限、または許可されていないデータの収集を許可するものではありません。
コンプライアンス免責事項: このブログで提供される情報は、情報提供のみを目的としています。CapSolverは、すべての適用される法律および規制の遵守に努めています。CapSolverネットワークの不法、詐欺、または悪用の目的での使用は厳格に禁止され、調査されます。私たちのキャプチャ解決ソリューションは、公共データのクローリング中にキャプチャの問題を解決する際に100%のコンプライアンスを確保しながら、ユーザーエクスペリエンスを向上させます。私たちは、サービスの責任ある使用を奨励します。詳細については、サービス利用規約およびプライバシーポリシーをご覧ください。
もっと見る
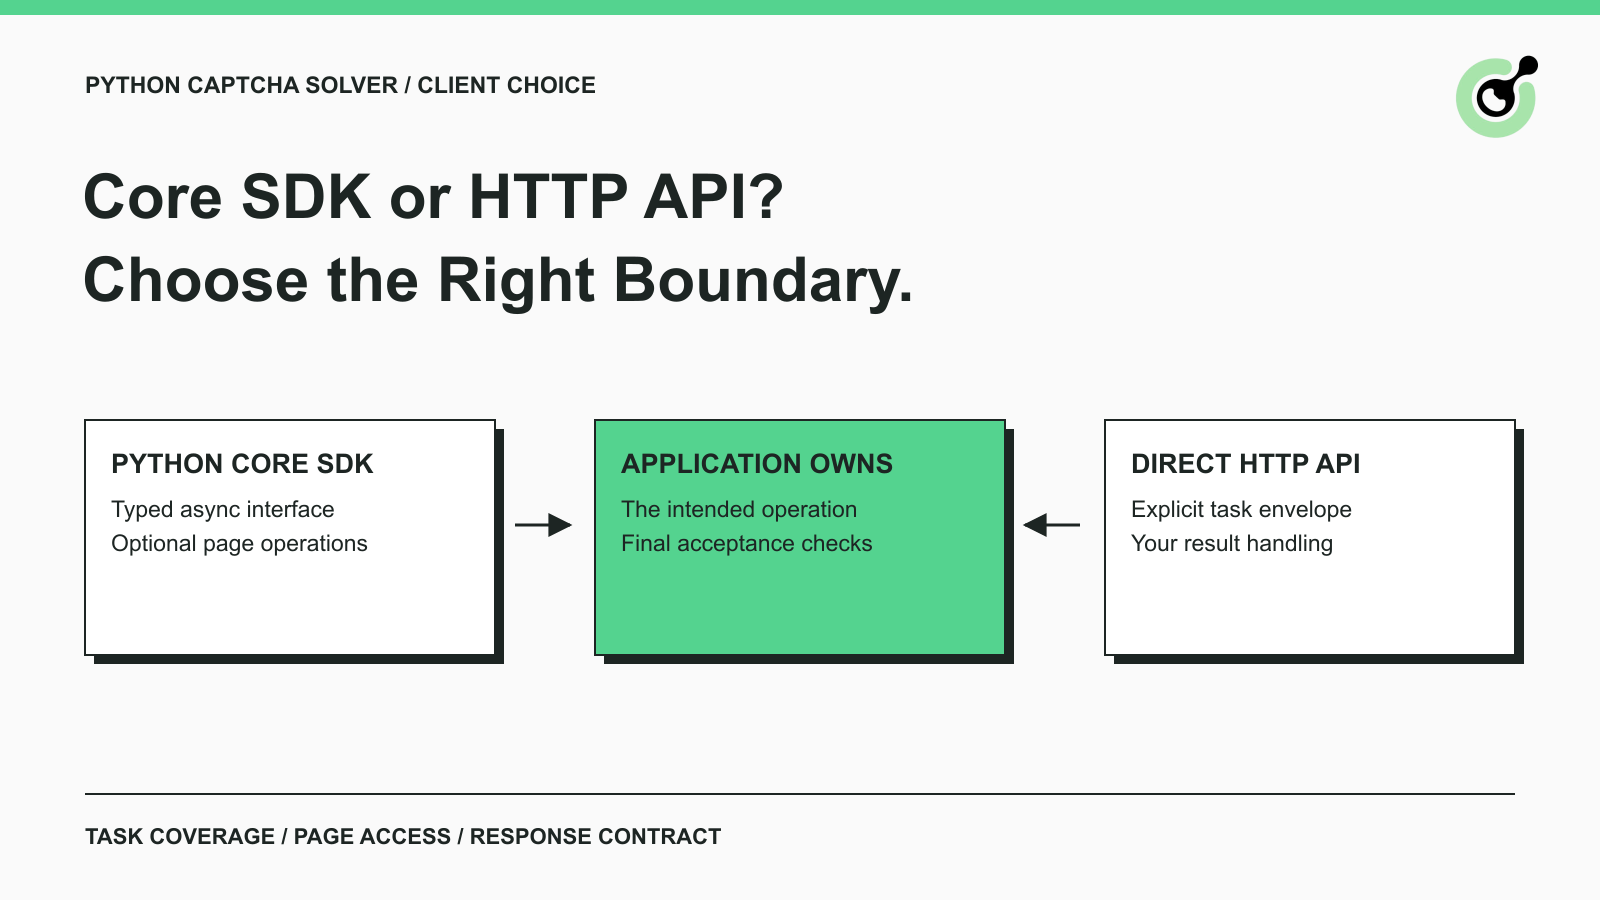
CapSolver Python コア SDK と HTTP API: どちらを選びますか?
タスクのサポート、ページアクセス、レスポンス処理、およびアプリケーションが保有する責任に基づいて、CapSolver Python Core SDK または直接HTTP APIを選択してください。
Sora Fujimoto
16-Sep-2026
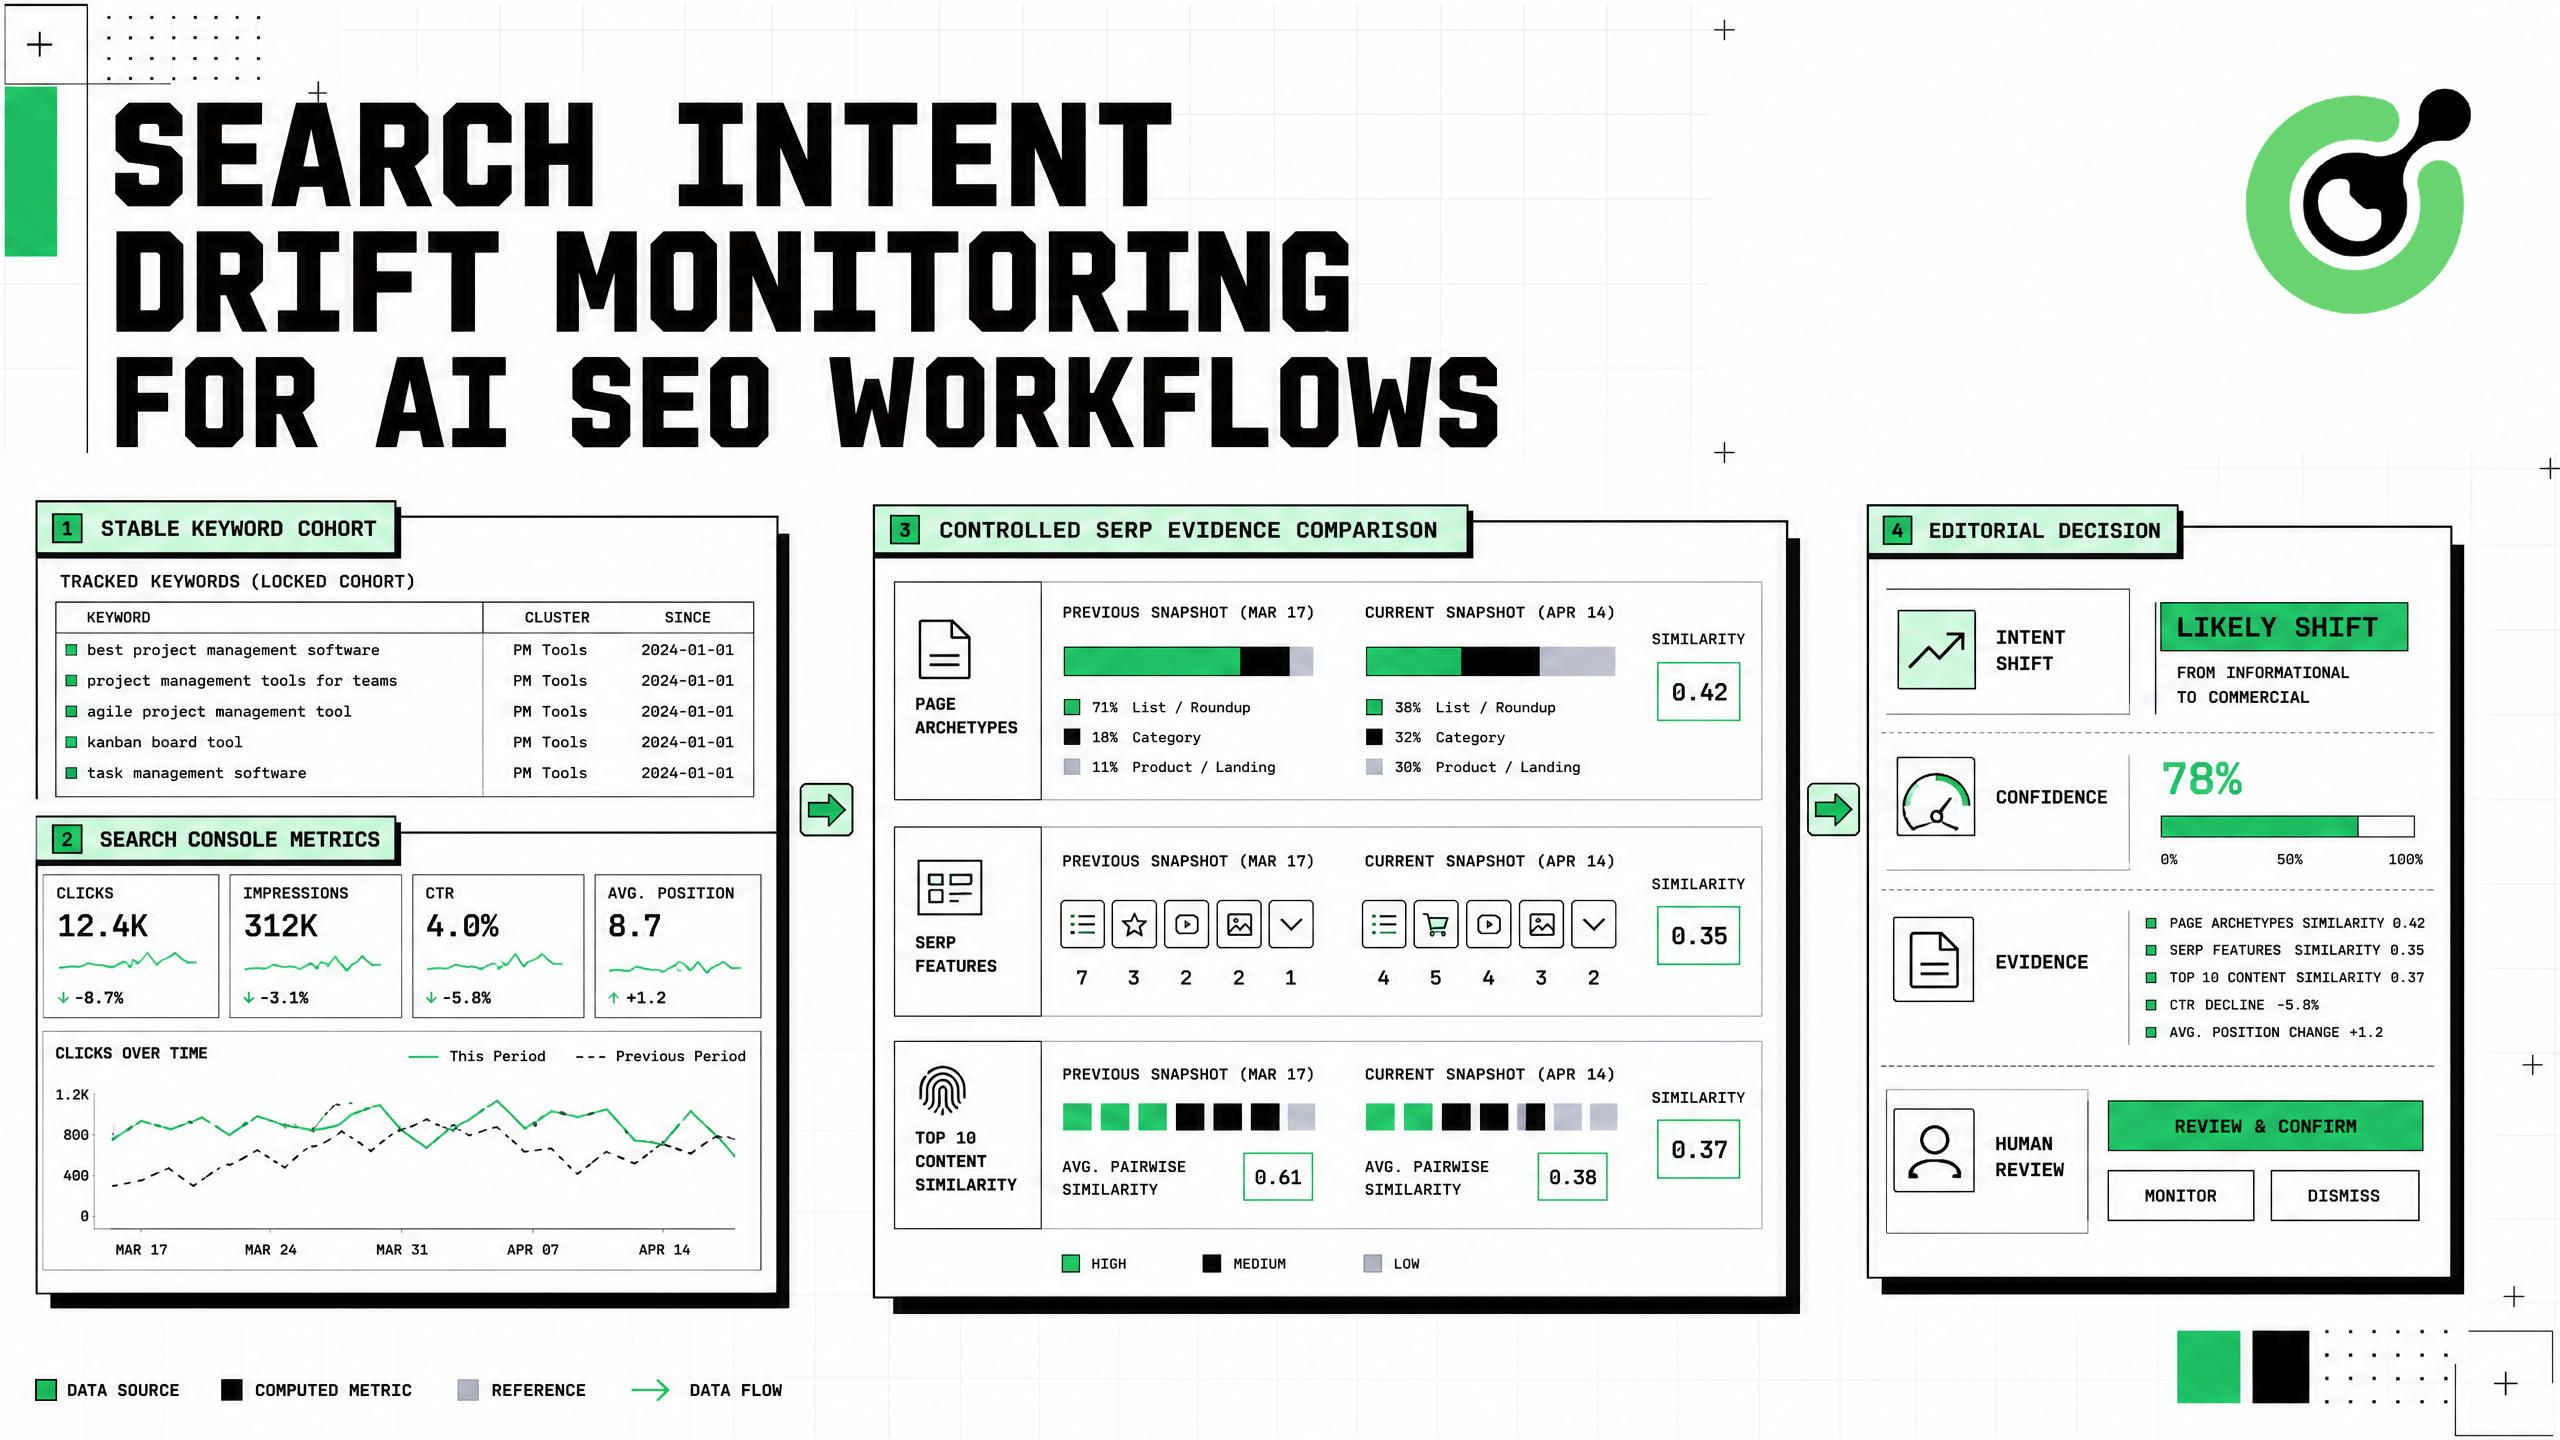
AI SEOワークフローにおける検索意図ドリフトモニタリング
検索意図のずれをモニタリングする機能を構築するには、サーチコンソールデータ、制御されたSERP観測、意図ラベル、信頼度ゲート、証拠、および安全なオートメーションを用いてください。
Sora Fujimoto
31-Aug-2026
Gumloop CAPTCHAの解決をWebワークフローに追加する方法
Gumloop CAPTCHA解決機能を構築する際には、検証済みHTTP契約、制御された復元ブランチ、リトライ予算、ブラウザ状態チェック、および人間へのフォールバックを備える必要があります。
Sora Fujimoto
21-Aug-2026
フォーム自動化ワークフローにCAPTCHAソルバーを追加する方法
フォーム自動化CAPTCHAソルバーは、許可されたフォームワークフローのエラーリカバリコンポーネントであり、認証を回避するためのショートカットではありません。CapSolverは、ドキュメント化されたタスクAPIを通じてreCAPTCHAの解決策を提供できますが、あなたのアプリケーションは入力、ブラウザコンテキスト、同意、および最終的な送信ルールを保持します。最も安全なシーケンスは、検出、スナップショット、1つのタスクを作成し、期限付きでポーリングし、同じセッションで結果を適用し、フォームの確認状態を確認することです。This articl
Sora Fujimoto
13-Aug-2026
RPAオートメーションワークフローでのCAPTCHAの安全な取り扱い方
RPAキャプチャ自動化は、キャプチャが明示的なワークフローステートとなる場合にのみ信頼性があります。CapSolverは、ブラウザ拡張機能またはドキュメント化されたAPIを通じてキャプチャ処理レイヤーを提供し、RPAプラットフォームはプロセスの範囲、資格情報、タイムアウト、およびビジネス検証を制御します。これにより、検証が表示された後もロボットがクリックし続けたり、フォームの状態を失ったり、2回送信したりする一般的な失敗を回避できます。プロダクション設計は検出時に一時停止し、1つのバウンド結果を待つ、ver
Sora Fujimoto
12-Aug-2026
自動化されたテストにおけるCAPTCHAの対処法
CAPTCHAを自動化されたQAテストで処理するには、制御されたテスト環境、CapSolverブラウザ統合、繰り返しの制限、信頼性のあるアサーションを使用してください。
Sora Fujimoto
11-Aug-2026