




Cloudflareチャレンジ診断: セッションアイデンティティと検証

Sora Fujimoto
How to use CapSolver
31-Aug-2026
TL;DR
- CloudflareチャレンジページとTurnstile、レートリミット、認証、ネットワークエラー、アプリケーションエラーを区別してください。
- 既知の
AntiCloudflareTaskを使用し、正確なターゲットURLと静的またはスタックプロキシを使用してください。サポートされているChromeユーザー代理を一貫して使用してください。 - もしチャレンジHTMLが必要な場合は、別のリクエストIDではなく、同じ承認されたセッションから即座にキャプチャしてください。
cf_clearance、クッキー、トークン、プロキシの資格情報、およびローカルHTMLを短期間のシークレットとして扱い、ログや分析に含めないでください。- 用意されたタスクの結果は中間的な成功を示すだけであり、意図したターゲットページがロードされていることを確認し、チャレンジが存在しないことを検証する必要があります。
イントロダクション
Cloudflareチャレンジの診断は、繰り返しタスクの作成ではなく、状態の分類とセッションIDから始めるべきです。保護されたページは、中間のチャレンジ、Turnstileウィジェット、HTTP 429応答、ハードブロック、認証画面、オリジンエラー、または通常のアプリケーションページを表示する可能性があります。各状態には異なるアクションが必要です。サポートされているチャレンジページの場合、CapSolverは正確なターゲットURL、静的またはスタックプロキシ、一貫したChromeユーザー代理を備えたAntiCloudflareTaskを文書化しています。一部のサイトでは、同じセッションからの新しいチャレンジHTMLも必要になることがあります。返されたクリアランスデータは、同じリクエストIDに適用され、期待されるターゲットページと検証する必要があります。このガイドでは、業界、使用ケース、またはエージェントフレームワークに縛られない汎用的な実装を示します。
正しい問題定義から始める
Cloudflareはチャレンジを、ブラウザとクライアントサイドのシグナルを評価し、最小限のユーザー操作を求めるセキュリティメカニズムとして説明しています。この広範なカテゴリは、すべてのブロックまたは不完全な応答と混同しないでください。
診断ワークフローは順番に以下の4つの質問に答えなければなりません:
- ターゲットは承認された範囲内にありますか?
- 実際に観測されたページまたは応答の状態は何ですか?
- 状態はサポートされているCapSolverタスクタイプと一致しますか?
- タスク実行後に意図したターゲットページがロードされましたか?
CapSolver Cloudflareブログには関連する製品および実装資料が含まれており、CapSolver CAPTCHA解決FAQでは一般的なタスクライフサイクルが説明されています。
主な応答状態を区別する
| 状態 | 一般的な証拠 | 正しい次のアクション |
|---|---|---|
| 期待されるページ | 知られているタイトル、ルート、セマンティックセレクター、または応答スキーマ | 解析または継続 |
| Cloudflareチャレンジページ | 「Just a moment…」、チャレンジスクリプト、Cloudflareマーカー | 範囲を検証し、AntiCloudflareTaskを検討 |
| Turnstileウィジェット | Turnstileスクリプト、サイトキー、ウィジェットコンテナ | 文書化されたTurnstileタスクパスを使用 |
| レートリミット | HTTP 429、Retry-After、クォータ応答 |
待機し、リクエストレートを減少 |
| 認証が必要 | ログインフォーム、401、セッション期限切れ状態 | 承認されたフローを通じて認証 |
| ハードブロック | サポートされているチャレンジの証拠なしの永続的な403 | 停止し、アクセスポリシーまたはネットワークIDを再確認 |
| オリジンまたはネットワークエラー | 5xx、DNS、TLS、タイムアウト | インフラストラクチャを修正してください。チャレンジタスクを作成しないでください |
| 知らないページ | レイアウトまたはセマンティクスが既知の状態と一致しない | 赤色処理された診断を保存し、レビューを要求 |
チャレンジサービスは、すべての403または空のページの万能応答として使用してはなりません。
確定的なページ分類器を構築する
python
from dataclasses import dataclass

@dataclass(frozen=True)
class HttpObservation:
    url: str
    status_code: int
    title: str
    html: str
    headers: dict[str, str]


def classify_observation(obs: HttpObservation) -> str:
    title = obs.title.lower()
    html = obs.html.lower()

    if obs.status_code == 429:
        return "RATE_LIMIT"

    if obs.status_code >= 500:
        return "ORIGIN_OR_NETWORK_ERROR"

    if "challenges.cloudflare.com/turnstile" in html:
        return "TURNSTILE_WIDGET"

    challenge_markers = (
        "just a moment" in title
        or "challenge-platform" in html
        or "cf-chl-" in html
    )
    if challenge_markers:
        return "CLOUDFLARE_CHALLENGE"

    if 'type="password"' in html or obs.status_code == 401:
        return "AUTH_REQUIRED"

    if obs.status_code == 200 and 'data-page="expected"' in html:
        return "EXPECTED_PAGE"

    if obs.status_code == 403:
        return "HARD_BLOCK"

    return "UNKNOWN_PAGE"
ターゲット固有の成功マーカーを使用してください。一般的なHTTP 200は不十分です。チャレンジ、エラー、および同意ページも200を返す可能性があるためです。
CapSolverエラーFAQは、プロバイダーエラーとページ状態エラーを分離するのに役立ちます。
セッションIDの定義
Cloudflareクリアランスは訪問者とデバイスのコンテキストに関連しています。Cloudflareのクリアランスドキュメントは、cf_clearanceが特定の訪問者とデバイスに結びついており、セッション行動の変化に応じて再評価可能であると述べています。
リクエストIDを明示的に表します:
python
from dataclasses import dataclass

@dataclass(frozen=True)
class SessionIdentity:
    session_id: str
    proxy_profile: str
    chrome_user_agent: str
    tls_profile: str
    cookie_jar_id: str
    target_host: str
このタプルは、初期観測からタスク実行およびターゲットページの検証にかけて安定している必要があります。
サーバーサイドで承認されたターゲットを登録する
python
from dataclasses import dataclass
from urllib.parse import urlparse

@dataclass(frozen=True)
class TargetPolicy:
    target_id: str
    hostname: str
    allowed_path_prefixes: tuple[str, ...]
    purpose: str
    proxy_profile: str
    max_attempts: int = 1

TARGETS = {
    "docs_demo": TargetPolicy(
        target_id="docs_demo",
        hostname="approved.example.com",
        allowed_path_prefixes=("/public/", "/test/"),
        purpose="authorized integration validation",
        proxy_profile="approved_static_us",
    )
}


def resolve_target(target_id: str, url: str) -> TargetPolicy:
    policy = TARGETS.get(target_id)
    if policy is None:
        raise PermissionError("Unknown target")

    parsed = urlparse(url)
    if parsed.scheme != "https":
        raise PermissionError("HTTPS is required")
    if parsed.hostname != policy.hostname:
        raise PermissionError("Host is outside the approved scope")
    if not any(parsed.path.startswith(p) for p in policy.allowed_path_prefixes):
        raise PermissionError("Path is outside the approved scope")
    return policy
信頼できない呼び出し元が任意のURL、プロキシ、または目的を提供しないようにしてください。
AntiCloudflareTask契約を理解する
CapSolverのCloudflareチャレンジドキュメントはAntiCloudflareTaskを定義しています。
| フィールド | 必須 | 診断ルール |
|---|---|---|
type |
はい | AntiCloudflareTaskでなければなりません |
websiteURL |
はい | 正確な承認されたターゲットページ |
proxy |
はい | セッションで使用される静的またはスタックプロキシ |
userAgent |
条件付き | クライアントで使用されているサポートされているChromeユーザー代理 |
html |
条件付き | 同じセッションからの新しいチャレンジHTML |
ドキュメントでは、TLS対応のリクエストライブラリの使用も求められ、少なくとも3分間プロキシセッションを維持することを推奨しています。
CapSolver製品ページは、サポートされているCloudflareおよびTurnstileタスクカテゴリを区別するのに役立ちます。
信頼できるセッションデータからタスクを構築する
python
import os
import capsolver

capsolver.api_key = os.environ["CAPSOLVER_API_KEY"]

PROXY_VAULT = {
    "approved_static_us": os.environ["APPROVED_STATIC_PROXY"],
}


def build_task(
    policy: TargetPolicy,
    identity: SessionIdentity,
    target_url: str,
    fresh_html: str | None,
) -> dict:
    if identity.proxy_profile != policy.proxy_profile:
        raise ValueError("Session proxy does not match target policy")
    if identity.target_host != policy.hostname:
        raise ValueError("Session host does not match target policy")

    task = {
        "type": "AntiCloudflareTask",
        "websiteURL": target_url,
        "proxy": PROXY_VAULT[identity.proxy_profile],
        "userAgent": identity.chrome_user_agent,
    }
    if fresh_html:
        task["html"] = fresh_html
    return task
タスクビルダーはネットワーク資格情報を保護されたボルトから読み込みます。呼び出し元に返したり、トレースに書き込まないでください。
同じセッションからHTMLをキャプチャする
チャレンジが必要な場合、チャレンジが識別された直後にHTMLをキャプチャしてください。
python
from datetime import datetime, timezone

@dataclass(frozen=True)
class ChallengeDocument:
    session_id: str
    target_url: str
    body: str
    status_code: int
    captured_at: str

async def capture_challenge_document(client, identity, target_url):
    response = await client.get(
        target_url,
        session_id=identity.session_id,
        proxy_profile=identity.proxy_profile,
        user_agent=identity.chrome_user_agent,
        tls_profile=identity.tls_profile,
        cookie_jar_id=identity.cookie_jar_id,
    )
    observation = HttpObservation(
        url=str(response.url),
        status_code=response.status_code,
        title=extract_title(response.text),
        html=response.text,
        headers=dict(response.headers),
    )
    if classify_observation(observation) != "CLOUDFLARE_CHALLENGE":
        raise ValueError("The response is not a recognized Challenge page")

    return ChallengeDocument(
        session_id=identity.session_id,
        target_url=target_url,
        body=response.text,
        status_code=response.status_code,
        captured_at=datetime.now(timezone.utc).isoformat(),
    )
別のプロキシ、ユーザー代理、セッション、またはターゲットURLでキャプチャされたHTMLを再利用しないでください。
CapSolverタスクを実行する
python
def solve_approved_challenge(
    target_id: str,
    target_url: str,
    identity: SessionIdentity,
    document: ChallengeDocument,
) -> dict:
    policy = resolve_target(target_id, target_url)

    if document.session_id != identity.session_id:
        raise ValueError("Document and session do not match")
    if document.target_url != target_url:
        raise ValueError("Document and target URL do not match")

    task = build_task(
        policy=policy,
        identity=identity,
        target_url=target_url,
        fresh_html=document.body,
    )
    solution = capsolver.solve(task)

    cookies = solution.get("cookies") or {}
    clearance = cookies.get("cf_clearance") or solution.get("token")
    returned_user_agent = solution.get("userAgent") or identity.chrome_user_agent

    if not clearance:
        raise RuntimeError("Task result did not contain clearance data")

    return {
        "cookies": cookies,
        "user_agent": returned_user_agent,
}solutionを出力しないでください。次のリクエストに必要なランタイムフィールドのみを抽出してください。
クッキージャーにクリアランスを適用する
python
async def apply_clearance(client, identity: SessionIdentity, result: dict):
    for name, value in result["cookies"].items():
        await client.set_cookie(
            cookie_jar_id=identity.cookie_jar_id,
            domain=identity.target_host,
            name=name,
            value=value,
            secure=True,
        )

    await client.set_user_agent(
        session_id=identity.session_id,
        user_agent=result["user_agent"],
    )
承認されたターゲットで必要な正確なホストとクッキーのスコープを使用してください。他のドメインや別のマシンにクッキーをコピーしないでください。
ターゲットページを検証する
python
@dataclass(frozen=True)
class VerificationRule:
    expected_status: int
    required_selectors: tuple[str, ...]
    forbidden_markers: tuple[str, ...]
    expected_path_prefix: str

async def verify_target_page(
    client,
    identity: SessionIdentity,
    target_url: str,
    rule: VerificationRule,
) -> dict:
    response = await client.get(
        target_url,
        session_id=identity.session_id,
        proxy_profile=identity.proxy_profile,
        user_agent=identity.chrome_user_agent,
        tls_profile=identity.tls_profile,
        cookie_jar_id=identity.cookie_jar_id,
    )

    parsed = urlparse(str(response.url))
    body = response.text.lower()

    status_ok = response.status_code == rule.expected_status
    path_ok = parsed.path.startswith(rule.expected_path_prefix)
    markers_ok = not any(marker.lower() in body for marker in rule.forbidden_markers)
    selectors_ok = all(selector_in_html(response.text, selector) for selector in rule.required_selectors)

    return {
        "verified": status_ok and path_ok and markers_ok and selectors_ok,
        "status_ok": status_ok,
        "path_ok": path_ok,
        "markers_ok": markers_ok,
        "selectors_ok": selectors_ok,
}CapSolverタスクの結果だけでは十分ではありません。この検証がverified=Trueを返すまで、アプリケーションは続行しないでください。
範囲付き状態マシンを使用する
python
from enum import Enum

class FlowState(str, Enum):
    OBSERVED = "OBSERVED"
    CLASSIFIED = "CLASSIFIED"
    TASK_CREATED = "TASK_CREATED"
    RESULT_READY = "RESULT_READY"
    PAGE_VERIFIED = "PAGE_VERIFIED"
    STOPPED = "STOPPED"

ALLOWED = {
    FlowState.OBSERVED: {FlowState.CLASSIFIED, FlowState.STOPPED},
    FlowState.CLASSIFIED: {FlowState.TASK_CREATED, FlowState.STOPPED},
    FlowState.TASK_CREATED: {FlowState.RESULT_READY, FlowState.STOPPED},
    FlowState.RESULT_READY: {FlowState.PAGE_VERIFIED, FlowState.STOPPED},
    FlowState.PAGE_VERIFIED: {FlowState.STOPPED},
}


def transition(current: FlowState, next_state: FlowState) -> FlowState:
    if next_state not in ALLOWED[current]:
        raise ValueError(f"Invalid transition: {current} -> {next_state}")
    return next_state
観測されたページ状態ごとに1つのタスク試行を許可してください。検証に失敗した場合は、ループではなく、停止してレビューを要求してください。
エラーを分類してから対応する
CapSolverのエラーコードドキュメントは、入力、制限、タイムアウト、プロキシ、アカウント、サポート、一時的なサービスエラーを区別します。
| エラークラス | 例 | 行動 |
|---|---|---|
| 無効な入力 | ERROR_INVALID_TASK_DATA |
信頼できるタスク構築を修正 |
| レートリミット | ERROR_RATE_LIMIT |
ポリシーに従って待機 |
| タイムアウト | ERROR_TASK_TIMEOUT |
時間を記録し、停止またはレビュー |
| サポートされていないタスク | ERROR_TASK_NOT_SUPPORTED |
チャレンジタイプを再分類 |
| 解決不可能 | ERROR_CAPTCHA_UNSOLVABLE |
停止し、ページ状態をレビュー |
| プロキシがブロックされました | ERROR_PROXY_BANNED |
ネットワークIDの承認済みを確認してください |
| アカウント/キー | ERROR_KEY_DENIED_ACCESS, ERROR_ZERO_BALANCE |
アカウント設定を修正してください |
| 一時的なサービス | ERROR_SERVICE_UNAVALIABLE |
待機し、プロバイダの状態を確認してください |
すべてのエラーに同じリトライルールを適用しないでください。
エラーを安定したカテゴリに正規化する
python
ERROR_ACTIONS = {
    "ERROR_INVALID_TASK_DATA": "FIX_INPUT",
    "ERROR_RATE_LIMIT": "WAIT",
    "ERROR_TASK_TIMEOUT": "REVIEW",
    "ERROR_TASK_NOT_SUPPORTED": "RECLASSIFY",
    "ERROR_CAPTCHA_UNSOLVABLE": "REVIEW",
    "ERROR_PROXY_BANNED": "REVIEW_NETWORK",
    "ERROR_KEY_DENIED_ACCESS": "FIX_ACCOUNT",
    "ERROR_ZERO_BALANCE": "FIX_ACCOUNT",
    "ERROR_SERVICE_UNAVALIABLE": "BACKOFF",
}


def normalize_error(error_code: str | None) -> dict:
    code = error_code or "UNKNOWN_ERROR"
    return {
        "category": code,
        "action": ERROR_ACTIONS.get(code, "OPERATOR_REVIEW"),
        "retry_allowed": ERROR_ACTIONS.get(code) in {"WAIT", "BACKOFF"},
    }
リトライは信頼できるポリシーに基づき、トリガー条件が変化した後または待機期間が終了した後のみ許可してください。
短命なセッション情報の保護
以下の情報をシークレットとして扱ってください:
- CapSolver APIキー;
- プロキシの資格情報;
cf_clearanceおよびその他のクッキー;- チャレンジトークン;
- デバイスIDに含まれる完全なユーザーエージェント;
- ローカルチャレンジHTML;
- ブラウザストレージ状態;
- 識別子を含む制限のないターゲットURL。
python
SAFE_EVENT_FIELDS = {
    "event",
    "target_id",
    "state",
    "error_category",
    "attempt_count",
    "duration_ms",
    "verified",
    "observed_at",
}


def redact_event(event: dict) -> dict:
    return {
        key: event[key]
        for key in SAFE_EVENT_FIELDS
        if key in event
    }
一般的なログに証拠そのものを置く代わりに、セキュアなハッシュまたは内部参照を保存してください。
CapSolver FAQ は追加の運用ガイドを提供し、CapSolverステータスページ はアプリケーションの障害とプロバイダの可用性を区別するのに役立ちます。
有用な観測性の追加
python
from datetime import datetime, timezone
from time import monotonic


def diagnostic_event(
    target_id: str,
    state: str,
    attempt_count: int,
    verified: bool,
    started_at: float,
    error_category: str | None = None,
) -> dict:
    return redact_event({
        "event": "cloudflare_challenge_diagnostic",
        "target_id": target_id,
        "state": state,
        "attempt_count": attempt_count,
        "duration_ms": int((monotonic() - started_at) * 1000),
        "verified": verified,
        "error_category": error_category,
        "observed_at": datetime.now(timezone.utc).isoformat(),
    })
チャレンジ率、成功タスク率、検証済みページ率、エラー分布、準備にかかる時間、オペレータレビューの量を追跡してください。シークレットは追跡しないでください。
診断パスのテスト
python
import pytest

@pytest.mark.parametrize(
    "status,title,html,expected",
    [
        (429, "Rate limited", "", "RATE_LIMIT"),
        (403, "Just a moment...", "cf-chl-test", "CLOUDFLARE_CHALLENGE"),
        (200, "Sign in", '<input type="password">', "AUTH_REQUIRED"),
        (500, "Server error", "", "ORIGIN_OR_NETWORK_ERROR"),
    ],
)
def test_classifier(status, title, html, expected):
    observation = HttpObservation(
        url="https://approved.example.com/test/",
        status_code=status,
        title=title,
        html=html,
        headers={},
    )
    assert classify_observation(observation) == expected
アイデンティティの不一致もテストしてください:
python
def test_task_rejects_proxy_profile_mismatch():
    policy = TARGETS["docs_demo"]
    identity = SessionIdentity(
        session_id="session-1",
        proxy_profile="wrong_profile",
        chrome_user_agent="Mozilla/5.0 ... Chrome/141.0.0.0 ...",
        tls_profile="chrome141",
        cookie_jar_id="jar-1",
        target_host="approved.example.com",
    )

    with pytest.raises(ValueError):
        build_task(
            policy=policy,
            identity=identity,
            target_url="https://approved.example.com/test/",
            fresh_html="<html>Just a moment...</html>",
        )
最後に、レダクションがクッキー、HTML、キー、プロキシ値を除外していることをテストしてください。
ボーナスコード: CapSolverダッシュボードでコード WEBS を使用すると、すべてのチャージで追加の5%のボーナスを得られます。
比較要約
| パターン | アイデンティティの一貫性 | 診断の明確さ | 推奨 |
|---|---|---|---|
| 403ごとにリトライ | 低 | 低 | 避ける |
| コールャーから提供されたフィールドからタスクを作成 | 変動 | 低 | 避ける |
| 信頼できるアイデンティティから分類、構築、検証 | 高 | 高 | 推奨 |
| 手動レビューを要求して停止 | 高 | 高 | 知らないまたは機密状態では必須 |
推奨されるパターンでは、各決定が明確でテスト可能になります。
プロダクションチェックリスト
- サーバーサイドで承認されたホスト、パス、目的、プロキシプロファイルを登録してください。
- 予期されるページ、チャレンジ、Turnstile、レートリミット、認証、ハードブロック、ネットワークエラーを別々に分類してください。
AntiCloudflareTaskは認識されたサポートされているチャレンジページでのみ使用してください。- 静的またはスタックプロキシ、サポートされているChromeユーザーエージェント、TLSプロファイル、クッキージャーを一貫して保持してください。
- 必要な場合は同じセッションからチャレンジHTMLをキャプチャしてください。
- 短命なセキュリティストレージにクリアランスデータを保持してください。
- セッションデータを適用した後に正確なターゲットページを検証してください。
- 観測された状態ごとに1つのタスク実行を許可してください。
- エラーコードを異なるアクションにマップしてください。
- 赤色化された運用フィールドのみをログに記録してください。
- ページ分類、アイデンティティ不一致、結果検証、シークレットの赤色化のテストを行ってください。
CapSolver製品ページ は実装前にサポートされているチャレンジカテゴリを確認するのに役立ちます。
責任ある使用
Cloudflareチャレンジ処理は、所有している、テストしている、または明示的なアクセス許可を与えられたサイトでのみ使用してください。利用規約、レートリミット、認証境界、プライバシー義務、ソースポリシーを尊重してください。チャレンジ処理の能力はアクセス権を保証するものではありません。ターゲットが不明、ページが機密、アイデンティティが不一致、または検証に失敗した場合は停止してください。重要なアクションは別途ポリシーと人間の承認ステップで保護してください。
結論
Cloudflareチャレンジの診断は厳密なパイプラインである必要があります。ターゲットを認証し、観測されたページを分類し、信頼できるセッションアイデンティティから AntiCloudflareTask を構築し、プロキシとサポートされているChromeユーザーエージェントを一貫して保持し、同じクッキージャーに一時的なクリアランスデータを適用し、意図したページを検証してください。エラーは盲目的にリトライするのではなく、カテゴリに分類する必要があります。シークレットはログやモデルコンテキストに含まれてはなりません。
CapSolver で承認された実装を開始し、制御されたテストページで検証し、生産使用前に状態、アイデンティティ、検証、赤色化のテストを追加してください。
FAQ
Cloudflareチャレンジページを処理するCapSolverのタスクタイプは何ですか?
観測されたページがサポートされているCloudflareチャレンジに一致し、ターゲットが認証されている場合、ドキュメントされた AntiCloudflareTask を使用してください。
プロキシは必要ですか?
はい。このタスクには静的またはスタックプロキシが必要です。認証を通じてネットワークIDを一貫して保持してください。
html フィールドを含めるのはいつですか?
ターゲットが必要とする場合は、最新のチャレンジHTMLを含めてください。同じスタックプロキシ、サポートされているChromeユーザーエージェント、クッキージャー、ターゲットURLでHTMLをキャプチャしてください。
作成されたタスクの結果は十分ですか?
いいえ。返されたセッション情報を同じリクエストアイデンティティに適用し、期待されたターゲットページがチャレンジマーカーなしでロードされたことを確認してください。
知らないエラーまたは検証に失敗した場合はどうなりますか?
停止し、赤色化された診断を保持し、オペレータレビューを要求してください。無制限のリトライループを作成しないでください。
コンプライアンス免責事項: このブログで提供される情報は、情報提供のみを目的としています。CapSolverは、すべての適用される法律および規制の遵守に努めています。CapSolverネットワークの不法、詐欺、または悪用の目的での使用は厳格に禁止され、調査されます。私たちのキャプチャ解決ソリューションは、公共データのクローリング中にキャプチャの問題を解決する際に100%のコンプライアンスを確保しながら、ユーザーエクスペリエンスを向上させます。私たちは、サービスの責任ある使用を奨励します。詳細については、サービス利用規約およびプライバシーポリシーをご覧ください。
もっと見る
ターンスタイルソルバーアプリケーションプログラミングインターフェースチェックリスト:入力、トークン、および検証
Turnstileソルバーアプリケーションプログラミングインターフェース(API)を、ドキュメントに記載された入力、トークン応答、検証境界、および制御されたテストケースによって評価し、ワークフローに追加する前に。
Sora Fujimoto
16-Sep-2026
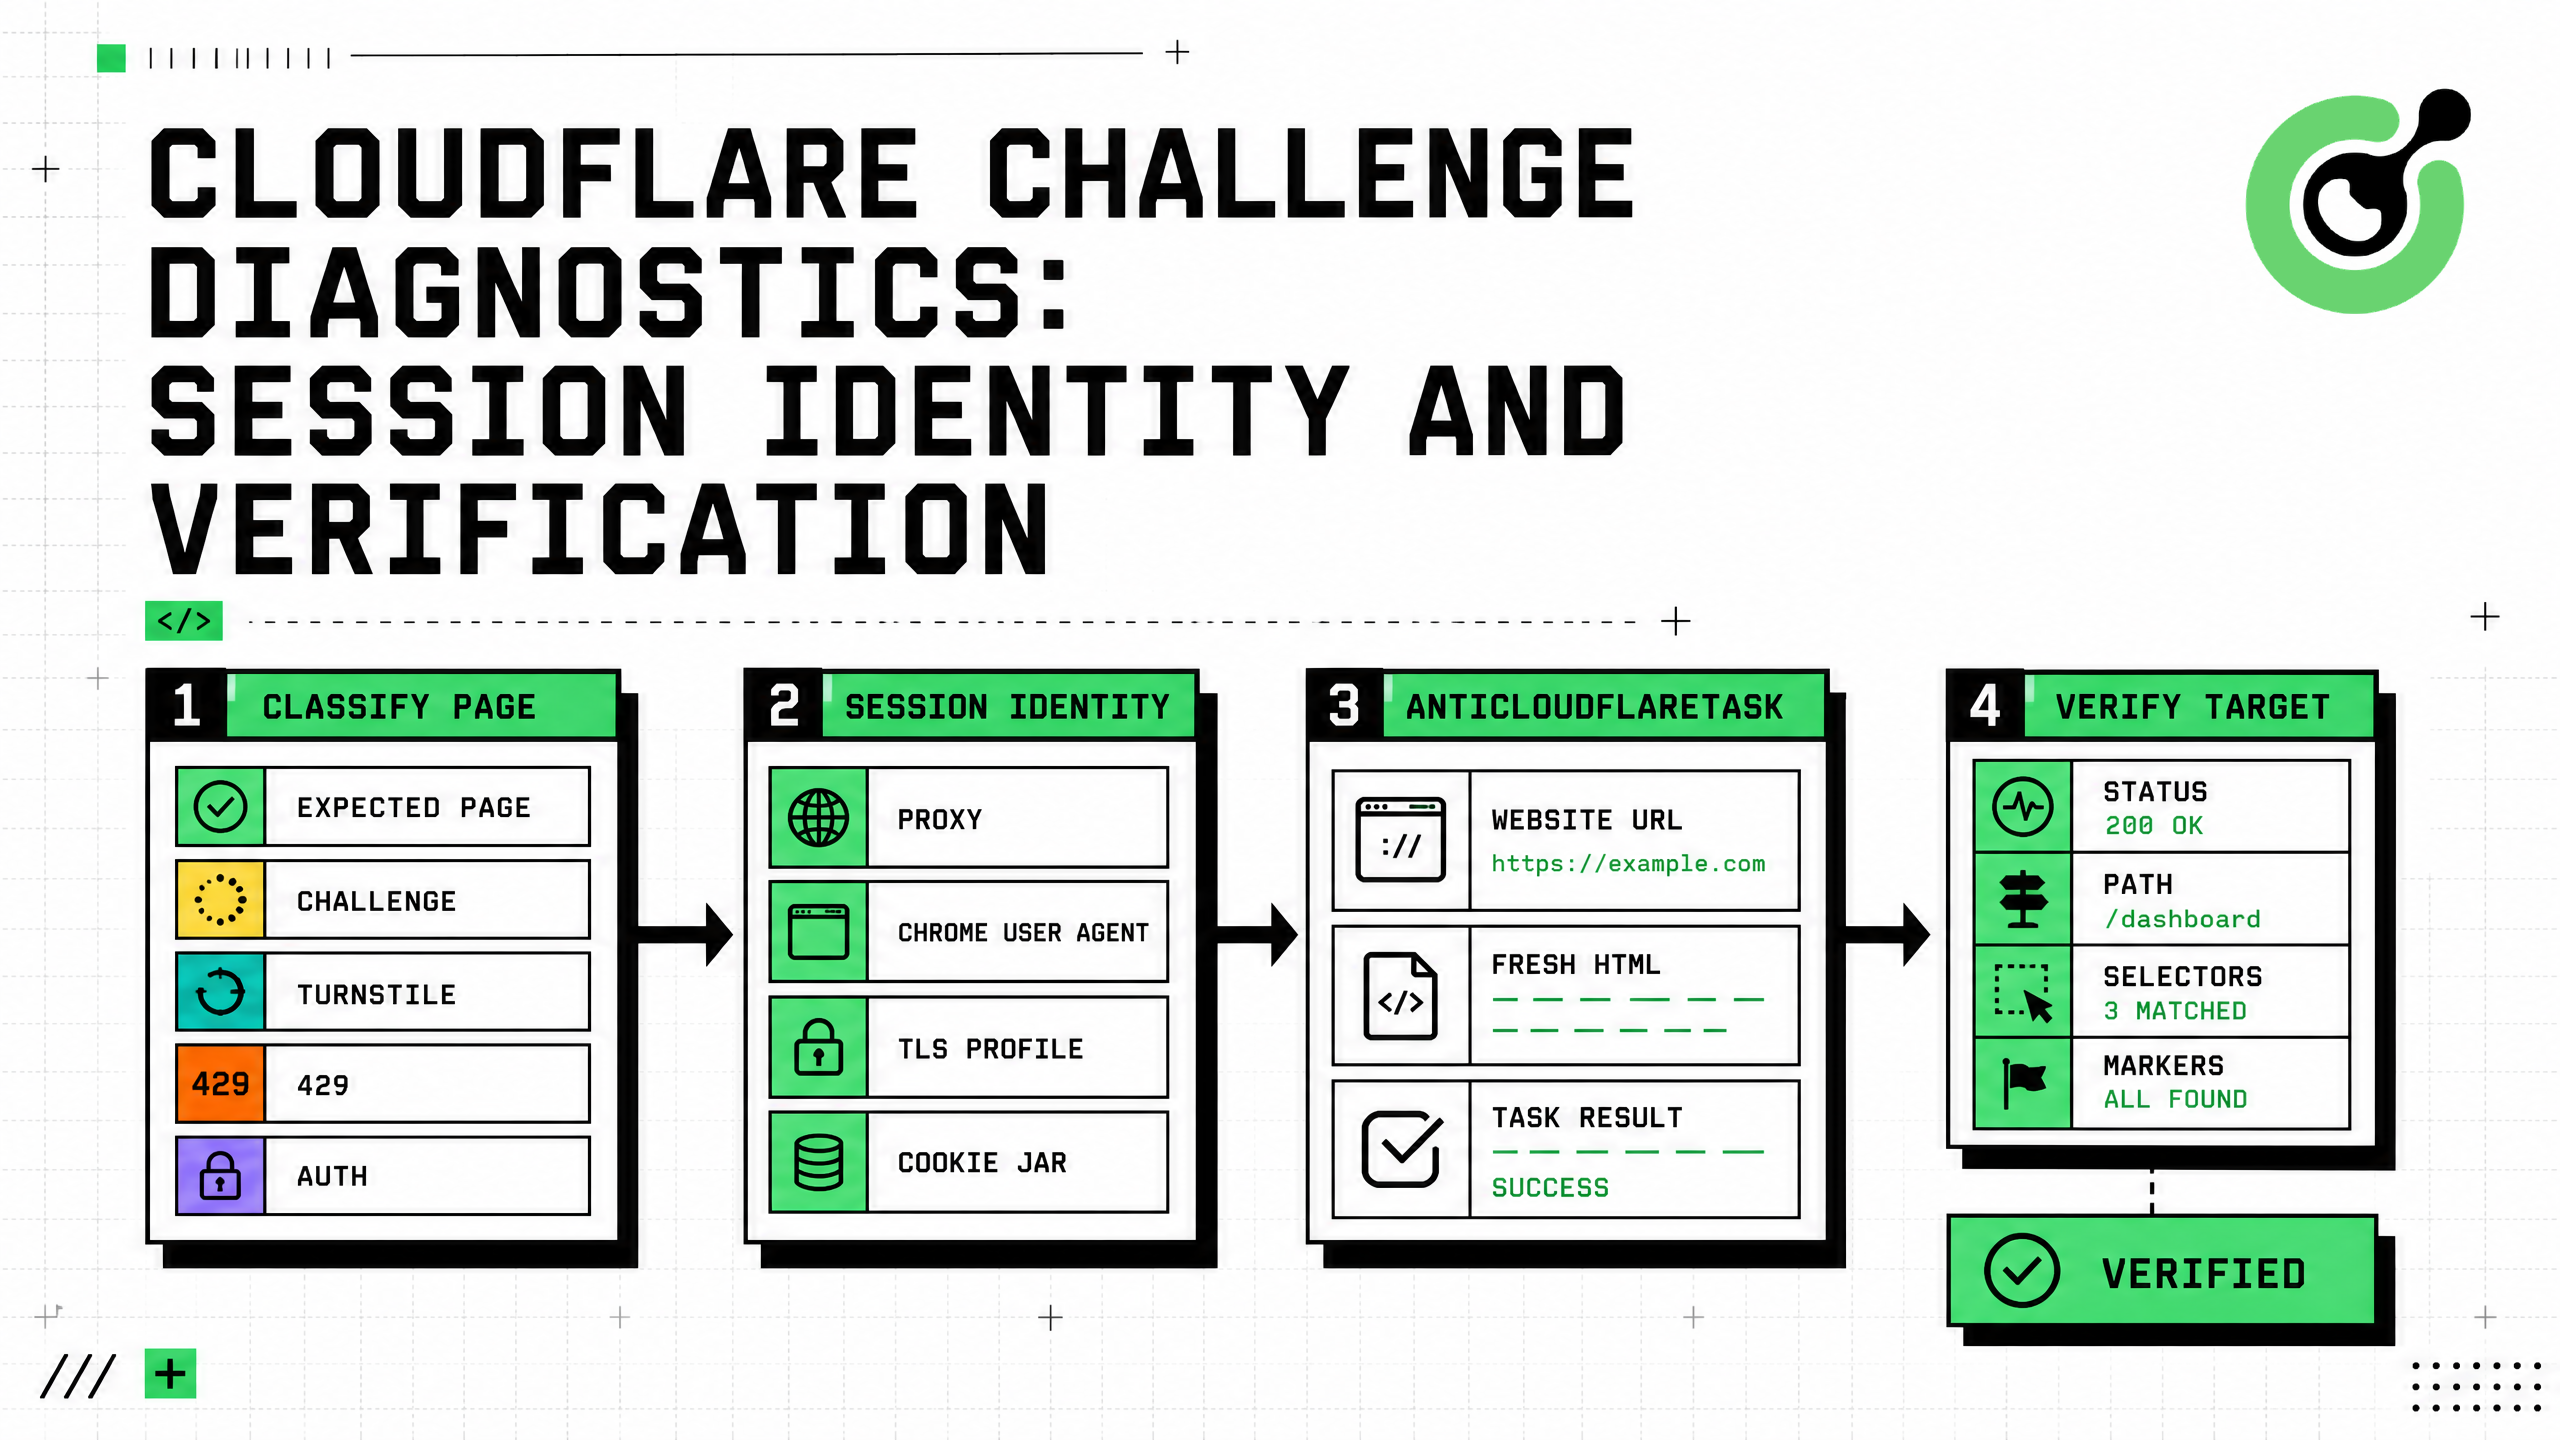
Cloudflareチャレンジ診断: セッションアイデンティティと検証
アンチクラウドフレアタスク、安定したプロキシおよびユーザー エージェントのアイデンティティ、新規のHTML、クリアランス処理、検証、およびセーフエラーを用いて、Cloudflareチャレンジフローを診断します。
Sora Fujimoto
31-Aug-2026
Cloudflareチャレンジの解決方法:不動産価格モニタリングのための
公式データセット、比較可能な観測データ、Cloudflareチャレンジの解決、証拠、および制御されたアラートを用いて、信頼性のある不動産価格モニタリングを構築します。
Sora Fujimoto
28-Aug-2026
クラウドフレアチャレンジの解決方法:イーコマース在庫モニタリング
信頼性の高いECサイト在庫モニタリングを構築するには、APIファーストのソーシング、Cloudflareチャレンジ復旧、セッション一貫性、在庫証拠、および安全なアラートを活用してください。
Sora Fujimoto
27-Aug-2026
無効なCloudflare Turnstileトークンとは何か:原因と解決策
無効なTurnstileトークンを修正するには、有効期限、サイトキー、アクション、CData、ブラウザの状態、サーバー検証、および制限されたCapSolverのリトライを確認してください。
Sora Fujimoto
11-Aug-2026
MCP CAPTCHAソルバー:Cloudflare Turnstile 統合ガイド
ポリシー制限付きのMCP Cloudflare TurnstileワークフローをCapSolver、制限付きリトライ、ロギングをマスキングしたセッションチェック、および結果の検証を含むように構築してください。
Sora Fujimoto
22-Jul-2026