




Diagnósticos do Desafio Cloudflare: Identidade e Verificação de Sessão
Adélia Cruz
How to use CapSolver
31-Aug-2026
TL;DR
- Primeiro distinga uma página de desafio do Cloudflare de Turnstile, limitação de taxa, autenticação, falha de rede e erro de aplicativo.
- Use a tarefa
AntiCloudflareTaskdocumentada com a URL de destino exata e um proxy estático ou sticky; mantenha o agente do Chrome suportado consistente. - Se o HTML do desafio for necessário, capture-o imediatamente da mesma sessão aprovada, em vez de de uma identidade de solicitação separada.
- Trate
cf_clearance, cookies, tokens, credenciais de proxy e HTML bruto como segredos de curta duração que não devem entrar em logs ou analytics. - Um resultado de tarefa pronto é apenas um sucesso intermediário. Verifique se a página de destino carregou e que o desafio não está mais presente.
Introdução
A diagnóstico de desafios do Cloudflare deve começar com a classificação de estado e identidade da sessão, não com a criação repetida de tarefas. Uma página protegida pode mostrar um desafio intersticial, widget Turnstile, resposta HTTP 429, bloqueio rígido, tela de autenticação, erro de origem ou uma página de aplicativo comum. Cada estado precisa de uma ação diferente. Para uma página de desafio suportada, a CapSolver documenta AntiCloudflareTask com a URL de destino exata, um proxy estático ou sticky e um agente do Chrome consistente; alguns sites também precisam de HTML do desafio fresco da mesma sessão. Os dados de clearance retornados devem então ser aplicados à mesma identidade de solicitação e validados contra a página de destino esperada. Este guia apresenta uma implementação genérica sem vincular o design a uma indústria, caso de uso ou framework de agente.
Comece com a Definição Correta do Problema
O Cloudflare descreve Desafios como mecanismos de segurança que avaliam sinais de navegador e cliente e podem solicitar interação mínima do usuário. Essa categoria ampla não deve ser confundida com toda resposta bloqueada ou incompleta.
Um fluxo de diagnóstico deve responder a quatro perguntas em ordem:
- O alvo está autorizado e dentro do escopo aprovado?
- Qual estado da página ou resposta foi realmente observado?
- O estado corresponde a um tipo de tarefa suportado pela CapSolver?
- A página de destino desejada carregou após a execução da tarefa?
O blog da CapSolver sobre Cloudflare contém material relacionado a produtos e implementação, enquanto a FAQ da CapSolver sobre resolução de CAPTCHA explica o ciclo de vida geral da tarefa.
Distinga os Principais Estados de Resposta
| Estado | Evidência típica | Próxima ação correta |
|---|---|---|
| Página esperada | Título conhecido, rota, seletor semântico ou esquema de resposta | Analisar ou continuar |
| Página de desafio do Cloudflare | "Aguarde um momento...", script de desafio, marcadores do Cloudflare | Classificar o escopo e considerar AntiCloudflareTask |
| Widget Turnstile | Script Turnstile, chave do site, contêiner do widget | Use o caminho documentado para tarefa Turnstile |
| Limitação de taxa | HTTP 429, Retry-After, resposta de cota |
Esperar e reduzir a taxa de solicitação |
| Autenticação necessária | Formulário de login, 401, estado de sessão expirada | Autenticar por meio do fluxo aprovado |
| Bloqueio rígido | 403 persistente sem evidência de desafio suportado | Parar e revisar a política de acesso ou identidade de rede |
| Erro de origem ou rede | 5xx, DNS, TLS, timeout | Corrigir infraestrutura; não criar tarefa de desafio |
| Página desconhecida | Layout ou semântica não correspondem a estados conhecidos | Armazenar diagnósticos redigidos e solicitar revisão |
Um serviço de desafio nunca deve ser usado como resposta universal para cada 403 ou página vazia.
Crie um Classificador de Páginas Determinístico
python
from dataclasses import dataclass

@dataclass(frozen=True)
class HttpObservation:
    url: str
    status_code: int
    title: str
    html: str
    headers: dict[str, str]


def classify_observation(obs: HttpObservation) -> str:
    title = obs.title.lower()
    html = obs.html.lower()

    if obs.status_code == 429:
        return "RATE_LIMIT"

    if obs.status_code >= 500:
        return "ORIGIN_OR_NETWORK_ERROR"

    if "challenges.cloudflare.com/turnstile" in html:
        return "TURNSTILE_WIDGET"

    challenge_markers = (
        "just a moment" in title
        or "challenge-platform" in html
        or "cf-chl-" in html
    )
    if challenge_markers:
        return "CLOUDFLARE_CHALLENGE"

    if 'type="password"' in html or obs.status_code == 401:
        return "AUTH_REQUIRED"

    if obs.status_code == 200 and 'data-page="expected"' in html:
        return "EXPECTED_PAGE"

    if obs.status_code == 403:
        return "HARD_BLOCK"

    return "UNKNOWN_PAGE"
Use marcadores de sucesso específicos do alvo. Um HTTP 200 genérico não é suficiente porque páginas de desafio, erro e consentimento também podem retornar 200.
A FAQ de erros da CapSolver é útil para manter erros do provedor separados de erros de estado da página.
Defina a Tupla de Identidade da Sessão
A clearance do Cloudflare está associada ao contexto do visitante e dispositivo. A documentação de clearance do Cloudflare afirma que cf_clearance está vinculado a um visitante e dispositivo específicos e pode ser reavaliado conforme o comportamento da sessão muda.
Represente explicitamente a identidade da solicitação:
python
from dataclasses import dataclass

@dataclass(frozen=True)
class SessionIdentity:
    session_id: str
    proxy_profile: str
    chrome_user_agent: str
    tls_profile: str
    cookie_jar_id: str
    target_host: str
A tupla deve permanecer estável desde a observação inicial até a execução da tarefa e verificação da página de destino.
Registre Alvos Aprovados no Servidor
python
from dataclasses import dataclass
from urllib.parse import urlparse

@dataclass(frozen=True)
class TargetPolicy:
    target_id: str
    hostname: str
    allowed_path_prefixes: tuple[str, ...]
    purpose: str
    proxy_profile: str
    max_attempts: int = 1

TARGETS = {
    "docs_demo": TargetPolicy(
        target_id="docs_demo",
        hostname="approved.example.com",
        allowed_path_prefixes=("/public/", "/test/"),
        purpose="validação de integração autorizada",
        proxy_profile="approved_static_us",
    )
}


def resolve_target(target_id: str, url: str) -> TargetPolicy:
    policy = TARGETS.get(target_id)
    if policy is None:
        raise PermissionError("Alvo desconhecido")

    parsed = urlparse(url)
    if parsed.scheme != "https":
        raise PermissionError("HTTPS é necessário")
    if parsed.hostname != policy.hostname:
        raise PermissionError("Host fora do escopo aprovado")
    if not any(parsed.path.startswith(p) for p in policy.allowed_path_prefixes):
        raise PermissionError("Caminho fora do escopo aprovado")
    return policy
Não permita que um chamador não confiável forneça uma URL, proxy ou propósito arbitrário.
Entenda o Contrato da AntiCloudflareTask
A documentação de desafio do Cloudflare da CapSolver define AntiCloudflareTask.
| Campo | Obrigatório | Regra de diagnóstico |
|---|---|---|
type |
Sim | Deve ser AntiCloudflareTask |
websiteURL |
Sim | Página de destino exata aprovada |
proxy |
Sim | Proxy estático ou sticky usado para a sessão |
userAgent |
Condicional | Mesmo agente do Chrome suportado usado pelo cliente |
html |
Condicional | HTML do desafio fresco da mesma sessão |
A documentação também exige uma biblioteca de solicitação com suporte TLS e recomenda manter a sessão de proxy por pelo menos três minutos.
A página de produtos da CapSolver ajuda a distinguir as categorias de tarefa suportadas do Cloudflare e Turnstile.
Crie a Tarefa a partir de Dados de Sessão Confiáveis
python
import os
import capsolver

capsolver.api_key = os.environ["CAPSOLVER_API_KEY"]

PROXY_VAULT = {
    "approved_static_us": os.environ["APPROVED_STATIC_PROXY"],
}


def build_task(
    policy: TargetPolicy,
    identity: SessionIdentity,
    target_url: str,
    fresh_html: str | None,
) -> dict:
    if identity.proxy_profile != policy.proxy_profile:
        raise ValueError("Proxy da sessão não corresponde à política do alvo")
    if identity.target_host != policy.hostname:
        raise ValueError("Host da sessão não corresponde à política do alvo")

    task = {
        "type": "AntiCloudflareTask",
        "websiteURL": target_url,
        "proxy": PROXY_VAULT[identity.proxy_profile],
        "userAgent": identity.chrome_user_agent,
    }
    if fresh_html:
        task["html"] = fresh_html
    return task
O construtor de tarefas lê credenciais de rede de um cofre protegido. Ele não retorna-as para um chamador ou escreve-as em um rastreamento.
Capture HTML da Mesma Sessão
Quando o HTML for necessário, capture-o imediatamente após o classificador identificar o desafio.
python
from datetime import datetime, timezone

@dataclass(frozen=True)
class ChallengeDocument:
    session_id: str
    target_url: str
    body: str
    status_code: int
    captured_at: str

async def capture_challenge_document(client, identity, target_url):
    response = await client.get(
        target_url,
        session_id=identity.session_id,
        proxy_profile=identity.proxy_profile,
        user_agent=identity.chrome_user_agent,
        tls_profile=identity.tls_profile,
        cookie_jar_id=identity.cookie_jar_id,
    )
    observation = HttpObservation(
        url=str(response.url),
        status_code=response.status_code,
        title=extract_title(response.text),
        html=response.text,
        headers=dict(response.headers),
    )
    if classify_observation(observation) != "CLOUDFLARE_CHALLENGE":
        raise ValueError("A resposta não é uma página de desafio reconhecida")

    return ChallengeDocument(
        session_id=identity.session_id,
        target_url=target_url,
        body=response.text,
        status_code=response.status_code,
        captured_at=datetime.now(timezone.utc).isoformat(),
    )
Não reutilize HTML capturado por outro proxy, agente de usuário, sessão ou URL de destino.
Execute a Tarefa da CapSolver
python
def solve_approved_challenge(
    target_id: str,
    target_url: str,
    identity: SessionIdentity,
    document: ChallengeDocument,
) -> dict:
    policy = resolve_target(target_id, target_url)

    if document.session_id != identity.session_id:
        raise ValueError("Documento e sessão não correspondem")
    if document.target_url != target_url:
        raise ValueError("Documento e URL de destino não correspondem")

    task = build_task(
        policy=policy,
        identity=identity,
        target_url=target_url,
        fresh_html=document.body,
    )
    solution = capsolver.solve(task)

    cookies = solution.get("cookies") or {}
    clearance = cookies.get("cf_clearance") or solution.get("token")
    returned_user_agent = solution.get("userAgent") or identity.chrome_user_agent

    if not clearance:
        raise RuntimeError("Resultado da tarefa não contém dados de clearance")

    return {
        "cookies": cookies,
        "user_agent": returned_user_agent,
    }
Não imprima solution. Extraia apenas os campos necessários para a próxima solicitação.
Aplicar Clearance ao Jar de Cookies Existente
python
async def apply_clearance(client, identity: SessionIdentity, result: dict):
    for name, value in result["cookies"].items():
        await client.set_cookie(
            cookie_jar_id=identity.cookie_jar_id,
            domain=identity.target_host,
            name=name,
            value=value,
            secure=True,
        )

    await client.set_user_agent(
        session_id=identity.session_id,
        user_agent=result["user_agent"],
    )
Use o host e escopo de cookie exatos exigidos pelo alvo aprovado. Não copie o cookie para domínios não relacionados ou outra máquina.
Verificar a Página de Destino
python
@dataclass(frozen=True)
class VerificationRule:
    expected_status: int
    required_selectors: tuple[str, ...]
    forbidden_markers: tuple[str, ...]
    expected_path_prefix: str

async def verify_target_page(
    client,
    identity: SessionIdentity,
    target_url: str,
    rule: VerificationRule,
) -> dict:
    response = await client.get(
        target_url,
        session_id=identity.session_id,
        proxy_profile=identity.proxy_profile,
        user_agent=identity.chrome_user_agent,
        tls_profile=identity.tls_profile,
        cookie_jar_id=identity.cookie_jar_id,
    )

    parsed = urlparse(str(response.url))
    body = response.text.lower()

    status_ok = response.status_code == rule.expected_status
    path_ok = parsed.path.startswith(rule.expected_path_prefix)
    markers_ok = not any(marker.lower() in body for marker in rule.forbidden_markers)
    selectors_ok = all(selector_in_html(response.text, selector) for selector in rule.required_selectors)

    return {
        "verified": status_ok and path_ok and markers_ok and selectors_ok,
        "status_ok": status_ok,
        "path_ok": path_ok,
        "markers_ok": markers_ok,
        "selectors_ok": selectors_ok,
    }
Um resultado de tarefa da CapSolver não é suficiente. O aplicativo deve continuar apenas após esta verificação retornar verified=True.
Use uma Máquina de Estados Limitada
python
from enum import Enum

class FlowState(str, Enum):
    OBSERVED = "OBSERVED"
    CLASSIFIED = "CLASSIFIED"
    TASK_CREATED = "TASK_CREATED"
    RESULT_READY = "RESULT_READY"
    PAGE_VERIFIED = "PAGE_VERIFIED"
    STOPPED = "STOPPED"

ALLOWED = {
    FlowState.OBSERVED: {FlowState.CLASSIFIED, FlowState.STOPPED},
    FlowState.CLASSIFIED: {FlowState.TASK_CREATED, FlowState.STOPPED},
    FlowState.TASK_CREATED: {FlowState.RESULT_READY, FlowState.STOPPED},
    FlowState.RESULT_READY: {FlowState.PAGE_VERIFIED, FlowState.STOPPED},
    FlowState.PAGE_VERIFIED: {FlowState.STOPPED},
}


def transition(current: FlowState, next_state: FlowState) -> FlowState:
    if next_state not in ALLOWED[current]:
        raise ValueError(f"Transição inválida: {current} -> {next_state}")
    return next_state
Permita uma tentativa de tarefa por estado de página observado. Se a verificação falhar, pare e solicite revisão, em vez de loop.
Classifique Erros Antes de Agir
A documentação de códigos de erro da CapSolver distingue erros de entrada, limite, timeout, proxy, conta, suporte e serviço temporário.
| Classe de erro | Exemplo | Ação |
|---|---|---|
| Entrada inválida | ERROR_INVALID_TASK_DATA |
Corrigir a construção da tarefa confiável |
| Limite de taxa | ERROR_RATE_LIMIT |
Esperar de acordo com a política |
| Timeout | ERROR_TASK_TIMEOUT |
Registrar tempo e parar ou revisar |
| Tarefa não suportada | ERROR_TASK_NOT_SUPPORTED |
Reclassificar o tipo de desafio |
| Não solucionável | ERROR_CAPTCHA_UNSOLVABLE |
Parar e revisar o estado da página |
| Proxy bloqueado | ERROR_PROXY_BANNED |
Identidade de rede aprovada |
| Conta/chave | ERROR_KEY_DENIED_ACCESS, ERROR_ZERO_BALANCE |
Corrigir configuração da conta |
| Serviço temporário | ERROR_SERVICE_UNAVALIABLE |
Aguardar e verificar status do provedor |
Não aplique a mesma regra de repetição para todos os erros.
Normalizar erros em categorias estáveis
python
ERROR_ACTIONS = {
    "ERROR_INVALID_TASK_DATA": "FIX_INPUT",
    "ERROR_RATE_LIMIT": "WAIT",
    "ERROR_TASK_TIMEOUT": "REVIEW",
    "ERROR_TASK_NOT_SUPPORTED": "RECLASSIFY",
    "ERROR_CAPTCHA_UNSOLVABLE": "REVIEW",
    "ERROR_PROXY_BANNED": "REVIEW_NETWORK",
    "ERROR_KEY_DENIED_ACCESS": "FIX_ACCOUNT",
    "ERROR_ZERO_BALANCE": "FIX_ACCOUNT",
    "ERROR_SERVICE_UNAVALIABLE": "BACKOFF",
}


def normalize_error(error_code: str | None) -> dict:
    code = error_code or "UNKNOWN_ERROR"
    return {
        "categoria": code,
        "ação": ERROR_ACTIONS.get(code, "OPERATOR_REVIEW"),
        "repetição_permitida": ERROR_ACTIONS.get(code) in {"WAIT", "BACKOFF"},
    }
A repetição deve ser permitida apenas por uma política confiável e apenas após a condição que causou o erro ter mudado ou o período de espera ter expirado.
Proteger materiais de sessão de curta duração
Trate os seguintes itens como segredos:
- Chave da API CapSolver;
- Credenciais do proxy;
cf_clearancee outros cookies;- Token de desafio;
- User agent completo quando faz parte de uma identidade de dispositivo;
- HTML do desafio bruto;
- Estado da armazenagem do navegador;
- URLs de destino não restritas contendo identificadores.
python
SAFE_EVENT_FIELDS = {
    "event",
    "target_id",
    "state",
    "error_category",
    "attempt_count",
    "duration_ms",
    "verified",
    "observed_at",
}


def redact_event(event: dict) -> dict:
    return {
        key: event[key]
        for key in SAFE_EVENT_FIELDS
        if key in event
    }
Armazene um hash ou referência interna para evidências sensíveis, em vez de colocar as próprias evidências em logs gerais.
A Perguntas Frequentes do CapSolver fornece orientação operacional adicional, e a página de status do CapSolver ajuda a distinguir falhas de aplicativo de disponibilidade de provedor.
Adicionar observabilidade útil
python
from datetime import datetime, timezone
from time import monotonic


def diagnostic_event(
    target_id: str,
    state: str,
    attempt_count: int,
    verified: bool,
    started_at: float,
    error_category: str | None = None,
) -> dict:
    return redact_event({
        "event": "cloudflare_challenge_diagnostic",
        "target_id": target_id,
        "state": state,
        "attempt_count": attempt_count,
        "duration_ms": int((monotonic() - started_at) * 1000),
        "verified": verified,
        "error_category": error_category,
        "observed_at": datetime.now(timezone.utc).isoformat(),
    })
Monitore a taxa de desafios, taxa de tarefas bem-sucedidas, taxa de página verificada, distribuição de erros, tempo para estar pronto e volume de revisão de operador. Não monitore segredos.
Testar o caminho de diagnóstico
python
import pytest

@pytest.mark.parametrize(
    "status,title,html,expected",
    [
        (429, "Limitado por taxa", "", "RATE_LIMIT"),
        (403, "Aguarde um momento...", "cf-chl-test", "CLOUDFLARE_CHALLENGE"),
        (200, "Entrar", '<input type="password">', "AUTH_REQUIRED"),
        (500, "Erro do servidor", "", "ORIGIN_OR_NETWORK_ERROR"),
    ],
)
def test_classifier(status, title, html, expected):
    observation = HttpObservation(
        url="https://approved.example.com/test/",
        status_code=status,
        title=title,
        html=html,
        headers={},
    )
    assert classify_observation(observation) == expected
Teste também correspondências de identidade incorretas:
python
def test_task_rejects_proxy_profile_mismatch():
    policy = TARGETS["docs_demo"]
    identity = SessionIdentity(
        session_id="session-1",
        proxy_profile="wrong_profile",
        chrome_user_agent="Mozilla/5.0 ... Chrome/141.0.0.0 ...",
        tls_profile="chrome141",
        cookie_jar_id="jar-1",
        target_host="approved.example.com",
    )

    with pytest.raises(ValueError):
        build_task(
            policy=policy,
            identity=identity,
            target_url="https://approved.example.com/test/",
            fresh_html="<html>Aguarde um momento...</html>",
        )
Por fim, teste se a redação exclui cookies, HTML, chaves e valores de proxy.
Código Bônus: Use o código WEBS no Painel do CapSolver para obter um bônus adicional de 5% em cada recarga.
Resumo da Comparação
| Padrão | Consistência de identidade | Clareza de diagnóstico | Recomendação |
|---|---|---|---|
| Repetir a cada 403 | Baixa | Baixa | Evitar |
| Criar uma tarefa a partir de campos fornecidos pelo chamador | Variável | Baixa | Evitar |
| Classificar, construir a partir de identidade confiável e depois verificar | Alta | Alta | Preferido |
| Parar e solicitar revisão manual | Alta | Alta | Obrigatório para estados desconhecidos ou sensíveis |
O padrão preferido torna cada decisão explícita e testável.
Checklist de Produção
- Registre o host aprovado, caminho, propósito e perfil de proxy do lado do servidor.
- Classifique páginas esperadas, desafio, Turnstile, limite de taxa, autenticação, bloqueio rígido e erro de rede separadamente.
- Use
AntiCloudflareTaskapenas para uma página de desafio reconhecida e suportada. - Mantenha o proxy estático ou fixo, user agent do Chrome suportado, perfil TLS e jar de cookies consistentes.
- Capture o HTML do desafio da mesma sessão quando necessário.
- Mantenha os dados de clearance em armazenamento de segredos de curta duração.
- Verifique a página de destino exata após aplicar os dados da sessão.
- Permita apenas uma tentativa de tarefa por estado observado.
- Mapeie códigos de erro para ações distintas.
- Registre apenas campos operacionais redatados.
- Teste classificação de página, correspondência de identidade, validação de resultado e redação de segredos.
A página de produtos do CapSolver pode ajudar a confirmar categorias de desafio suportadas antes da implementação.
Uso Responsável
Use o tratamento de desafio Cloudflare apenas em sites que você possua, teste ou tenha permissão explícita para acessar. Respeite os termos, limites de taxa, limites de autenticação, obrigações de privacidade e políticas de origem. A capacidade de processamento de desafio não concede direitos de acesso. Parem quando o alvo for desconhecido, a página for sensível, a identidade for inconsistente ou a verificação falhar. Mantenha ações consecutivas atrás de uma política separada e etapa de aprovação humana.
Conclusão
A diagnóstico de desafio Cloudflare deve ser um pipeline estrito: autorize o alvo, classifique a página observada, construa AntiCloudflareTask a partir de identidade de sessão confiável, mantenha o proxy e o user agent do Chrome suportado consistentes, aplique materiais de clearance de curta duração ao mesmo jar de cookies e verifique a página desejada. Erros devem ser categorizados em vez de repetidos cegamente, e segredos nunca devem entrar em logs ou contexto de modelo.
Inicie uma implementação aprovada com CapSolver, valide-a em uma página de teste controlada e adicione testes de estado, identidade, verificação e redação antes do uso em produção.
Perguntas Frequentes
Qual tipo de tarefa do CapSolver lida com uma página de desafio Cloudflare?
Use a AntiCloudflareTask documentada quando a página observada corresponder a um desafio Cloudflare suportado e o alvo estiver autorizado.
Um proxy é necessário?
Sim. O CapSolver documenta um proxy estático ou fixo para esta tarefa. Mantenha essa identidade de rede consistente durante a verificação.
Quando o campo html deve ser incluído?
Inclua o HTML do desafio fresco quando o alvo exigir. Capture o HTML com o mesmo proxy fixo, user agent do Chrome suportado, jar de cookies e URL de alvo.
O resultado de uma tarefa pronta é suficiente?
Não. Aplique os materiais de sessão retornados à mesma identidade de solicitação e verifique se a página de destino esperada carregou sem marcadores de desafio.
O que deve acontecer após um erro desconhecido ou verificação falha?
Pare, mantenha diagnósticos redatados e solicite revisão de operador. Não crie um loop de repetição sem limites.
Declaração de Conformidade: As informações fornecidas neste blog são apenas para fins informativos. A CapSolver está comprometida em cumprir todas as leis e regulamentos aplicáveis. O uso da rede CapSolver para atividades ilegais, fraudulentas ou abusivas é estritamente proibido e será investigado. Nossas soluções de resolução de captcha melhoram a experiência do usuário enquanto garantem 100% de conformidade ao ajudar a resolver dificuldades de captcha durante a coleta de dados públicos. Incentivamos o uso responsável de nossos serviços. Para mais informações, visite nossos Termos de Serviço e Política de Privacidade.
Mais
Lista de Verificação da API do Solucionador de Portões: Entradas, Tokens e Validação
Avalie uma API de solucionador de Turnstile pelas suas entradas documentadas, resposta de token, limite de validação e casos de teste controlados antes de adicioná-la ao seu fluxo de trabalho.
Adélia Cruz
16-Sep-2026
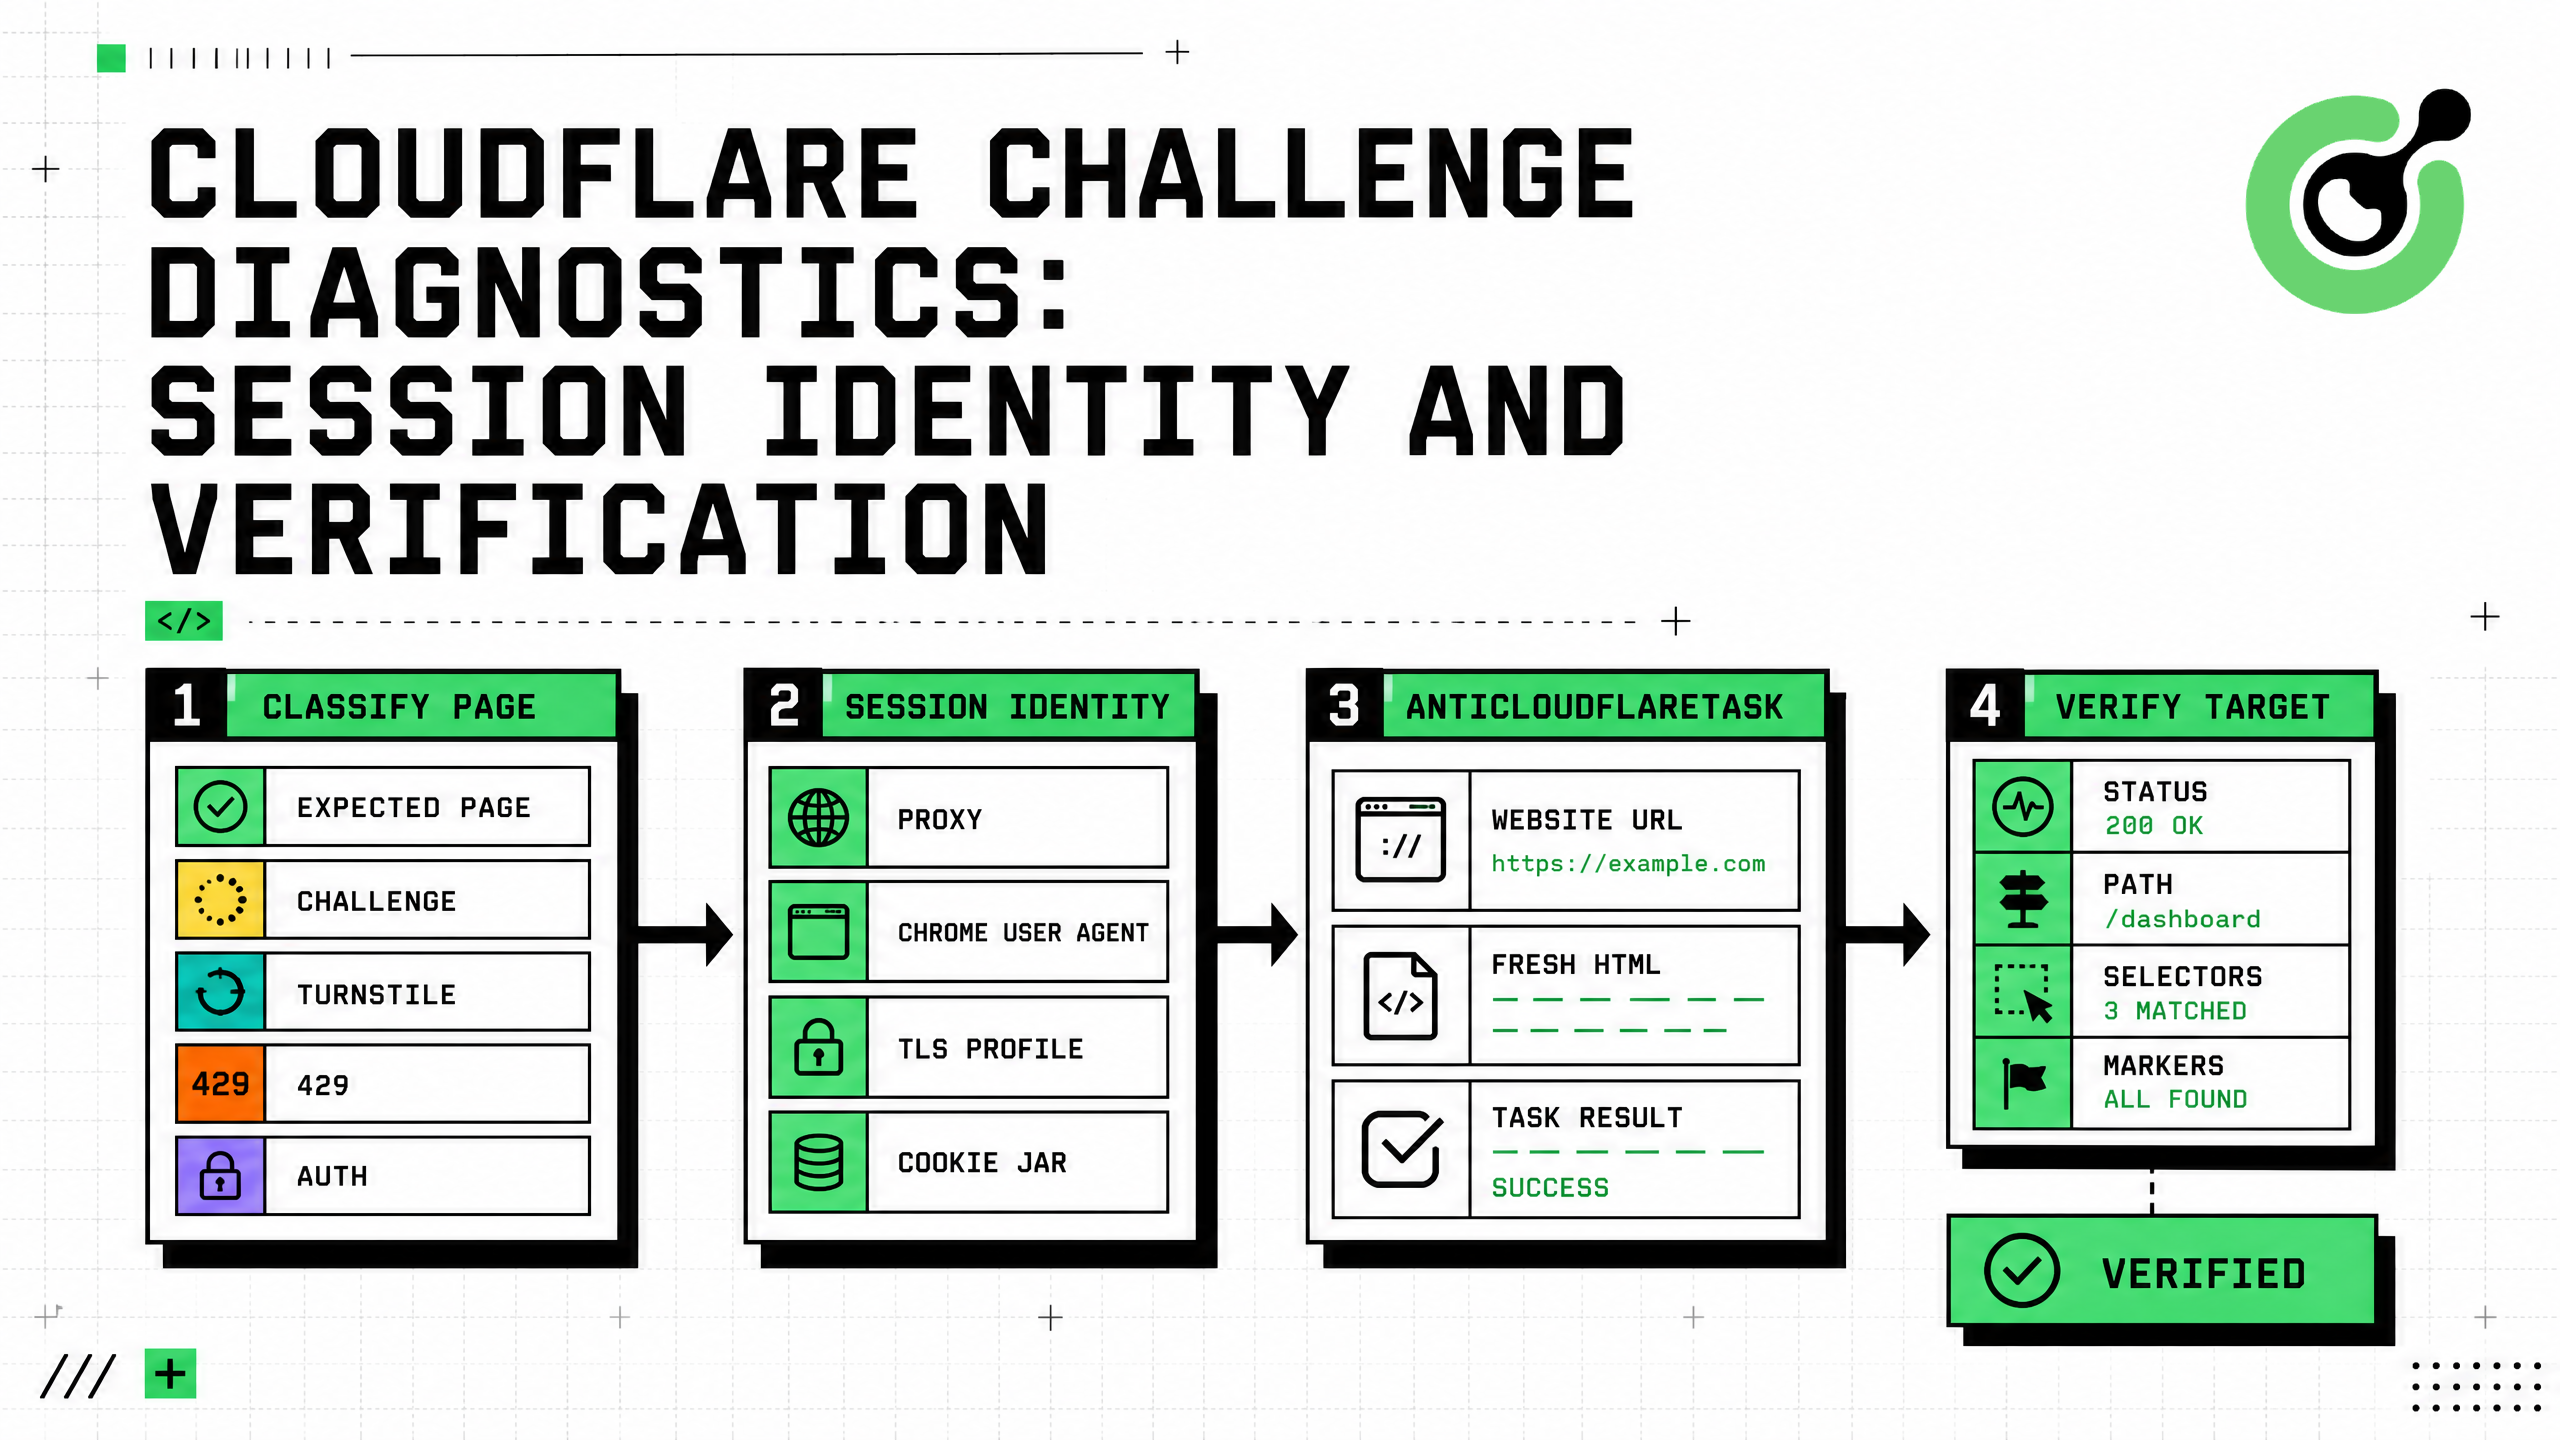
Diagnósticos do Desafio Cloudflare: Identidade e Verificação de Sessão
Diagnose os fluxos de desafio do Cloudflare com o AntiCloudflareTask, proxy estável e identidade do agente de usuário, HTML atualizado, tratamento de limpeza, validação e erros seguros.
Adélia Cruz
31-Aug-2026
Como resolver o desafio do Cloudflare para o monitoramento de preços de imóveis
Construa um monitoramento confiável dos preços dos imóveis com conjuntos de dados oficiais, observações comparáveis, resolução de desafios do Cloudflare, evidências e alertas controlados.
Adélia Cruz
28-Aug-2026
Como resolver o desafio do Cloudflare para o monitoramento de estoque de comércio eletrônico
Construa um monitoramento de estoque de comércio eletrônico confiável com sourcing baseado em API, recuperação de desafios da Cloudflare, consistência de sessão, evidência de estoque e alertas confiáveis.
Adélia Cruz
27-Aug-2026
O que é Token Inválido do Cloudflare Turnstile: Causas e Soluções
Corrigir um token de Turnstile inválido verificando expiração, chave do site, ação, cdata, estado do navegador, verificação do servidor e retries limitados do CapSolver.
Adélia Cruz
11-Aug-2026
Solução de CAPTCHA MCP: Guia de Integração do Cloudflare Turnstile
Construa um fluxo de trabalho MCP Cloudflare Turnstile com gate de política, retries limitados, logs redatados, verificações de sessão e validação de resultados.
Adélia Cruz
22-Jul-2026