




人工智能SEO工作流程中的搜索意图漂移监控

Ethan Collins
How to use CapSolver
31-Aug-2026
TL;DR
- 搜索意图漂移监控通过跨时间比较稳定的查询组来检测;它不会从单个排名或单个模型响应中推断意图。
- 使用自有Google Search Console数据中的点击、展示和位置,然后添加经过批准的API或用户提供的导出的受控SERP观察结果。
- 从多个信号中对意图进行标记:结果类型、主导页面原型、SERP特性、修饰符和查询到页面的行为。
- 在更改内容或内部链接之前,需要满足持久性、覆盖范围和置信度阈值。
- 将自动化建议与发布决策分开,并为每个意图变化警报保留证据。
引言
搜索意图漂移监控检测当结果集和与查询相关的用户行为变化到足以使现有页面不再满足主导需求的程度。一个可靠的系统不会要求AI模型从单个搜索页面猜测。它结合自有Search Console趋势、受控SERP快照、页面原型、特性变化和查询修饰符,然后在向SEO团队发出警报之前应用持久性和置信度规则。这种方法对于常青指南、程序化页面、比较内容、产品类别和快速变化的主题尤其有用。本指南解释了证据模型、查询组、Search Console数据摄入、批准的SERP收集、意图分类法、相似性度量、置信度评分、变化确认、代理安全工具、质量保证和负责任的自动化。
精确定义搜索意图漂移
搜索意图漂移是指稳定查询组的结果环境和用户行为所暗示的主导任务的持续变化。例如:
- 信息类结果被产品分类页面取代;
- 产品评论被第一方产品页面取代;
- 新鲜新闻结果取代常青解释性内容;
- 本地套餐成为之前全国性查询的主导结果;
- 视频或论坛结果占据更多可见结果集;
- 品牌查询从比较性变为导航性;
- 一个自有页面在结果特性变化后获得展示但失去点击。
搜索意图漂移监控自动化不应将普通的排名波动标记为意图变化。排名、特性存在和意图是相关但不同的。
CapSolver自动化博客涵盖了相关的定期数据工作流,而CapSolver网页抓取常见问题解答提供了对允许的公共网页观察的指导。
使用双层证据模型
最强大的系统结合了第一方性能和受控结果观察。
| 证据层 | 示例 | 可以显示的内容 | 主要限制 |
|---|---|---|---|
| 自有性能 | 展示次数、点击次数、点击率、位置、页面、设备、国家 | 用户如何到达自有页面 | 无法显示完整的结果集 |
| 受控SERP观察 | 结果类型、URL、标题、特性、页面原型 | 搜索环境的外观 | 覆盖范围和本地化取决于收集方法 |
| 内容库存 | 页面类型、模板、新鲜度、结构化数据、主题实体 | 网站当前提供的内容 | 无法证明当前需求 |
| 人工审核 | 查询含义、业务背景、风险 | 最终解释 | 更慢且容量有限 |
Google的Search Console概述指出,Search Analytics报告为自有网站提供查询、展示次数、点击次数和位置。将其作为第一方信号使用,而不是完整的竞争对手数据集。
构建稳定的查询组
不要在没有上下文的情况下监控孤立的关键词。按稳定业务问题分组查询并保留原始查询。
python
from dataclasses import dataclass

@dataclass(frozen=True)
class QueryCohort:
    cohort_id: str
    market: str
    language: str
    device: str
    canonical_topic: str
    queries: tuple[str, ...]
    owned_page_group: tuple[str, ...]
    business_purpose: str
示例:
python
cohort = QueryCohort(
    cohort_id="captcha-api-comparison-us-en-desktop",
    market="US",
    language="en",
    device="DESKTOP",
    canonical_topic="captcha api comparison",
    queries=(
        "captcha api comparison",
        "compare captcha solving api",
        "captcha service comparison",
    ),
    owned_page_group=("/products/", "/blog/ai/"),
    business_purpose="content planning",
)
在时间序列比较中保持市场、语言和设备固定。
提取自有Search Console数据
Google的Search Analytics API文档指出,查询方法需要日期范围,支持过滤和分组维度,并可能返回顶部行而不是所有行。在每次提取时存储覆盖范围备注。
python
from googleapiclient.discovery import build
from google.oauth2 import service_account

SCOPES = ["https://www.googleapis.com/auth/webmasters.readonly"]

credentials = service_account.Credentials.from_service_account_file(
    "search-console-reader.json",
    scopes=SCOPES,
)
service = build("searchconsole", "v1", credentials=credentials)


def search_console_rows(
    site_url: str,
    start_date: str,
    end_date: str,
    row_limit: int = 25000,
) -> list[dict]:
    body = {
        "startDate": start_date,
        "endDate": end_date,
        "dimensions": ["query", "page", "country", "device"],
        "rowLimit": row_limit,
        "dataState": "final",
    }
    response = service.searchanalytics().query(
        siteUrl=site_url,
        body=body,
    ).execute()
    return response.get("rows", [])
保持凭证只读并放在笔记本或提示之外。
标准化Search Console观察
python
from dataclasses import dataclass

@dataclass
class SearchPerformance:
    query: str
    page: str
    country: str
    device: str
    clicks: float
    impressions: float
    ctr: float
    position: float
    start_date: str
    end_date: str
    extraction_id: str
    coverage_note: str


def normalize_sc_row(row: dict, start_date: str, end_date: str, run_id: str):
    keys = row.get("keys") or []
    if len(keys) != 4:
        raise ValueError("Unexpected Search Console dimensions")

    return SearchPerformance(
        query=keys[0],
        page=keys[1],
        country=keys[2],
        device=keys[3],
        clicks=float(row.get("clicks", 0)),
        impressions=float(row.get("impressions", 0)),
        ctr=float(row.get("ctr", 0)),
        position=float(row.get("position", 0)),
        start_date=start_date,
        end_date=end_date,
        extraction_id=run_id,
        coverage_note="API may prioritize top rows; not guaranteed exhaustive",
    )
除非确认了提取范围和数据可用性,否则不要将缺失行视为零需求。
CapSolver AI博客提供了将结构化证据输入受控AI工作流的相关示例。
通过批准的方法收集SERP证据
使用授权的SERP API、合作伙伴数据集或用户提供的导出。当源术语或访问方法不允许时,避免直接从搜索引擎收集。
python
from dataclasses import dataclass, field
from datetime import datetime, timezone

@dataclass
class SerpSnapshot:
    cohort_id: str
    query: str
    market: str
    language: str
    device: str
    source: str
    collection_id: str
    organic_results: list[dict]
    features: list[str]
    evidence_hash: str
    collected_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )
对于每个结果,保留:
- 排名;
- URL和主机名;
- 标题和可见片段;
- 结果类型;
- 页面原型;
- 显示时的发布或更新日期;
- 特性所有权;
- 证据参考。
在批准的收集源中遇到的挑战应作为基础设施事件处理。它绝不能被解释为缺失结果或意图变化。
CapSolver产品页面列出了授权工作流支持的挑战类别。
定义实用的意图分类法
python
INTENT_LABELS = {
    "INFORMATIONAL_GUIDE",
    "TROUBLESHOOTING",
    "COMMERCIAL_COMPARISON",
    "TRANSACTIONAL_CATEGORY",
    "TRANSACTIONAL_PRODUCT",
    "NAVIGATIONAL_BRAND",
    "LOCAL_VISIT",
    "NEWS_FRESHNESS",
    "VIDEO_LEARNING",
    "COMMUNITY_DISCUSSION",
    "MIXED",
}
使用映射到内容决策的标签。避免数十个重叠的类别,这些类别审核人员无法一致应用。
首先确定性地对页面原型进行分类
python
from urllib.parse import urlparse


def classify_archetype(result: dict) -> str:
    url = result.get("url", "")
    title = result.get("title", "").lower()
    path = urlparse(url).path.lower()

    if any(part in path for part in ["/product/", "/products/"]):
        return "PRODUCT_OR_CATEGORY"
    if any(part in path for part in ["/compare", "/best-"]):
        return "COMPARISON"
    if any(word in title for word in ["how to", "guide", "tutorial"]):
        return "GUIDE"
    if any(part in path for part in ["/news/", "/press/"]):
        return "NEWS"
    if any(part in path for part in ["/forum/", "/community/"]):
        return "COMMUNITY"
    return "OTHER"
仅在模糊情况下使用AI分类器。发送最小的结果文本,要求结构化标签,并存储模型版本和提示版本。
构建特征向量
python
from collections import Counter


def snapshot_features(snapshot: SerpSnapshot) -> dict:
    top_results = snapshot.organic_results[:10]
    archetypes = Counter(
        item.get("archetype", "OTHER") for item in top_results
    )
    hosts = {urlparse(item["url"]).hostname for item in top_results}

    return {
        "archetype_share": {
            key: value / max(len(top_results), 1)
            for key, value in archetypes.items()
        },
        "hosts": hosts,
        "features": set(snapshot.features),
        "top_urls": {item["url"] for item in top_results},
    }
仅在市场、语言、设备、查询和收集方法匹配时比较快照。
测量结果集相似性
python
def jaccard(left: set, right: set) -> float:
    union = left | right
    if not union:
        return 1.0
    return len(left & right) / len(union)


def serp_change_metrics(previous: SerpSnapshot, current: SerpSnapshot) -> dict:
    old = snapshot_features(previous)
    new = snapshot_features(current)

    return {
        "url_similarity": jaccard(old["top_urls"], new["top_urls"]),
        "host_similarity": jaccard(old["hosts"], new["hosts"]),
        "feature_similarity": jaccard(old["features"], new["features"]),
        "previous_archetypes": old["archetype_share"],
        "current_archetypes": new["archetype_share"],
    }
仅低URL相似性可能反映排名波动。当页面原型和结果特性也变化时,意图证据更强。
检测原型移动
python
def archetype_delta(previous: dict, current: dict) -> dict:
    labels = set(previous) | set(current)
    return {
        label: round(current.get(label, 0) - previous.get(label, 0), 3)
        for label in labels
    }


def dominant_archetype(shares: dict) -> str:
    if not shares:
        return "UNKNOWN"
    return max(shares.items(), key=lambda item: item[1])[0]
例如,从60%的指南页面移动到60%的产品/类别页面比指南URL之间的交换更有意义。
添加Search Console行为
python
def performance_delta(previous: SearchPerformance, current: SearchPerformance):
    return {
        "impression_delta": current.impressions - previous.impressions,
        "click_delta": current.clicks - previous.clicks,
        "ctr_delta": current.ctr - previous.ctr,
        "position_delta": current.position - previous.position,
    }
仔细解释这些指标。CTR下降可能来自位置损失或新SERP特性,而不一定是用户需求的变化。
用多个信号对意图漂移进行评分
python
def intent_drift_score(metrics: dict, behavior: dict) -> dict:
    url_change = 1 - metrics["url_similarity"]
    host_change = 1 - metrics["host_similarity"]
    feature_change = 1 - metrics["feature_similarity"]

    old_dom = dominant_archetype(metrics["previous_archetypes"])
    new_dom = dominant_archetype(metrics["current_archetypes"])
    archetype_changed = float(old_dom != new_dom)

    score = (
        0.20 * url_change
        + 0.15 * host_change
        + 0.20 * feature_change
        + 0.35 * archetype_changed
        + 0.10 * min(abs(behavior["ctr_delta"]) * 5, 1)
    )

    return {
        "score": round(score, 3),
        "previous_dominant": old_dom,
        "current_dominant": new_dom,
        "archetype_changed": bool(archetype_changed),
    }
将权重视为起点假设。根据审查的历史案例进行校准,而不是作为普遍真理呈现。
要求持久性
python
def confirmed_drift(windows: list[dict], minimum_score: float = 0.55):
    if len(windows) < 3:
        return False

    recent = windows[-3:]
    high = [item for item in recent if item["score"] >= minimum_score]
    labels = {
        item["current_dominant"]
        for item in recent
        if item["current_dominant"] != "UNKNOWN"
    }

    return len(high) >= 2 and len(labels) == 1
搜索意图漂移监控自动化应要求新的主导原型在多个有效快照中持续存在。对于低流量或季节性查询,增加窗口。
创建证据丰富的警报
python
def build_drift_alert(cohort: QueryCohort, analysis: dict) -> dict:
    return {
        "event": "SEARCH_INTENT_DRIFT_CONFIRMED",
        "cohort_id": cohort.cohort_id,
        "topic": cohort.canonical_topic,
        "market": cohort.market,
        "device": cohort.device,
        "previous_intent": analysis["previous_dominant"],
        "current_intent": analysis["current_dominant"],
        "score": analysis["score"],
        "snapshot_ids": analysis["snapshot_ids"],
        "search_console_run_ids": analysis["search_console_run_ids"],
        "recommended_action": "human_content_review",
    }
警报应指向证据,而不是自动发布重写。
将意图事件与基础设施事件分开
| 事件 | 含义 | 操作 |
|---|---|---|
INTENT_DRIFT_CONFIRMED |
持续的原型和特性变化 | 内容策略师审查 |
RANK_VOLATILITY |
无意图证据的URL变化 | 继续监控 |
FEATURE_SHIFT |
SERP特性混合变化 | 审查CTR影响 |
GSC_COVERAGE_LIMITED |
提取可能仅包含前几行 | 记录覆盖率警告 |
SNAPSHOT_MISSING |
批准的来源未返回证据 | 来源操作队列 |
CHALLENGE_ENCOUNTERED |
收集来源提出了受支持的挑战 | 基础设施处理 |
PARSER_UNKNOWN |
快照格式已更改 | 数据质量队列 |
不要将缺失数据标记为意图漂移。
CapSolver错误常见问题解答帮助团队将来源和挑战失败与业务信号分开进行标准化。
给AI代理一个安全的分析工具
python
from dataclasses import dataclass

@dataclass(frozen=True)
class AnalysisCase:
    case_id: str
    cohort_id: str
    approved_purpose: str
    snapshot_ids: tuple[str, ...]
    search_console_run_ids: tuple[str, ...]

CASES: dict[str, AnalysisCase] = {}

async def analyze_search_intent_case(case_id: str) -> dict:
    """从存储的证据中分析预批准的搜索意图案例。"""
    case = CASES.get(case_id)
    if case is None:
        raise PermissionError("未知的分析案例")

    result = analysis_service.compute(case)
    return {
        "case_id": case.case_id,
        "status": result.status,
        "previous_intent": result.previous_intent,
        "current_intent": result.current_intent,
        "confidence": result.confidence,
        "evidence_references": result.evidence_references,
        "review_required": True,
    }
模型接收证据引用和分析结果,而不是搜索控制台凭据、无限制的URL、浏览器会话或原始私有导出。
将意图变化映射到内容决策
python
CONTENT_ACTIONS = {
    ("GUIDE", "COMPARISON"): "添加决策标准和比较表",
    ("GUIDE", "PRODUCT_OR_CATEGORY"): "审查类别或产品落地页适配性",
    ("EVERGREEN", "NEWS"): "添加新鲜度工作流或新闻配套页面",
    ("NATIONAL", "LOCAL"): "审查特定地区页面和本地证据",
    ("TEXT", "VIDEO"): "添加已验证的视频或视觉解释",
}
此映射生成审查提示。在未经编辑批准前不应更改生产页面。
测量项目质量
| 指标 | 定义 | 理想行为 |
|---|---|---|
| 快照有效性率 | 可比较的快照数除以计划快照数 | 高且稳定 |
| 群组覆盖率 | 具有有效GSC和SERP证据的查询 | 按市场/设备记录 |
| 审查员一致性 | 人类对意图标签的一致性 | 随着分类法清晰度提高 |
| 警报精确度 | 被判断为可操作的确认警报 | 在扩大规模前保持高值 |
| 错误变化率 | 由来源/解析器故障引起的警报 | 接近零 |
| 审查时间 | 警报到决策时间 | 在编辑SLA范围内 |
| 证据完整性 | 具有必需快照和提取ID的警报 | 100% |
搜索意图漂移监控自动化应优化准确且可审查的警报,而非最大警报数量。
附加代码:在CapSolver仪表板使用代码 WEBS,每次充值可额外获得5%的奖金。
对比总结
| 方法 | 上下文质量 | 可审计性 | 推荐角色 |
|---|---|---|---|
| 仅排名跟踪器 | 意图的低质量 | 中等 | 波动信号 |
| 仅搜索控制台 | 强大的自有行为 | 高 | 第三方性能层 |
| 一次实时SERP快照 | 中等 | 中等 | 诊断证据 |
| 持续SERP加GSC证据 | 高 | 高 | 意图变化监控 |
| 无存储证据的模型意见 | 低 | 低 | 避免使用 |
综合方法使搜索意图漂移监控对SEO、内容、数据和合规团队可解释。
生产检查清单
- 按市场、语言、设备和主题定义稳定的查询组。
- 使用只读搜索控制台凭据。
- 记录API覆盖限制和提取ID。
- 通过批准的方法收集SERP观察结果。
- 存储结果类型、URL、功能、原型和证据哈希。
- 仅比较等效快照。
- 需要多个意图信号和持久性。
- 将来源故障与意图事件分开。
- 每个内容建议都需人工审查。
- 根据已审查的历史案例重新校准阈值。
CapSolver网络抓取博客提供相关数据流水线指导,CapSolver术语表可帮助标准化挑战和自动化术语。
负责任使用
仅使用您有权访问的搜索控制台属性和允许预期监控的SERP数据源。最小化个人和账户数据,使用只读凭据,并遵守速率限制。不要将排名或推断的意图视为关于个人的证明。在编辑批准后进行自动内容更改、重定向、删除和发布决策。
结论
当结合自有性能、受控结果快照、页面原型、SERP功能、持久证据和人工审查时,搜索意图漂移监控才能有效。搜索控制台显示用户如何到达自有页面;批准的SERP观察显示结果环境的变化;确定性评分识别候选者;审查员决定内容响应。
使用CapSolver构建授权监控工作流,从少量有价值的查询组开始,并在扩展自动化前根据存储证据验证每个警报。
常见问题
排名下降是否等同于搜索意图漂移?
不。排名可能变化,而主要页面类型和用户需求保持稳定。通过原型、功能、结果集证据和行为确认意图变化。
搜索控制台能否显示完整的结果页面?
不能。它提供如查询、点击、展示、点击率和位置等自有性能数据。添加受控SERP观察以获取结果环境证据。
在触发警报前需要多少快照?
使用多个可比较的快照并要求持久性。具体窗口取决于查询量、波动性、季节性和业务风险。
AI是否应在警报后自动重写页面?
不。AI可以总结证据并提出选项,但编辑应审查查询组、结果集、业务目的和可能的副作用。
如果收集来源返回挑战或空页面怎么办?
记录基础设施事件并排除该快照以进行意图分析。缺失或无效来源数据不是意图变化的证据。
合规声明: 本博客提供的信息仅供参考。CapSolver 致力于遵守所有适用的法律和法规。严禁以非法、欺诈或滥用活动使用 CapSolver 网络,任何此类行为将受到调查。我们的验证码解决方案在确保 100% 合规的同时,帮助解决公共数据爬取过程中的验证码难题。我们鼓励负责任地使用我们的服务。如需更多信息,请访问我们的服务条款和隐私政策。
更多
CapSolver Python 核心 SDK 与 HTTP API 对比:你应该使用哪一个?
根据任务支持、页面访问、响应处理以及您的应用程序所承担的责任,选择CapSolver Python Core SDK或直接HTTP API。

Emma Foster
16-Sep-2026
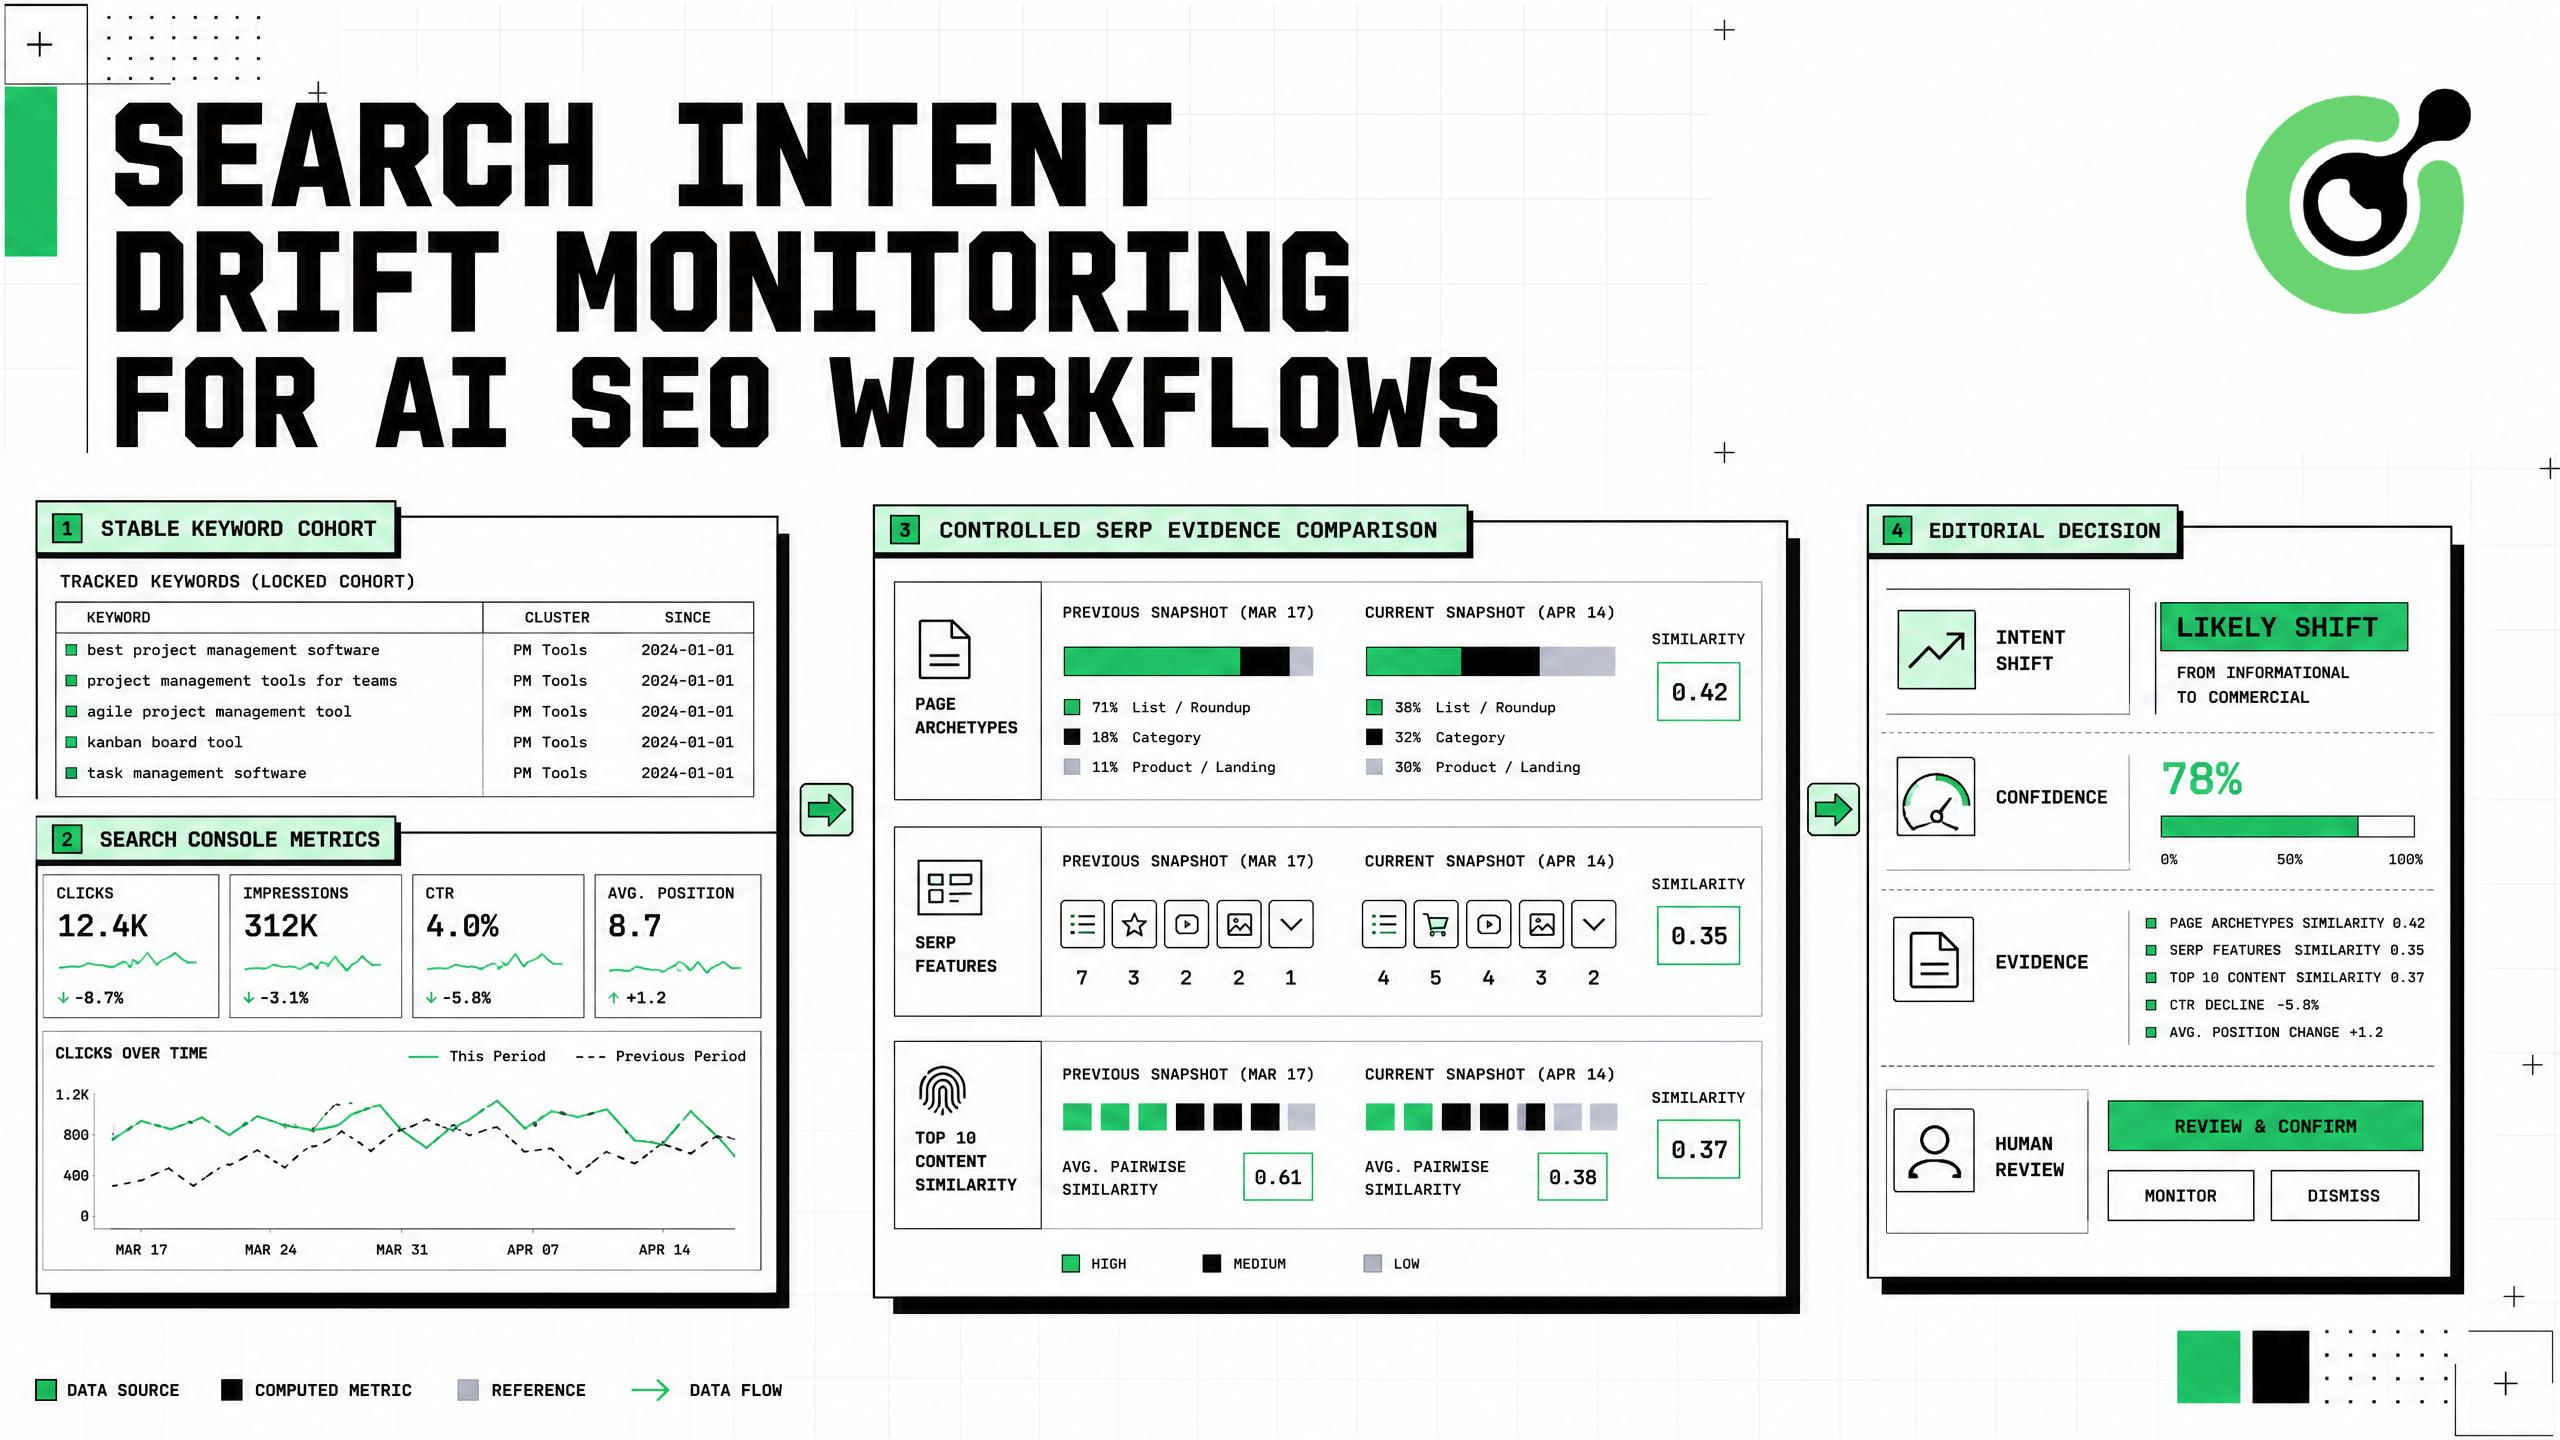
人工智能SEO工作流程中的搜索意图漂移监控
构建搜索意图漂移监控,利用搜索控制台数据、受控的SERP观察、意图标签、置信度门控、证据和安全自动化。
Ethan Collins
31-Aug-2026
如何将Gumloop验证码解决添加到网络工作流程
使用经过验证的HTTP协议构建Gumloop验证码解决服务,包含受控恢复分支、重试预算、浏览器状态检查和人工备用方案。
Ethan Collins
21-Aug-2026
如何将验证码解决工具添加到表单自动化工作流程中
表单自动化验证码解决程序是授权表单工作流中的错误恢复组件,而不是绕过授权的捷径。CapSolver可以通过文档化的任务API提供reCAPTCHA解决方案,同时您的应用程序将保留输入、浏览器上下文、同意和最终提交规则。最安全的流程是检测、快照、创建一个任务、在截止日期前轮询、在同一个会话中应用结果,并验证表单自身的确认状态。本文
Ethan Collins
13-Aug-2026
如何安全地处理机器人流程自动化流程中的验证码
RPA验证码自动化只有在验证码成为显式工作流状态时才可靠。CapSolver可以通过其浏览器扩展或文档化的API提供验证码处理层,而RPA平台控制流程范围、凭据、超时和业务验证。这避免了机器人在验证出现后持续点击、丢失表单状态或重复提交的常见故障。生产设计在检测时暂停,等待一个有限的结果,验证
Ethan Collins
12-Aug-2026
如何在自动化质量保证测试中处理验证码
通过受控的测试环境、CapSolver浏览器集成、有限重试和可靠断言来处理自动化QA测试中的CAPTCHA。
Ethan Collins
11-Aug-2026