




Cloudflare 挑战诊断:会话身份和验证

Ethan Collins
How to use CapSolver
31-Aug-2026
TL;DR
- 首先区分 Cloudflare 验证页面与 Turnstile、速率限制、身份验证、网络故障和应用程序错误。
- 使用经过文档说明的
AntiCloudflareTask,并使用精确的目标 URL 和静态或粘性代理;保持支持的 Chrome 用户代理一致。 - 如果需要验证 HTML,请从同一批准的会话中立即捕获,而不是从单独的请求身份中捕获。
- 将
cf_clearance、cookies、令牌、代理凭据和原始 HTML 视为必须避免进入日志或分析的短期秘密。 - 任务结果仅是中间成功。验证目标页面是否已加载,并且验证不再存在。
引言
Cloudflare 验证诊断应从状态分类和会话身份开始,而不是重复创建任务。受保护的页面可能显示中间验证页面、Turnstile 小部件、HTTP 429 响应、硬性阻止、身份验证屏幕、源错误或普通应用程序页面。每种状态需要不同的操作。对于支持的验证页面,CapSolver 文档说明了 AntiCloudflareTask,包括精确的目标 URL、静态或粘性代理和一致的 Chrome 用户代理;某些网站还需要来自同一会话的最新验证 HTML。然后必须将返回的清除数据应用于相同的请求身份,并与预期的目标页面进行验证。本指南提供了一个通用实现,不将设计绑定到特定行业、用例或代理框架。
从正确的问题定义开始
Cloudflare 将 验证 描述为评估浏览器和客户端信号的安全机制,并可能请求最小的用户交互。这个广泛类别不应与每个被阻止或不完整的响应混淆。
诊断工作流应按顺序回答以下四个问题:
- 目标是否被授权且在批准的范围内?
- 实际观察到的页面或响应状态是什么?
- 状态是否匹配支持的 CapSolver 任务类型?
- 任务执行后目标页面是否加载?
CapSolver Cloudflare 博客 包含相关的产品和实现材料,而 CapSolver CAPTCHA 解决 FAQ 解释了通用任务生命周期。
区分主要响应状态
| 状态 | 典型证据 | 正确的下一步操作 |
|---|---|---|
| 预期页面 | 已知标题、路由、语义选择器或响应模式 | 解析或继续 |
| Cloudflare 验证页面 | “请稍等…”,验证脚本,Cloudflare 标记 | 验证范围并考虑 AntiCloudflareTask |
| Turnstile 小部件 | Turnstile 脚本,站点密钥,小部件容器 | 使用记录的 Turnstile 任务路径 |
| 速率限制 | HTTP 429,Retry-After,配额响应 |
等待并减少请求速率 |
| 需要身份验证 | 登录表单,401,会话过期状态 | 通过批准的流程进行身份验证 |
| 硬性阻止 | 持续的 403 且无支持的验证证据 | 停止并审查访问策略或网络身份 |
| 源或网络错误 | 5xx,DNS,TLS,超时 | 修复基础设施;不要创建验证任务 |
| 未知页面 | 布局或语义不匹配已知状态 | 存储脱敏诊断并请求审查 |
验证服务不应作为对每个 403 或空页面的通用响应。
构建确定性页面分类器
python
from dataclasses import dataclass

@dataclass(frozen=True)
class HttpObservation:
    url: str
    status_code: int
    title: str
    html: str
    headers: dict[str, str]


def classify_observation(obs: HttpObservation) -> str:
    title = obs.title.lower()
    html = obs.html.lower()

    if obs.status_code == 429:
        return "RATE_LIMIT"

    if obs.status_code >= 500:
        return "ORIGIN_OR_NETWORK_ERROR"

    if "challenges.cloudflare.com/turnstile" in html:
        return "TURNSTILE_WIDGET"

    challenge_markers = (
        "just a moment" in title
        or "challenge-platform" in html
        or "cf-chl-" in html
    )
    if challenge_markers:
        return "CLOUDFLARE_CHALLENGE"

    if 'type="password"' in html or obs.status_code == 401:
        return "AUTH_REQUIRED"

    if obs.status_code == 200 and 'data-page="expected"' in html:
        return "EXPECTED_PAGE"

    if obs.status_code == 403:
        return "HARD_BLOCK"

    return "UNKNOWN_PAGE"
使用特定目标的成功标记。通用的 HTTP 200 不足以说明,因为验证、错误和同意页面也可能返回 200。
CapSolver 错误 FAQ 有助于将提供者错误与页面状态错误分开。
定义会话身份元组
Cloudflare 清除与访问者和设备上下文相关。Cloudflare 的 清除文档 指出 cf_clearance 与特定访问者和设备相关,并且可以随着会话行为的变化而重新评估。
显式表示请求身份:
python
from dataclasses import dataclass

@dataclass(frozen=True)
class SessionIdentity:
    session_id: str
    proxy_profile: str
    chrome_user_agent: str
    tls_profile: str
    cookie_jar_id: str
    target_host: str
该元组应从初始观察到任务执行和目标页面验证保持稳定。
在服务器端注册批准的目标
python
from dataclasses import dataclass
from urllib.parse import urlparse

@dataclass(frozen=True)
class TargetPolicy:
    target_id: str
    hostname: str
    allowed_path_prefixes: tuple[str, ...]
    purpose: str
    proxy_profile: str
    max_attempts: int = 1

TARGETS = {
    "docs_demo": TargetPolicy(
        target_id="docs_demo",
        hostname="approved.example.com",
        allowed_path_prefixes=("/public/", "/test/"),
        purpose="authorized integration validation",
        proxy_profile="approved_static_us",
    )
}


def resolve_target(target_id: str, url: str) -> TargetPolicy:
    policy = TARGETS.get(target_id)
    if policy is None:
        raise PermissionError("Unknown target")

    parsed = urlparse(url)
    if parsed.scheme != "https":
        raise PermissionError("HTTPS is required")
    if parsed.hostname != policy.hostname:
        raise PermissionError("Host is outside the approved scope")
    if not any(parsed.path.startswith(p) for p in policy.allowed_path_prefixes):
        raise PermissionError("Path is outside the approved scope")
    return policy
不要让不可信的调用者提供任意的 URL、代理或用途。
理解 AntiCloudflareTask 合同
CapSolver 的 Cloudflare 验证文档 定义了 AntiCloudflareTask。
| 字段 | 必需 | 诊断规则 |
|---|---|---|
type |
是 | 必须为 AntiCloudflareTask |
websiteURL |
是 | 精确的批准目标页面 |
proxy |
是 | 用于会话的静态或粘性代理 |
userAgent |
可选 | 客户端使用的相同支持的 Chrome 用户代理 |
html |
可选 | 来自同一会话的最新验证 HTML |
文档还要求使用支持 TLS 的请求库,并建议至少保持代理会话三分钟。
CapSolver 产品页面 有助于区分支持的 Cloudflare 和 Turnstile 任务类别。
从受信任的会话数据构建任务
python
import os
import capsolver

capsolver.api_key = os.environ["CAPSOLVER_API_KEY"]

PROXY_VAULT = {
    "approved_static_us": os.environ["APPROVED_STATIC_PROXY"],
}


def build_task(
    policy: TargetPolicy,
    identity: SessionIdentity,
    target_url: str,
    fresh_html: str | None,
) -> dict:
    if identity.proxy_profile != policy.proxy_profile:
        raise ValueError("Session proxy does not match target policy")
    if identity.target_host != policy.hostname:
        raise ValueError("Session host does not match target policy")

    task = {
        "type": "AntiCloudflareTask",
        "websiteURL": target_url,
        "proxy": PROXY_VAULT[identity.proxy_profile],
        "userAgent": identity.chrome_user_agent,
    }
    if fresh_html:
        task["html"] = fresh_html
    return task
任务构建器从受保护的库中读取网络凭证。它不会将它们返回给调用者或写入跟踪。
从同一会话中捕获 HTML
当需要 HTML 时,在分类器识别出验证后立即捕获。
python
from datetime import datetime, timezone

@dataclass(frozen=True)
class ChallengeDocument:
    session_id: str
    target_url: str
    body: str
    status_code: int
    captured_at: str

async def capture_challenge_document(client, identity, target_url):
    response = await client.get(
        target_url,
        session_id=identity.session_id,
        proxy_profile=identity.proxy_profile,
        user_agent=identity.chrome_user_agent,
        tls_profile=identity.tls_profile,
        cookie_jar_id=identity.cookie_jar_id,
    )
    observation = HttpObservation(
        url=str(response.url),
        status_code=response.status_code,
        title=extract_title(response.text),
        html=response.text,
        headers=dict(response.headers),
    )
    if classify_observation(observation) != "CLOUDFLARE_CHALLENGE":
        raise ValueError("The response is not a recognized Challenge page")

    return ChallengeDocument(
        session_id=identity.session_id,
        target_url=target_url,
        body=response.text,
        status_code=response.status_code,
        captured_at=datetime.now(timezone.utc).isoformat(),
    )
不要重复使用由其他代理、用户代理、会话或目标 URL 捕获的 HTML。
执行 CapSolver 任务
python
def solve_approved_challenge(
    target_id: str,
    target_url: str,
    identity: SessionIdentity,
    document: ChallengeDocument,
) -> dict:
    policy = resolve_target(target_id, target_url)

    if document.session_id != identity.session_id:
        raise ValueError("Document and session do not match")
    if document.target_url != target_url:
        raise ValueError("Document and target URL do not match")

    task = build_task(
        policy=policy,
        identity=identity,
        target_url=target_url,
        fresh_html=document.body,
    )
    solution = capsolver.solve(task)

    cookies = solution.get("cookies") or {}
    clearance = cookies.get("cf_clearance") or solution.get("token")
    returned_user_agent = solution.get("userAgent") or identity.chrome_user_agent

    if not clearance:
        raise RuntimeError("Task result did not contain clearance data")

    return {
        "cookies": cookies,
        "user_agent": returned_user_agent,
    }
不要打印 solution。仅提取下一个请求所需的运行时字段。
将清除数据应用到现有 Cookie Jar
python
async def apply_clearance(client, identity: SessionIdentity, result: dict):
    for name, value in result["cookies"].items():
        await client.set_cookie(
            cookie_jar_id=identity.cookie_jar_id,
            domain=identity.target_host,
            name=name,
            value=value,
            secure=True,
        )

    await client.set_user_agent(
        session_id=identity.session_id,
        user_agent=result["user_agent"],
    )
使用批准目标所需的精确主机和 Cookie 作用域。不要将 Cookie 复制到无关的域名或另一台机器。
验证目标页面
python
@dataclass(frozen=True)
class VerificationRule:
    expected_status: int
    required_selectors: tuple[str, ...]
    forbidden_markers: tuple[str, ...]
    expected_path_prefix: str

async def verify_target_page(
    client,
    identity: SessionIdentity,
    target_url: str,
    rule: VerificationRule,
) -> dict:
    response = await client.get(
        target_url,
        session_id=identity.session_id,
        proxy_profile=identity.proxy_profile,
        user_agent=identity.chrome_user_agent,
        tls_profile=identity.tls_profile,
        cookie_jar_id=identity.cookie_jar_id,
    )

    parsed = urlparse(str(response.url))
    body = response.text.lower()

    status_ok = response.status_code == rule.expected_status
    path_ok = parsed.path.startswith(rule.expected_path_prefix)
    markers_ok = not any(marker.lower() in body for marker in rule.forbidden_markers)
    selectors_ok = all(selector_in_html(response.text, selector) for selector in rule.required_selectors)

    return {
        "verified": status_ok and path_ok and markers_ok and selectors_ok,
        "status_ok": status_ok,
        "path_ok": path_ok,
        "markers_ok": markers_ok,
        "selectors_ok": selectors_ok,
    }
CapSolver 任务结果不足以说明问题。应用程序应在验证返回 verified=True 后继续。
使用有界状态机
python
from enum import Enum

class FlowState(str, Enum):
    OBSERVED = "OBSERVED"
    CLASSIFIED = "CLASSIFIED"
    TASK_CREATED = "TASK_CREATED"
    RESULT_READY = "RESULT_READY"
    PAGE_VERIFIED = "PAGE_VERIFIED"
    STOPPED = "STOPPED"

ALLOWED = {
    FlowState.OBSERVED: {FlowState.CLASSIFIED, FlowState.STOPPED},
    FlowState.CLASSIFIED: {FlowState.TASK_CREATED, FlowState.STOPPED},
    FlowState.TASK_CREATED: {FlowState.RESULT_READY, FlowState.STOPPED},
    FlowState.RESULT_READY: {FlowState.PAGE_VERIFIED, FlowState.STOPPED},
    FlowState.PAGE_VERIFIED: {FlowState.STOPPED},
}


def transition(current: FlowState, next_state: FlowState) -> FlowState:
    if next_state not in ALLOWED[current]:
        raise ValueError(f"Invalid transition: {current} -> {next_state}")
    return next_state
每个观察到的页面状态只允许一次任务尝试。如果验证失败,应停止并请求审查,而不是循环。
| 代理被阻止 | ERROR_PROXY_BANNED | 审核批准的网络身份 |
| 账户/密钥 | ERROR_KEY_DENIED_ACCESS, ERROR_ZERO_BALANCE | 修复账户配置 |
| 临时服务 | ERROR_SERVICE_UNAVALIABLE | 退避并检查提供商状态 |
不要对每个错误应用相同的重试规则。
将错误归类为稳定的类别
python
ERROR_ACTIONS = {
    "ERROR_INVALID_TASK_DATA": "FIX_INPUT",
    "ERROR_RATE_LIMIT": "WAIT",
    "ERROR_TASK_TIMEOUT": "REVIEW",
    "ERROR_TASK_NOT_SUPPORTED": "RECLASSIFY",
    "ERROR_CAPTCHA_UNSOLVABLE": "REVIEW",
    "ERROR_PROXY_BANNED": "REVIEW_NETWORK",
    "ERROR_KEY_DENIED_ACCESS": "FIX_ACCOUNT",
    "ERROR_ZERO_BALANCE": "FIX_ACCOUNT",
    "ERROR_SERVICE_UNAVALIABLE": "BACKOFF",
}


def normalize_error(error_code: str | None) -> dict:
    code = error_code or "UNKNOWN_ERROR"
    return {
        "category": code,
        "action": ERROR_ACTIONS.get(code, "OPERATOR_REVIEW"),
        "retry_allowed": ERROR_ACTIONS.get(code) in {"WAIT", "BACKOFF"},
    }
重试应仅由受信任的策略允许,并且仅在触发条件发生变化或等待期结束后进行。
保护短期会话材料
将以下内容视为机密:
- CapSolver API 密钥;
- 代理凭据;
cf_clearance和其他 cookies;- 挑战令牌;
- 当它作为设备身份的一部分时的完整用户代理;
- 原始挑战 HTML;
- 浏览器存储状态;
- 包含标识符的不受限制的目标 URL。
python
SAFE_EVENT_FIELDS = {
    "event",
    "target_id",
    "state",
    "error_category",
    "attempt_count",
    "duration_ms",
    "verified",
    "observed_at",
}


def redact_event(event: dict) -> dict:
    return {
        key: event[key]
        for key in SAFE_EVENT_FIELDS
        if key in event
    }
将敏感证据存储为哈希值或内部引用,而不是将证据本身放入通用日志中。
CapSolver 常见问题 提供了额外的操作指导,CapSolver 状态页面 有助于区分应用失败和提供商可用性。
添加有用的可观测性
python
from datetime import datetime, timezone
from time import monotonic


def diagnostic_event(
    target_id: str,
    state: str,
    attempt_count: int,
    verified: bool,
    started_at: float,
    error_category: str | None = None,
) -> dict:
    return redact_event({
        "event": "cloudflare_challenge_diagnostic",
        "target_id": target_id,
        "state": state,
        "attempt_count": attempt_count,
        "duration_ms": int((monotonic() - started_at) * 1000),
        "verified": verified,
        "error_category": error_category,
        "observed_at": datetime.now(timezone.utc).isoformat(),
    })
跟踪挑战率、成功任务率、验证页面率、错误分布、准备时间以及操作员审核量。不要跟踪机密信息。
测试诊断路径
python
import pytest

@pytest.mark.parametrize(
    "status,title,html,expected",
    [
        (429, "Rate limited", "", "RATE_LIMIT"),
        (403, "Just a moment...", "cf-chl-test", "CLOUDFLARE_CHALLENGE"),
        (200, "Sign in", '<input type="password">', "AUTH_REQUIRED"),
        (500, "Server error", "", "ORIGIN_OR_NETWORK_ERROR"),
    ],
)
def test_classifier(status, title, html, expected):
    observation = HttpObservation(
        url="https://approved.example.com/test/",
        status_code=status,
        title=title,
        html=html,
        headers={},
    )
    assert classify_observation(observation) == expected
还要测试身份不匹配的情况:
python
def test_task_rejects_proxy_profile_mismatch():
    policy = TARGETS["docs_demo"]
    identity = SessionIdentity(
        session_id="session-1",
        proxy_profile="wrong_profile",
        chrome_user_agent="Mozilla/5.0 ... Chrome/141.0.0.0 ...",
        tls_profile="chrome141",
        cookie_jar_id="jar-1",
        target_host="approved.example.com",
    )

    with pytest.raises(ValueError):
        build_task(
            policy=policy,
            identity=identity,
            target_url="https://approved.example.com/test/",
            fresh_html="<html>Just a moment...</html>",
        )
最后,测试过滤应排除 cookies、HTML、密钥和代理值。
附加代码:在 CapSolver 仪表板 使用代码 WEBS 可在每次充值时获得额外 5% 的奖励。
对比总结
| 模式 | 身份一致性 | 诊断清晰度 | 建议 |
|---|---|---|---|
| 每403重试 | 低 | 低 | 避免 |
| 从调用者提供的字段创建任务 | 可变 | 低 | 避免 |
| 分类、从可信身份构建,然后验证 | 高 | 高 | 推荐 |
| 停止并请求人工审核 | 高 | 高 | 未知或敏感状态时必须 |
推荐的模式使每个决策都明确且可测试。
生产清单
- 在服务器端注册批准的主机、路径、目的和代理配置文件。
- 分别分类预期页面、挑战、Turnstile、速率限制、身份验证、硬性阻止和网络错误。
- 仅在识别到支持的挑战页面时使用
AntiCloudflareTask。 - 保持静态或粘性代理、支持的 Chrome 用户代理、TLS 配置文件和 cookie jar 一致。
- 在需要时从同一会话中捕获挑战 HTML。
- 将清除数据存储在短期秘密存储中。
- 在应用会话数据后验证确切的目标页面。
- 每个观察到的状态只允许一次任务尝试。
- 将错误代码映射到不同的操作。
- 仅记录过滤后的操作字段。
- 测试页面分类、身份不匹配、结果验证和秘密过滤。
CapSolver 产品页面 可在实施前帮助确认支持的挑战类别。
负责任的使用
仅在您拥有、测试或获得明确访问权限的网站上使用 Cloudflare 挑战处理。尊重条款、速率限制、身份验证边界、隐私义务和源政策。挑战处理能力不授予访问权限。当目标未知、页面敏感、身份不一致或验证失败时停止。将关键操作置于单独的策略和人工审批步骤之后。
结论
Cloudflare 挑战诊断应是一个严格的流程:授权目标,分类观察到的页面,从可信会话身份构建 AntiCloudflareTask,保持代理和受支持的 Chrome 用户代理一致,将短期清除材料应用于同一 cookie jar,并验证预期页面。错误应被分类而非盲目重试,且机密信息不应进入日志或模型上下文。
通过 CapSolver 开始批准的实现,在受控测试页面上验证它,并在生产使用前添加状态、身份、验证和过滤测试。
常见问题
哪种 CapSolver 任务类型处理 Cloudflare 挑战页面?
当观察到的页面匹配支持的 Cloudflare 挑战且目标已授权时,使用记录的 AntiCloudflareTask。
是否需要代理?
是的。CapSolver 为此任务记录了静态或粘性代理。在整个验证过程中保持该网络身份一致。
何时应包含 html 字段?
当目标需要时包含新鲜的挑战 HTML。使用相同的粘性代理、支持的 Chrome 用户代理、cookie jar 和目标 URL 捕获 HTML。
就绪任务结果是否足够?
不。将返回的会话材料应用于同一请求身份,并验证预期目标页面是否加载而没有挑战标记。
遇到未知错误或验证失败后应如何处理?
停止,保留过滤后的诊断信息,并请求操作员审核。不要创建无限制的重试循环。
合规声明: 本博客提供的信息仅供参考。CapSolver 致力于遵守所有适用的法律和法规。严禁以非法、欺诈或滥用活动使用 CapSolver 网络,任何此类行为将受到调查。我们的验证码解决方案在确保 100% 合规的同时,帮助解决公共数据爬取过程中的验证码难题。我们鼓励负责任地使用我们的服务。如需更多信息,请访问我们的服务条款和隐私政策。
更多
Turnstile Solver API 检查清单:输入、令牌和验证
在将其添加到您的工作流程之前,通过其记录的输入、令牌响应、验证边界和受控测试用例来评估一个Turnstile求解器API。
Anh Tuan
16-Sep-2026
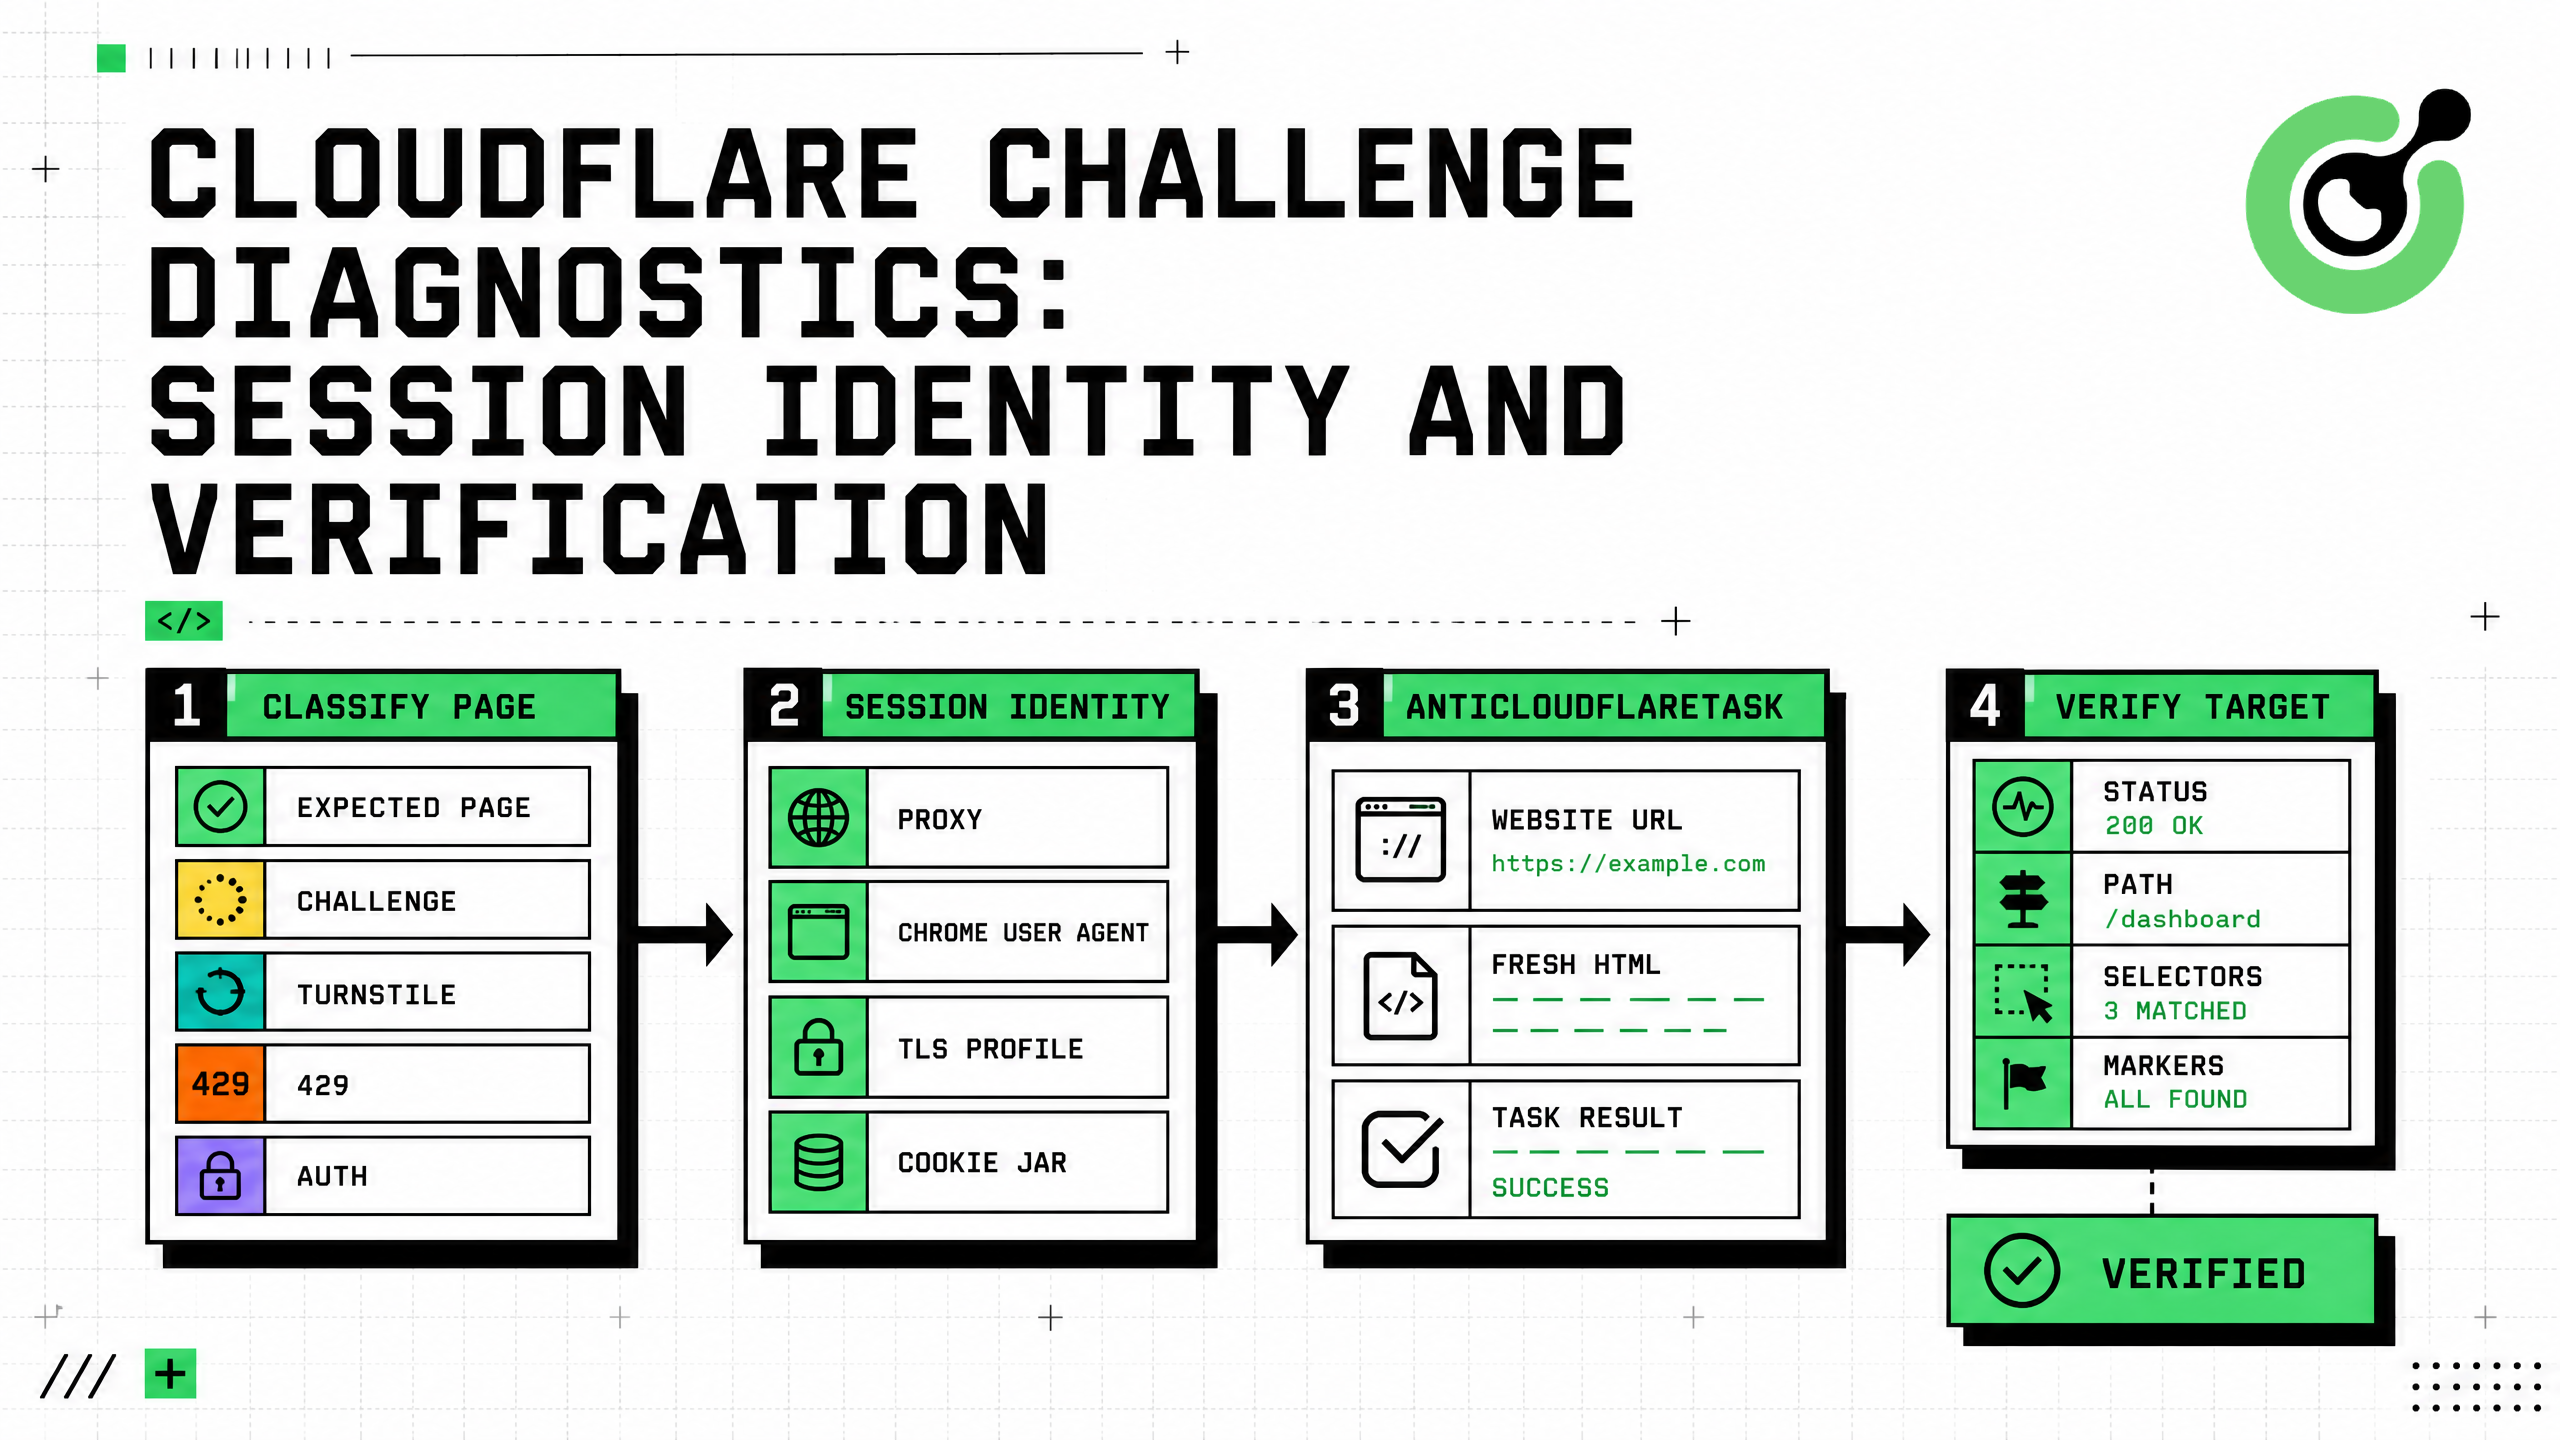
Cloudflare 挑战诊断:会话身份和验证
使用 AntiCloudflareTask 诊断 Cloudflare 验证流程,稳定代理和用户代理身份,新鲜 HTML,清除处理,验证和安全错误。
Ethan Collins
31-Aug-2026
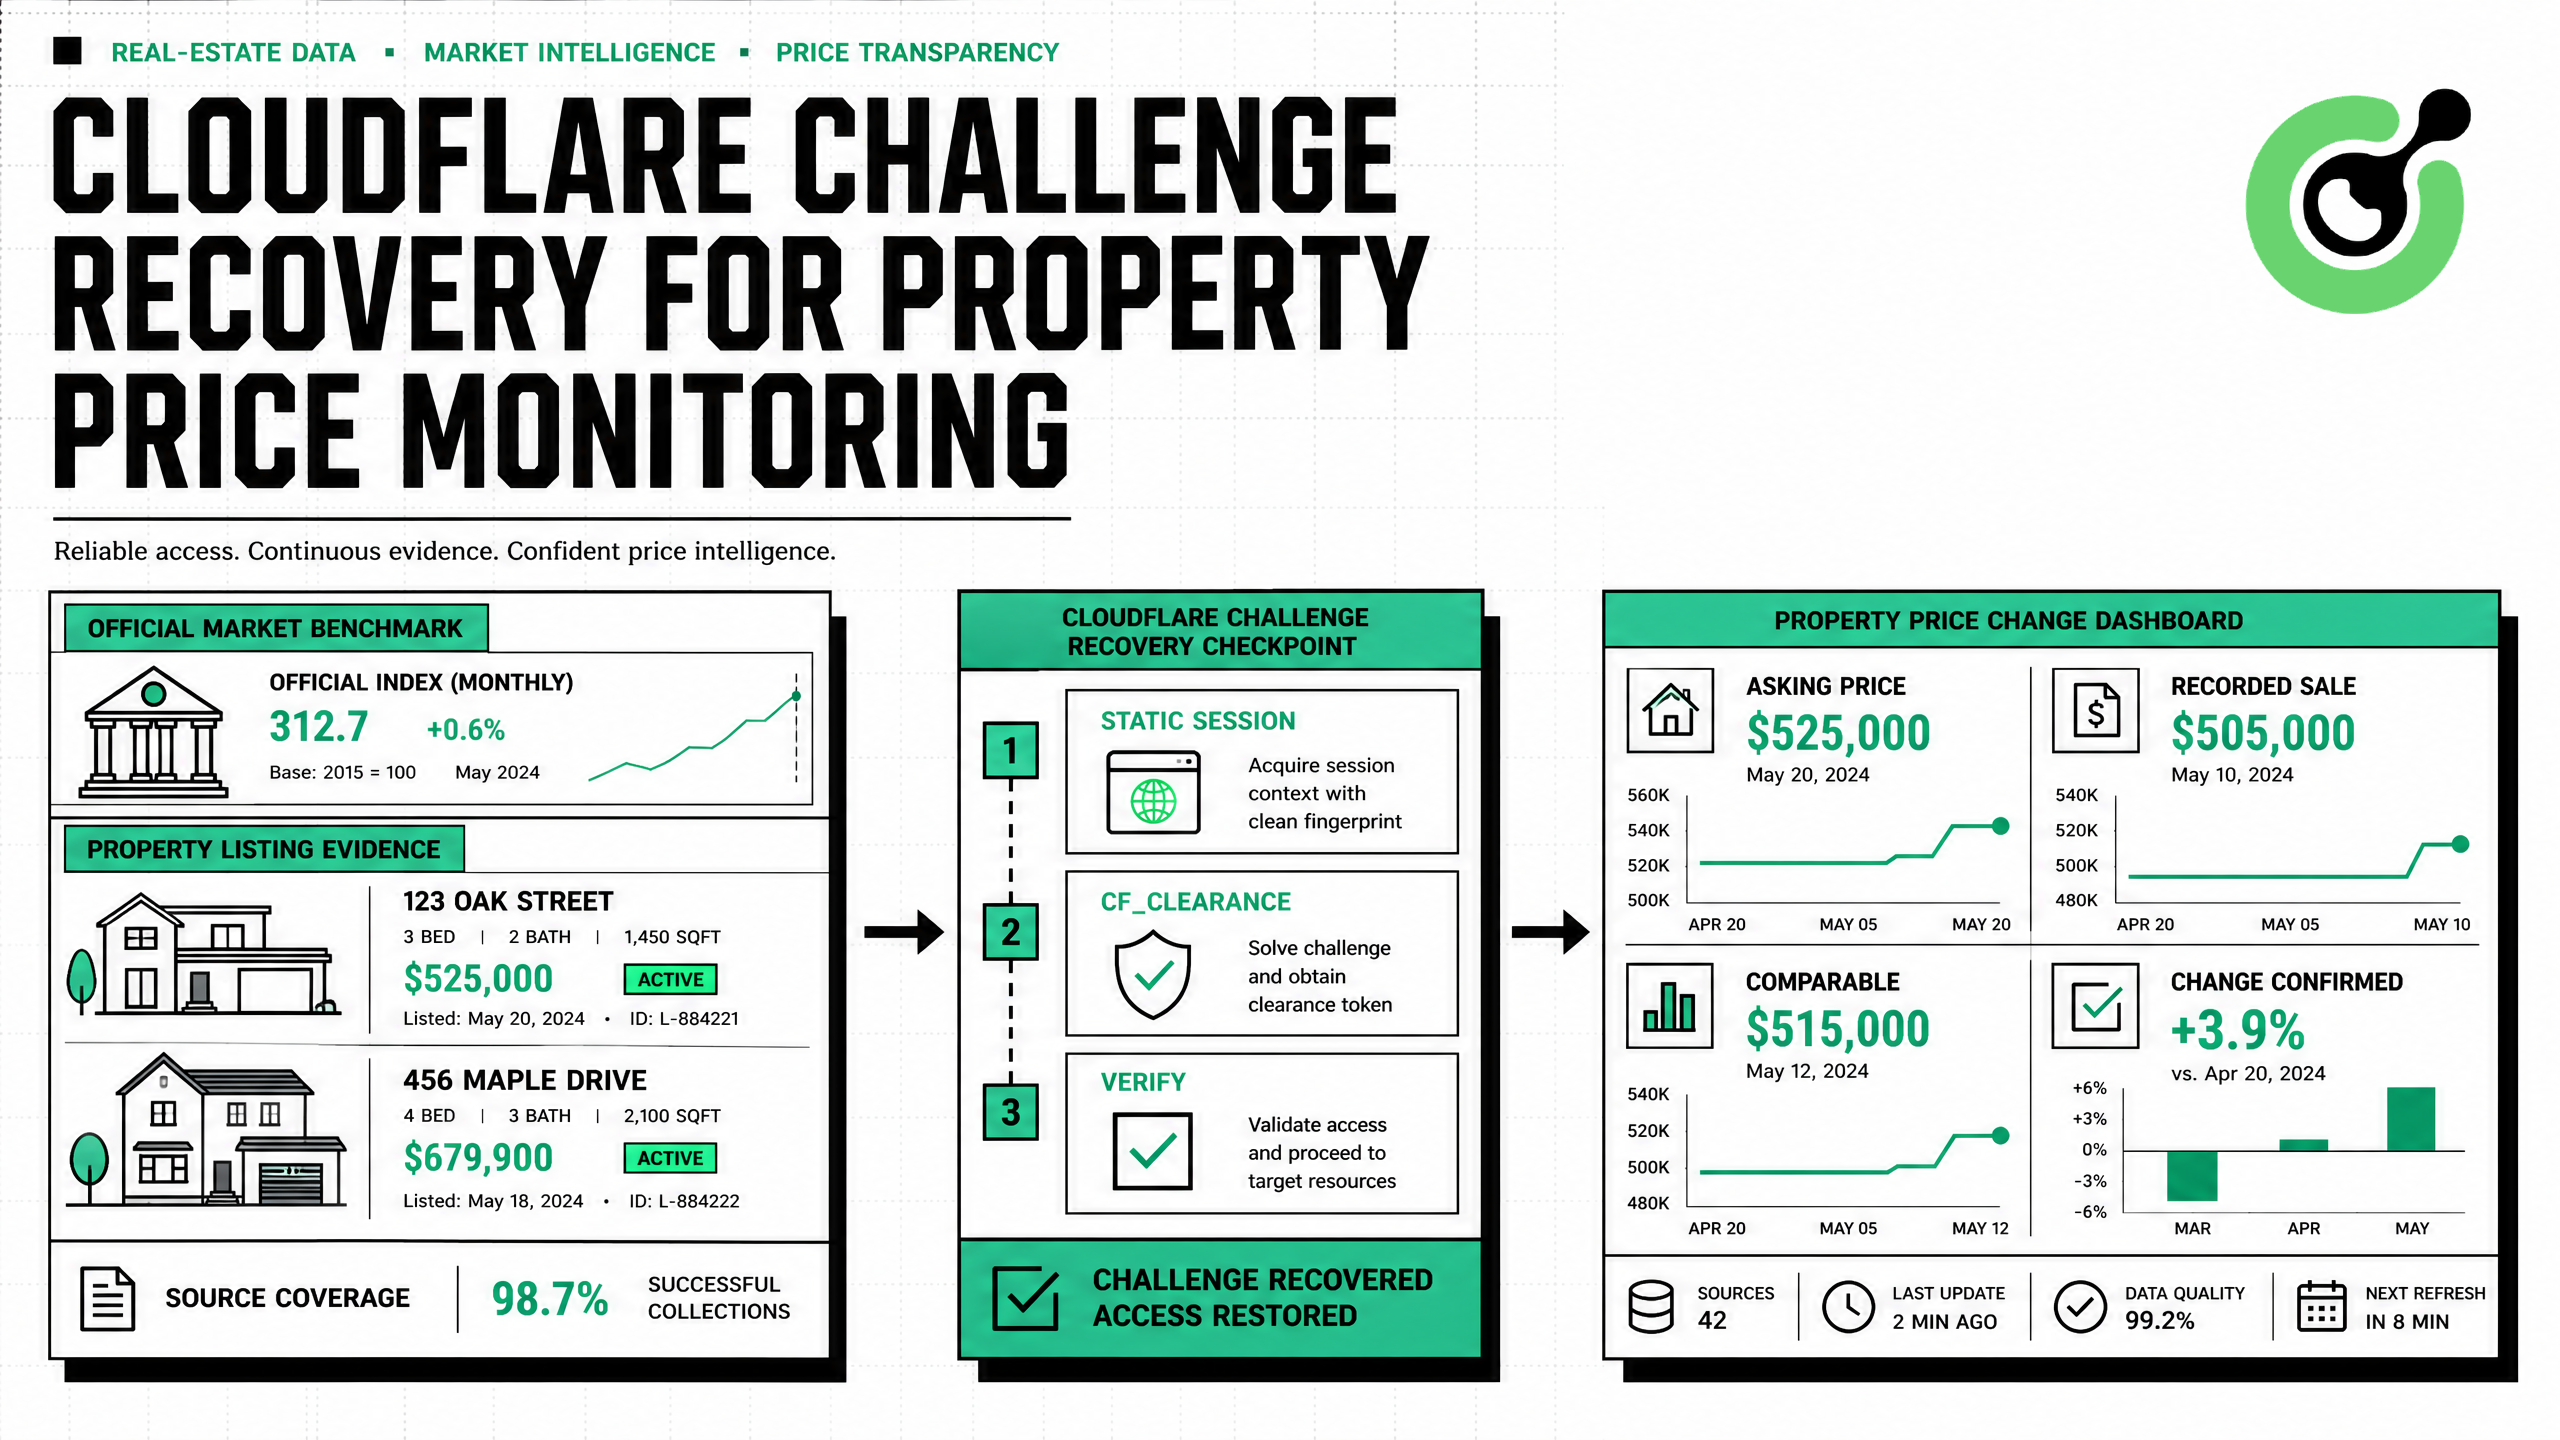
如何解决 Cloudflare 验证 用于房产价格监控
通过官方数据集、可比的观测、Cloudflare挑战解决、证据和受控警报,构建可靠的房产价格监测。
Ethan Collins
28-Aug-2026
如何解决 Cloudflare 验证以进行电子商务库存监控
构建可靠的电商库存监控,使用以API为先的采购、Cloudflare挑战恢复、会话一致性、库存证据和安全警报。
Ethan Collins
27-Aug-2026
什么是无效的 Cloudflare 人机验证令牌:原因和解决方法
通过检查过期时间、网站密钥、操作、cdata、浏览器状态、服务器验证和有限的CapSolver重试次数来修复无效的Turnstile令牌。
Ethan Collins
11-Aug-2026
MCP 验证码破解器:Cloudflare Turnstile 集成指南
使用 CapSolver 构建一个策略限制的 MCP Cloudflare Turnstile 工作流,包含有限重试、脱敏日志、会话检查和结果验证。
Ethan Collins
22-Jul-2026