




如何解决 Cloudflare 验证以进行电子商务库存监控

Ethan Collins
How to use CapSolver
27-Aug-2026
简要说明
- 从官方商业API、商户馈送和库存网络钩子开始;仅在文档记录的缺口处使用授权的公共页面。
- 当支持的Cloudflare挑战中断了批准的浏览器工作流时,使用官方的
AntiCloudflareTask并搭配静态或粘性代理。 - 在浏览器恢复时,保持相同的代理、Chrome用户代理、Cookie作用域和目标URL。
- 存储带有产品身份、变体、可用性、数量置信度、时间戳、来源和解析器版本的库存证据。
- 保持警报只读;在预订、结账或购买前需要单独的策略和人工确认。
介绍
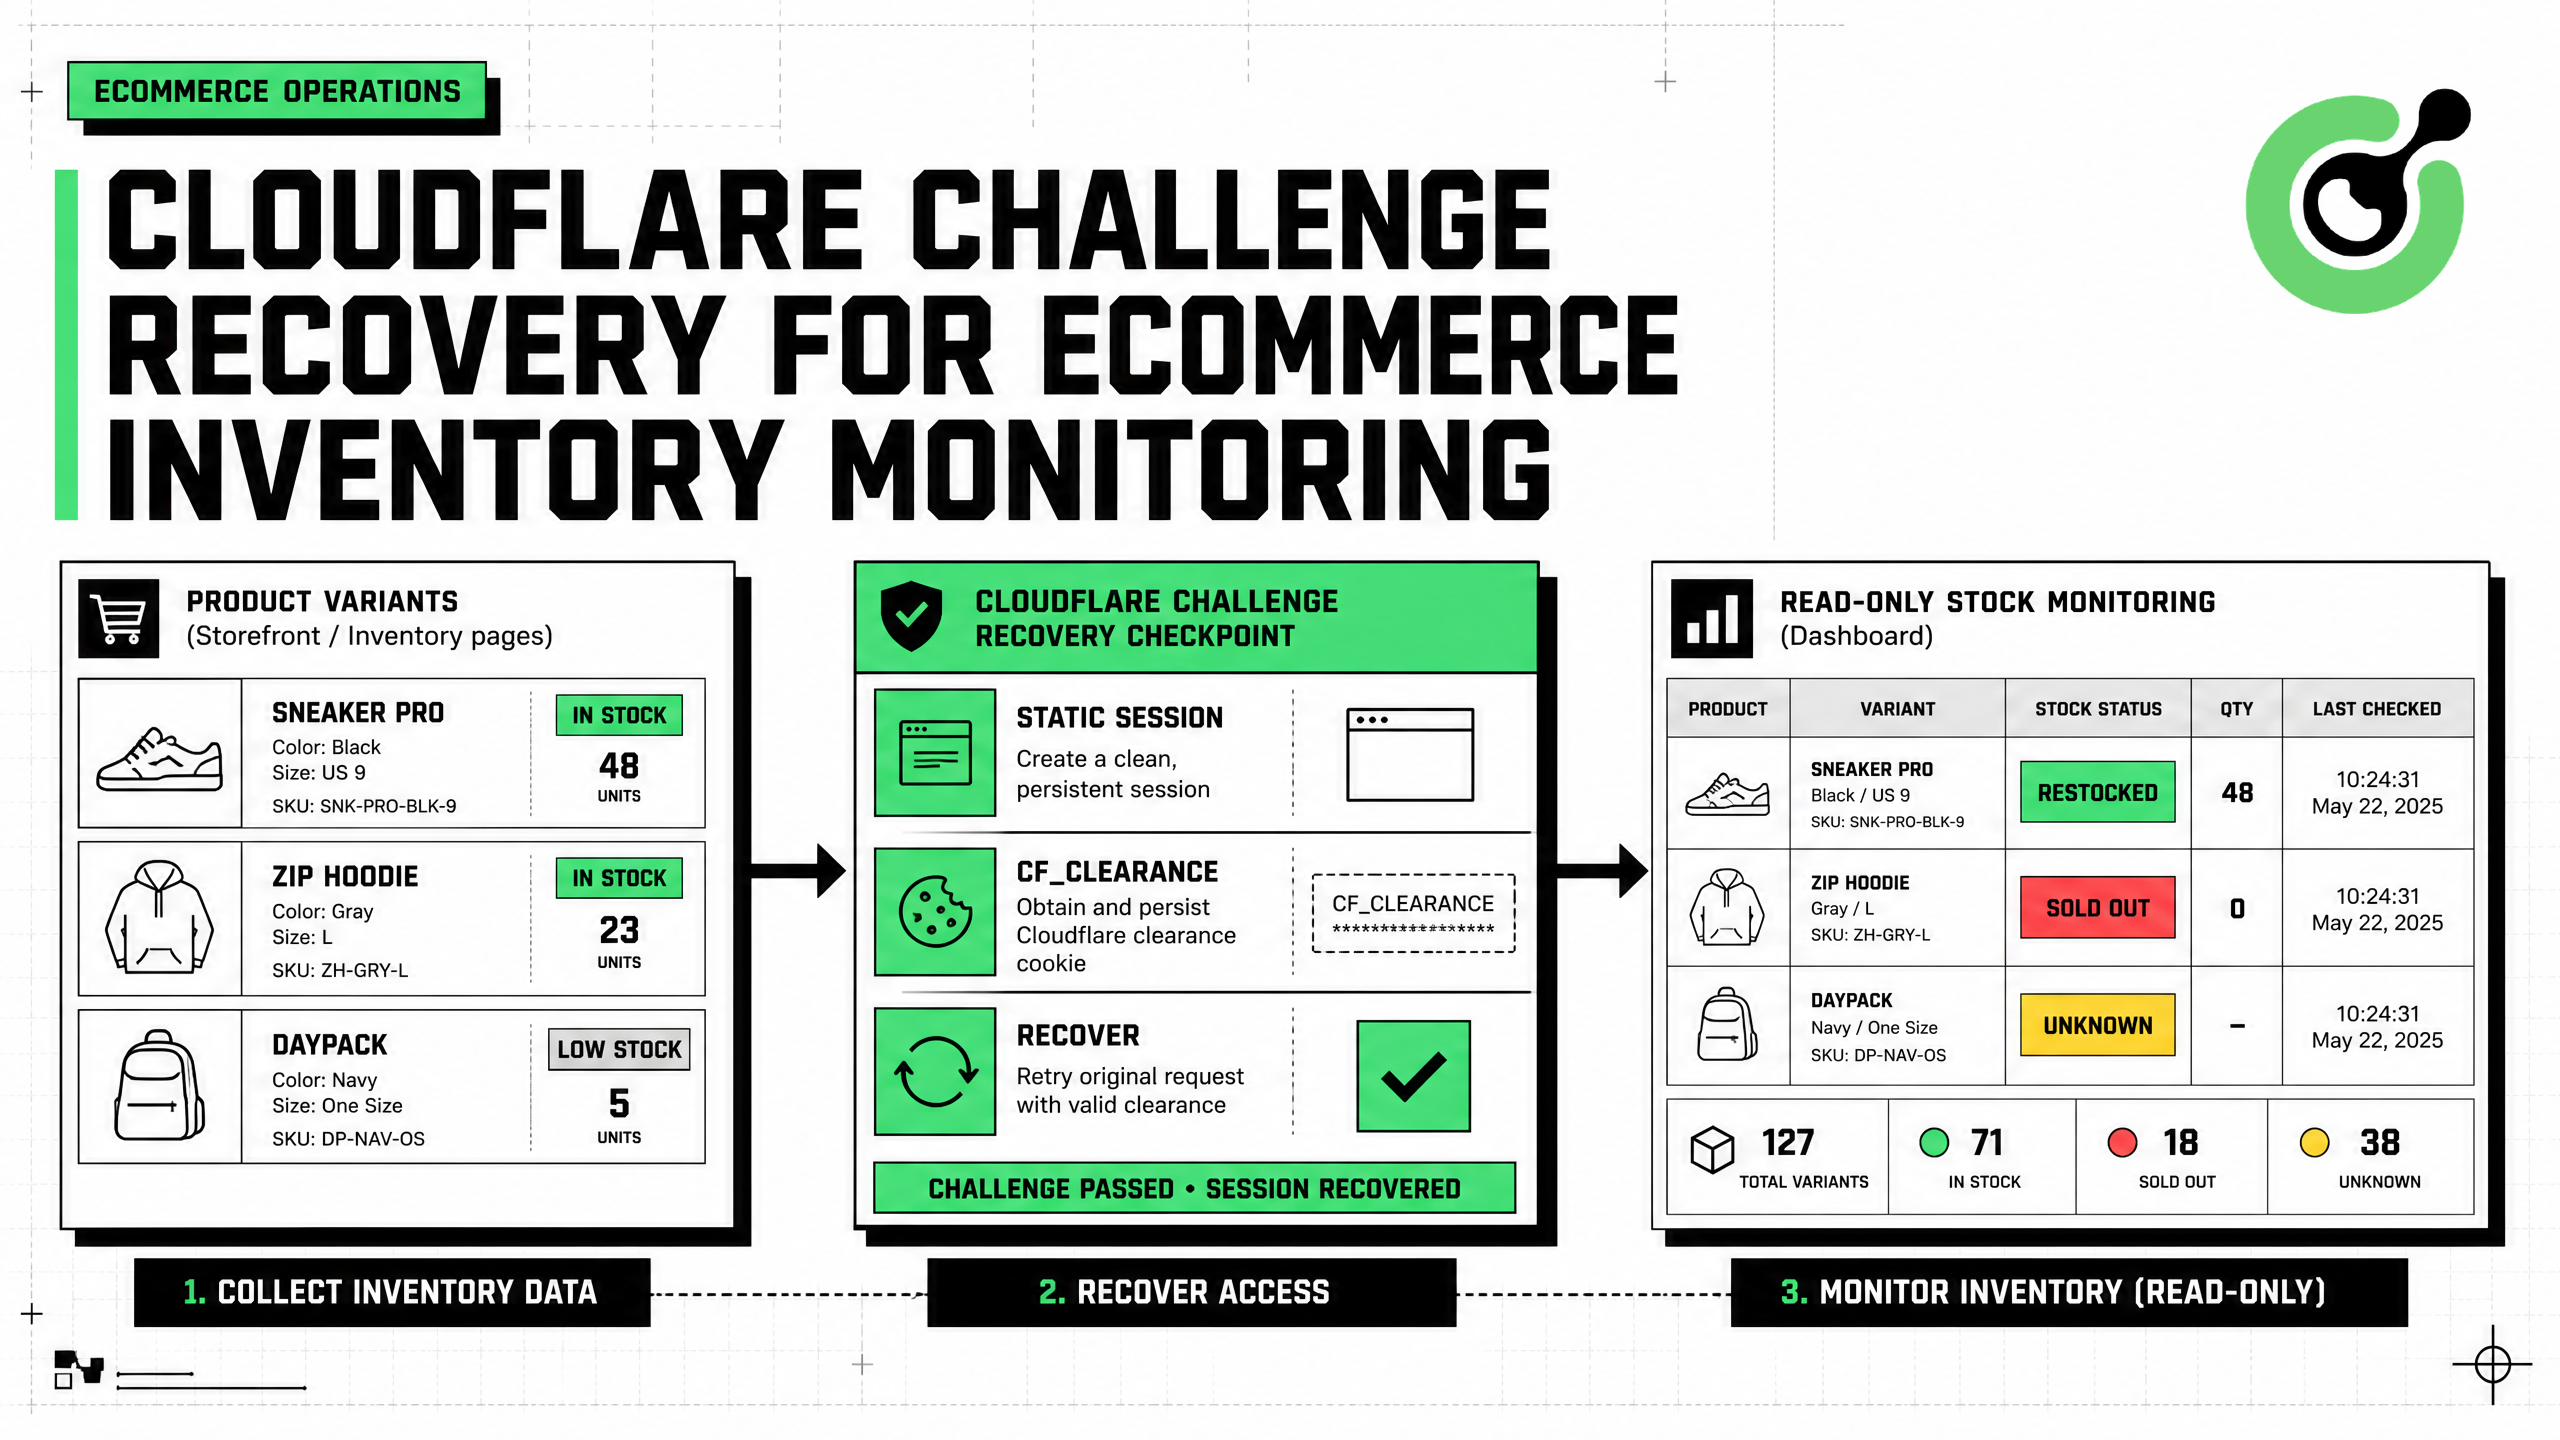
可靠的电商库存监控是一个证据问题,而不仅仅是页面获取问题。产品页面可能显示“有库存”,而特定尺寸却不可用;市场API可能落后于商户馈送;Cloudflare挑战可能用中间页面替换预期页面。正确的流程是优先使用API、关注变体并保持会话一致性。它在可用时使用官方馈送,记录结构化的库存观察,并在支持的Cloudflare挑战中断授权浏览器回退时调用CapSolver。本指南解释了数据模型、挑战恢复流程、静态代理和用户代理要求、Cookie交接、库存变化检测、警报控制和零售运营、目录智能和授权可用性监控的合规边界。
首先明确库存问题
库存监控应回答一个具体的运营问题。常见示例包括:
- 已知SKU在特定市场是否可用?
- 某尺寸、颜色或包装变体是否从不可用变为可用?
- 市场列表是否消失或返回?
- 指定门店是否有自提服务?
- 商户是否从数量信号改为通用可用性标签?
避免模糊的目标,如“监控此产品”。明确产品标识符、变体、地区、交付上下文、来源和警报条件。
python
inventory_job = {
    "canonical_product_id": "catalog-7821",
    "gtin": "0099999999999",
    "variant": {
        "color": "black",
        "size": "M",
    },
    "market": "US",
    "destination_postal_code": "94107",
    "sources": [
        "merchant_inventory_feed",
        "marketplace_api",
        "authorized_product_page",
    ],
    "alert_on": ["OUT_OF_STOCK_TO_IN_STOCK"],
}CapSolver电商博客涵盖了相关的电商流程,CapSolver网页抓取常见问题解释了允许的公共数据收集的操作考虑。
在浏览器收集前使用官方库存来源
官方来源通常更稳定且易于审计。在读取买家页面前,优先使用商家馈送、卖家API、市场库存端点和授权目录提供商。
ebay浏览API文档支持通过关键词、类别、ePID、GTIN、状况等过滤器进行商品搜索。对于发布结构化产品页面的商店,Schema.org Offer定义了字段如availability、price、priceCurrency、seller和可选数量。Google的产品结构化数据文档解释了如何在产品标记中显示报价和可用性数据。
| 来源 | 推荐角色 | 主要优势 | 主要限制 |
|---|---|---|---|
| 商家库存馈送 | 用于自有目录的主要来源 | 直接SKU和数量数据 | 仅限于您的商业关系 |
| 市场API | 用于批准的市场列表的主要来源 | 结构化标识符和过滤器 | 配额和市场特定字段 |
| 授权提供商 | 跨市场标准化 | 一致的模式 | 许可费用和覆盖范围 |
| 授权公共页面 | 验证和缺口覆盖 | 反映买家页面状态 | 布局变化和流量验证 |
浏览器收集应验证或补充已知的数据缺口,而不是替代可用的官方来源。
构建关注变体的库存模式
通用的in_stock: true字段是不够的。保留变体、渠道、市场、卖家和证据。
python
from dataclasses import dataclass, field
from datetime import datetime, timezone

@dataclass
class InventoryObservation:
    source: str
    canonical_product_id: str
    source_item_id: str | None
    gtin: str | None
    variant: dict[str, str]
    market: str
    seller_id: str | None
    availability: str
    quantity: int | None
    quantity_confidence: str
    delivery_method: str | None
    store_id: str | None
    source_url: str | None
    evidence: dict
    parser_version: str
    observed_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )
使用受控的可用性词汇表:
python
VALID_AVAILABILITY = {
    "IN_STOCK",
    "OUT_OF_STOCK",
    "PREORDER",
    "BACKORDER",
    "LIMITED",
    "UNKNOWN",
}如果页面仅显示“可用”,则记录数量为None。不要推断数值。
CapSolver Python网页数据指南提供了实现上下文,CapSolver术语表可以帮助团队标准化术语。
在解析库存前检测挑战
解析器应在读取库存数据前验证页面身份。挑战页面可能返回HTTP 200,但仍不包含任何预期的产品元素。
python
CHALLENGE_TITLES = {
    "just a moment...",
    "attention required!",
}

async def classify_page(page) -> str:
    title = (await page.title()).strip().lower()
    html = (await page.content()).lower()

    if title in CHALLENGE_TITLES:
        return "CLOUDFLARE_CHALLENGE"
    if "cf-chl-" in html or "challenge-platform" in html:
        return "CLOUDFLARE_CHALLENGE"
    if await page.locator('[data-product-id]').count():
        return "PRODUCT_PAGE"
    return "UNKNOWN_PAGE"
将这些标记视为路由信号,而非普遍证明。保持目标特定的固定装置,并在您被授权访问的页面上测试它们。
CapSolver Cloudflare产品页面描述了支持的挑战任务,CapSolver Cloudflare博客包含故障排除上下文。
理解官方Cloudflare挑战任务
CapSolver的官方Cloudflare挑战文档定义了AntiCloudflareTask。
| 字段 | 必需 | 库存监控用途 |
|---|---|---|
type |
是 | 固定为AntiCloudflareTask |
websiteURL |
是 | 准确的批准产品或列表URL |
proxy |
是 | 浏览器使用的静态或粘性代理 |
userAgent |
否 | 浏览器中的精确支持的Chrome用户代理 |
html |
否 | 当目标需要时的最新中间HTML |
解决方案可以包含cf_clearance cookie、令牌和用户代理。这些值是短期会话材料。它们应由监控运行时使用,而不是存储在分析仓库中。
Cloudflare的挑战文档解释了挑战机制的目的和类型。技术能力不授予访问权限,因此源策略仍然是控制规则。
使用服务器端代理配置创建恢复任务
不要将代理凭证暴露给分析师、模型、日志或警报。在受信任的代码中解析配置文件。
python
import os
from urllib.parse import urlparse

import capsolver

capsolver.api_key = os.environ["CAPSOLVER_API_KEY"]

SOURCE_POLICY = {
    "shop.example.com": {
        "proxy_profile": "inventory_us_west",
        "max_checks_per_hour": 4,
    }
}

PROXY_VAULT = {
    "inventory_us_west": os.environ["INVENTORY_PROXY_US_WEST"],
}


def approved_host(url: str) -> str:
    host = urlparse(url).hostname
    if host not in SOURCE_POLICY:
        raise PermissionError("库存源未获批准")
    return host


def solve_cloudflare_challenge(
    url: str,
    chrome_user_agent: str,
    fresh_html: str = "",
) -> dict:
    host = approved_host(url)
    profile = SOURCE_POLICY[host]["proxy_profile"]

    task = {
        "type": "AntiCloudflareTask",
        "websiteURL": url,
        "proxy": PROXY_VAULT[profile],
        "userAgent": chrome_user_agent,
    }
    if fresh_html:
        task["html"] = fresh_html

    solution = capsolver.solve(task)
    cookies = solution.get("cookies") or {}
    clearance = cookies.get("cf_clearance") or solution.get("token")
    if not clearance:
        raise RuntimeError("挑战解决方案未包含清除信息")

    return {
        "cookies": cookies,
        "user_agent": solution.get("userAgent") or chrome_user_agent,
        "proxy_profile": profile,
    }
使用静态或粘性代理。在初始导航、解决和页面恢复之间不要轮换网络身份。
恢复相同的浏览器身份
使用批准的代理和用户代理创建Playwright上下文,捕获挑战状态,获取解决方案,并在兼容的上下文中应用Cookie。
python
from urllib.parse import urlparse

async def recover_inventory_page(browser, url: str):
    host = approved_host(url)
    profile = SOURCE_POLICY[host]["proxy_profile"]
    proxy = PROXY_VAULT[profile]

    bootstrap_context = await browser.new_context(
        proxy={"server": proxy},
    )
    bootstrap_page = await bootstrap_context.new_page()
    await bootstrap_page.goto(url, wait_until="domcontentloaded")

    state = await classify_page(bootstrap_page)
    if state != "CLOUDFLARE_CHALLENGE":
        return bootstrap_context, bootstrap_page, False

    user_agent = await bootstrap_page.evaluate("navigator.userAgent")
    html = await bootstrap_page.content()

    solution = solve_cloudflare_challenge(
        url=url,
        chrome_user_agent=user_agent,
        fresh_html=html,
    )

    await bootstrap_context.close()

    context = await browser.new_context(
        proxy={"server": proxy},
        user_agent=solution["user_agent"],
    )

    cookie_domain = urlparse(url).hostname
    await context.add_cookies([
        {
            "name": name,
            "value": value,
            "domain": cookie_domain,
            "path": "/",
            "secure": True,
            "httpOnly": True,
        }
        for name, value in solution["cookies"].items()
    ])

    page = await context.new_page()
    await page.goto(url, wait_until="domcontentloaded")
    return context, page, True
不同的代理格式需要不同的Playwright字段。在需要时在库适配器中解析代理服务器、用户名和密码。
从结构化证据中解析库存
优先使用JSON-LD或稳定的页面契约,而不是展示文本。
python
import json

SCHEMA_AVAILABILITY = {
    "https://schema.org/InStock": "IN_STOCK",
    "https://schema.org/OutOfStock": "OUT_OF_STOCK",
    "https://schema.org/PreOrder": "PREORDER",
    "https://schema.org/BackOrder": "BACKORDER",
    "InStock": "IN_STOCK",
    "OutOfStock": "OUT_OF_STOCK",
}

async def read_jsonld_offers(page) -> list[dict]:
    blocks = await page.locator(
        'script[type="application/ld+json"]'
    ).all_text_contents()

    offers = []
    for raw in blocks:
        try:
            data = json.loads(raw)
        except json.JSONDecodeError:
            continue

        nodes = data if isinstance(data, list) else [data]
        for node in nodes:
            if not isinstance(node, dict):
                continue
            offer = node.get("offers")
            if isinstance(offer, dict):
                offers.append(offer)
            elif isinstance(offer, list):
                offers.extend(x for x in offer if isinstance(x, dict))
    return offers
规范化可用性而不发明数量:
python
def normalize_offer_availability(offer: dict) -> tuple[str, int | None]:
    raw = str(offer.get("availability", ""))
    availability = SCHEMA_AVAILABILITY.get(raw, "UNKNOWN")

    inventory_level = offer.get("inventoryLevel")
    quantity = None
    if isinstance(inventory_level, dict):
        value = inventory_level.get("value")
        if isinstance(value, int) and value >= 0:
            quantity = value

    return availability, quantity
存储相关证据和解析器版本的哈希。这使得警报可重复,而无需保留不必要的页面内容。
检测库存变化
警报应针对变化,而不是重复快照。
python
def inventory_transition(previous: str, current: str) -> str | None:
    if previous == current:
        return None
    if previous in {"OUT_OF_STOCK", "UNKNOWN"} and current == "IN_STOCK":
        return "RESTOCKED"
    if previous == "IN_STOCK" and current == "OUT_OF_STOCK":
        return "SOLD_OUT"
    return "STATUS_CHANGED"
当源嘈杂时,需要两次观察:
python
def confirmed_transition(observations: list[InventoryObservation]) -> str | None:
    if len(observations) < 3:
        return None
    older, previous, current = observations[-3:]
    if previous.availability != current.availability:
        return None
    return inventory_transition(older.availability, current.availability)
第二个样本减少了由临时解析器或页面状态错误引起的警报。根据源的更新频率调整规则。
将挑战指标与库存指标分开
挑战事件是基础设施信号。它不是库存变化。
| 指标 | 含义 | 警报目的地 |
|---|---|---|
inventory_restock_total |
确认的不可用到可用的过渡 | 商业运营 |
inventory_unknown_total |
解析器无法确定可用性 | 数据质量队列 |
challenge_encounter_total |
批准页面显示挑战 | 自动化运营 |
challenge_recovery_success |
恢复完成且产品页面返回 | 可靠性仪表板 |
challenge_loop_total |
恢复后页面仍处于挑战状态 | 操作员审查 |
永远不要将挑战页面、HTTP错误或空选择器分类为OUT_OF_STOCK。
CapSolver错误常见问题提供诊断指南,CapSolver自动化博客涵盖相关恢复模式。
优惠代码:在CapSolver仪表板使用代码WEBS,每次充值可额外获得5%的奖励。
生产控制
| 控制项 | 推荐实现方式 |
|---|---|
| 源权限 | 按主机批准记录和用途限制 |
| 源优先级 | 优先使用Feed或API,再回退到浏览器 |
| 代理 | 服务器端解析的静态或粘性配置文件 |
| 用户代理 | 通过恢复过程使用相同的受支持Chrome身份 |
| Cookies | 短期加密存储;不保留分析数据 |
| 重试 | 一次恢复尝试后,再由操作员审核 |
| 速率限制 | 源特定配额,带退避和随机抖动 |
| 警报 | 默认只读通知 |
| 高影响操作 | 预订或购买前需明确确认 |
使用CapSolver CAPTCHA解决常见问题了解任务流程,CapSolver产品页面查看支持的解决方案类别。
负责任使用
仅监控您有权访问的来源。遵守市场API许可协议、商家条款、速率限制、隐私要求和库存数据合同。不要使用挑战恢复访问私人账户、受限卖家仪表板、买家记录或非公开库存。除非有单独批准的服务在获得明确人工同意后处理预订或结账,否则保持系统只读。
结论
Cloudflare挑战恢复可以使电商库存监控更加可靠,但只有在位于以API为先、变体感知和策略控制的数据管道中时才有效。监控器应验证页面身份,保持代理和用户代理一致性,短暂使用清除Cookies,解析结构化可用性证据,并将基础设施故障与真实的库存变化区分开来。
通过CapSolver启动批准的工作流程,针对受控源进行测试,并在扩展前添加证据保留、速率限制和操作员审核。
常见问题
库存监控应首先使用浏览器吗?
不。优先使用商家Feed、市场API、卖家API和授权数据源。仅在允许的空白或买家端验证时使用授权浏览器。
哪个CapSolver任务处理Cloudflare挑战?
使用记录的AntiCloudflareTask,并提供精确的目标URL和静态或粘性代理。可选字段包括浏览器支持的Chrome用户代理和新的挑战HTML。
挑战页面可以视为缺货吗?
不可以。挑战页面、错误页面或缺失选择器是基础设施或解析器状态。记录UNKNOWN并将其单独路由,与库存转换区分开。
清除Cookies应存储吗?
仅在短期加密运行时存储中保留。不要将其放置在模型上下文、分析表、警报或长期日志中。
监控器可以自动购买重新上架的商品吗?
默认保持监控只读。预订、结账和购买需要单独批准的服务、新的价格验证、策略限制和明确的人工确认。
合规声明: 本博客提供的信息仅供参考。CapSolver 致力于遵守所有适用的法律和法规。严禁以非法、欺诈或滥用活动使用 CapSolver 网络,任何此类行为将受到调查。我们的验证码解决方案在确保 100% 合规的同时,帮助解决公共数据爬取过程中的验证码难题。我们鼓励负责任地使用我们的服务。如需更多信息,请访问我们的服务条款和隐私政策。
更多
Turnstile Solver API 检查清单:输入、令牌和验证
在将其添加到您的工作流程之前,通过其记录的输入、令牌响应、验证边界和受控测试用例来评估一个Turnstile求解器API。
Anh Tuan
16-Sep-2026
Cloudflare 挑战诊断:会话身份和验证
使用 AntiCloudflareTask 诊断 Cloudflare 验证流程,稳定代理和用户代理身份,新鲜 HTML,清除处理,验证和安全错误。
Ethan Collins
31-Aug-2026
如何解决 Cloudflare 验证 用于房产价格监控
通过官方数据集、可比的观测、Cloudflare挑战解决、证据和受控警报,构建可靠的房产价格监测。
Ethan Collins
28-Aug-2026
如何解决 Cloudflare 验证以进行电子商务库存监控
构建可靠的电商库存监控,使用以API为先的采购、Cloudflare挑战恢复、会话一致性、库存证据和安全警报。
Ethan Collins
27-Aug-2026
什么是无效的 Cloudflare 人机验证令牌:原因和解决方法
通过检查过期时间、网站密钥、操作、cdata、浏览器状态、服务器验证和有限的CapSolver重试次数来修复无效的Turnstile令牌。
Ethan Collins
11-Aug-2026
MCP 验证码破解器:Cloudflare Turnstile 集成指南
使用 CapSolver 构建一个策略限制的 MCP Cloudflare Turnstile 工作流,包含有限重试、脱敏日志、会话检查和结果验证。
Ethan Collins
22-Jul-2026